Por qué la IA inventa cosas y 4 hábitos de prompt que lo reducen
Qué son las alucinaciones de la IA, por qué un modelo suena seguro y se equivoca, y cuatro hábitos de prompt para copiar y pegar con un ejemplo de antes/después para tus propios documentos.
En esta página
- Por qué un modelo suena seguro cuando se equivoca
- Cuatro hábitos que reducen las respuestas inventadas
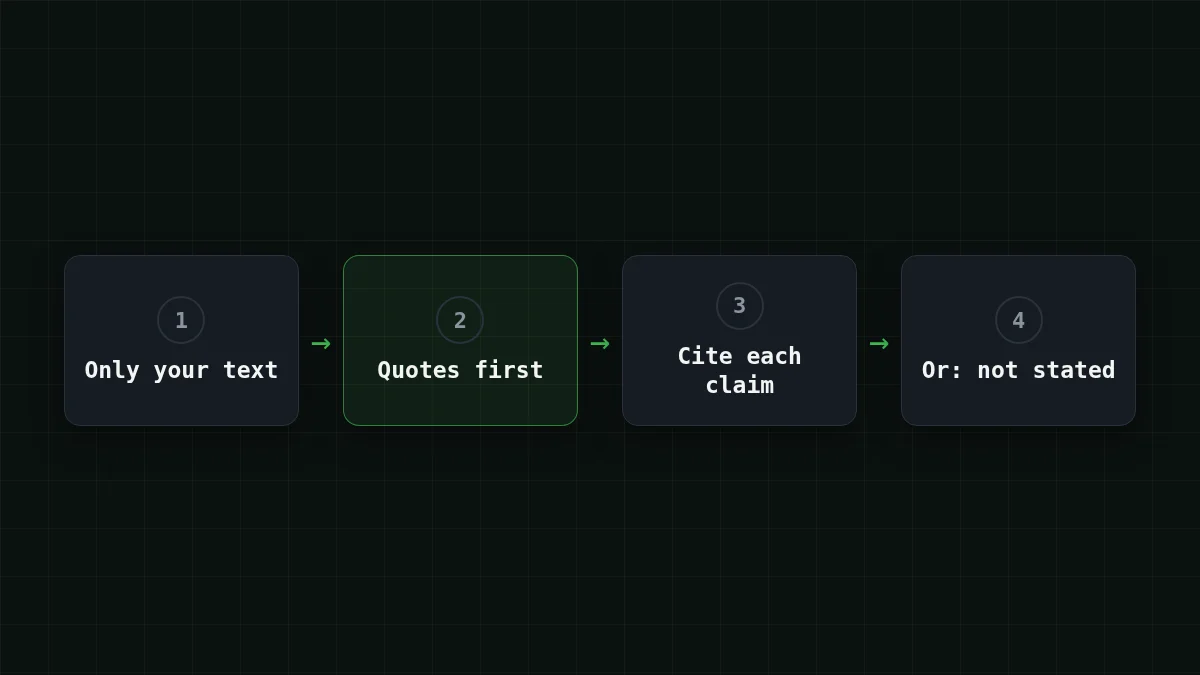
- 1. Permite "no lo sé"
- 2. Cita primero, responde después
- 3. Haz que cite, y descarta lo que no pueda respaldar
- 4. Restríngelo al texto que le diste
- Antes y después en un ejemplo
- Los cuatro hábitos en una sola solicitud a la API
- Cuánto cuesta citar
- Lo que estos hábitos no arreglan
Tu contrato de alquiler no tiene cláusula de penalización por mora. Le preguntas a un chatbot cuál es la penalización por mora, y a veces responde con un porcentaje y una fecha de vencimiento. Seguro, específico e inventado.
Eso es una alucinación: el modelo escribe texto fluido que es fácticamente incorrecto o que no coincide con el contexto que le diste. La documentación de Anthropic sobre cómo reducir las alucinaciones (página consultada el 27 de octubre de 2026; no lleva fecha de publicación) dice que incluso los modelos más avanzados hacen esto a veces, y enumera los hábitos que ayudan. Cuatro de ellos caben dentro de un prompt, y puedes pegarlos tal cual están abajo.
Por qué un modelo suena seguro cuando se equivoca#
Un modelo de lenguaje no busca hechos. Continúa texto: dado todo lo anterior, elige las palabras que con más probabilidad vienen después. Piensa en el autocompletado de tu teléfono, solo que mucho mejor leído. Cuando la respuesta verdadera es algo que el modelo aprendió, las palabras probables y las palabras verdaderas coinciden. Cuando no lo es, las palabras probables siguen siendo fluidas, y lo fluido suena a seguro.
Dos situaciones explican muchas de las respuestas inventadas que encontrarás:
- El hecho no está en el modelo. Ocurrió después de que terminara el entrenamiento del modelo, o está en tu documento privado que el modelo nunca ha visto. Pregunta sobre las noticias del mes pasado y puede que obtengas una respuesta segura construida a partir de patrones más antiguos.
- El hecho falta en tu documento, pero la pregunta asume que existe. El modelo rellena el hueco. Imagina a un estudiante que tiene que escribir algo para cada pregunta del examen y nunca puede dejar una en blanco.
Pruébalo tú mismoPruébalo: ¿qué hace un modelo con una pregunta que tu texto no puede responder?Mostrar respuesta
Pega un texto corto en un chat (un menú, una política, una receta) y pregunta por un detalle que claramente no contiene, como el precio de un plato que no aparece en la lista. Lee la respuesta. Algunas respuestas dicen que el texto no lo menciona. Otras inventan un detalle plausible. Cuál obtienes depende del modelo y de tu redacción, y los cuatro hábitos de abajo lo empujan hacia la primera.
Cuatro hábitos que reducen las respuestas inventadas#
Supón que pegaste un contrato de alquiler y quieres la penalización por mora. Este contrato no tiene cláusula de penalización por mora, y será nuestro caso de prueba de aquí en adelante.
1. Permite "no lo sé"#
Un modelo que cree que toda pregunta debe responderse la responderá. Dile que esa no es la regla:
If the document doesn't say, answer exactly: "Not stated in the document."
Do not guess.
Anthropic lo enumera como el primer y más simple paso: dar explícitamente permiso al modelo para admitir que no lo sabe.
2. Cita primero, responde después#
Para documentos largos (la guía de Anthropic traza la línea en unos 20.000 tokens, aproximadamente 15.000 palabras), pide citas literales antes de cualquier análisis, y haz que la respuesta se apoye en ellas:
First, copy the sentences relevant to my question, word for word,
under the heading "Quotes". If there are none, write "No relevant quotes."
Then answer using only those quotes.
El modelo tiene que señalar texto que realmente está ahí antes de concluir nada. Leer las citas también te lleva cinco segundos.
3. Haz que cite, y descarta lo que no pueda respaldar#
Pide una cita de apoyo después de cada afirmación, y luego haz que el modelo se revise a sí mismo:
After each claim, put the supporting quote in brackets.
Then re-read your answer: if a claim has no quote, delete it.
Este es el paso de verificación de Anthropic: sin cita, no hay afirmación.
4. Restríngelo al texto que le diste#
Use only the document between the <document> tags.
Do not use outside knowledge.
Anthropic incluye limitar el conocimiento externo a los documentos proporcionados entre sus técnicas avanzadas. También es el hábito que debes copiar si estás construyendo un bot sobre tus propios documentos: el bot responde a partir de tus páginas, no de memoria.
Antes y después en un ejemplo#
Mismo contrato, misma pregunta, dos prompts. El de la izquierda es como empieza la mayoría de nosotros.
Comparar
Misma pregunta, dos prompts
Antes
Here is my rental agreement:
[agreement text]

What is the late fee?
Un modelo que siente que debe responder puede darte un número.
Después
<document>
[agreement text]
</document>

Question: What is the late fee?

Use only the document above. First copy the relevant
sentences word for word under "Quotes" (or write
"No relevant quotes."). Then answer using only those
quotes, with the quote in brackets after each claim.
If the document doesn't say, answer exactly:
"Not stated in the document."
La respuesta que buscas aquí: "No hay citas relevantes." y luego "No indicado en el documento."
El prompt "después" es más largo, y eso está bien: lo escribes una vez y lo reutilizas.
Los cuatro hábitos en una sola solicitud a la API#
Si llamas a un modelo a través de la API, los hábitos van en el mensaje del sistema y tu documento va en el mensaje del usuario, envuelto en etiquetas. Esta solicitud usa el endpoint compatible con OpenAI de CheapTokens; la clave viene de una variable de entorno, y el id completo del modelo es MiniMaxAI/ (toma los ids de la documentación de CheapTokens, porque los nombres difieren entre proveedores).
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "MiniMaxAI/MiniMax-M2.7",
    "messages": [
      {"role": "system", "content": "Use only the document in the <document> tags. No outside knowledge. First list word-for-word quotes relevant to the question under “Quotes”, or write “No relevant quotes.” Then answer using only those quotes, with the quote in brackets after each claim. If the document does not say, answer: “Not stated in the document.”"},
      {"role": "user", "content": "<document>[paste the agreement here]</document> What is the late fee?"}
    ]
  }'
La respuesta está en choices[0].. Si esta es tu primera llamada, Tu primera solicitud a la API con CheapTokens recorre la clave y el paso del saldo paso a paso.
Cuánto cuesta citar#
Citar hace la respuesta más larga, y en la mayoría de los modelos la respuesta es el lado más caro de una solicitud (ver tokens de entrada vs salida). El hábito de citar primero, por lo tanto, es barato de costear pero no es gratis.
Digamos que un informe de 40 páginas tiene unos 25.000 tokens y las citas más la respuesta suman unos 1.500. Una solicitud así en MiniMax-M2.7 cuesta $0.0015. La tabla muestra la misma solicitud en cada modelo, con una columna de OpenRouter, para que puedas comparar en total, con entrada y salida contadas juntas:
| Modelo | Entrada $/1M | Salida $/1M | Costo | OpenRouter |
|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00056 | $0.00096 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00053 | $0.002 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0015 | $0.0177 |
25.000 tokens de entrada y 1500 tokens de salida en total. Los precios por 1M de tokens son actuales y cambian junto con nuestras tarifas; la columna de OpenRouter muestra precios de referencia para la misma carga de trabajo.
MiniMax-M2.7 admite un contexto de 180K y hasta 8.192 tokens en una respuesta a un precio fijo a cualquier hora, así que un informe de 25.000 tokens y una respuesta larga con citas caben ambos. Los precios actuales están en la página de precios, y los modelos se describen en la documentación.
Lo que estos hábitos no arreglan#
Reducen mucho las respuestas inventadas, pero no las eliminan. Anthropic lo dice directamente: verifica cualquier cosa importante. En un contrato eso significa los números, fechas y nombres, contra la página original.
Dos trucos más de la misma página vale la pena conocer. Best-of-N: haz la misma pregunta varias veces y compara, porque un detalle que cambia de una ejecución a otra es señal de que el modelo está adivinando. Una solicitud idéntica puede volver como una respuesta idéntica, así que cambia un poco la redacción o la temperatura (ver prompt del sistema y temperatura). Y un modo de pensamiento permite al modelo comprobar su propio razonamiento antes de responder, lo que cuesta tokens extra (por qué pensar cuesta más).
Lista de verificación
Antes de confiar en una respuesta construida sobre tus documentos


