AI 入门指南
为什么 AI 会编造内容,以及减少这种情况的 4 个提示词习惯
什么是 AI 幻觉,为什么模型听起来确定却是错的,以及四个可复制粘贴的提示词习惯,附有适用于你自己文档的前后对比示例。
本页内容
你的租赁协议里没有滞纳金条款。你问聊天机器人滞纳金是多少,它有时会给出一个百分比和到期日。自信、具体,却是编造的。
这就是幻觉:模型写出流畅的文字,但内容在事实上是错误的,或者与你提供的上下文不符。Anthropic 关于减少幻觉的文档(页面检查于 2026 年 10 月 27 日;未标注发布日期)指出,即使是最先进的模型有时也会这样,并列出了一些有帮助的习惯。其中四个可以放进提示词里,你可以直接按下面的样子粘贴使用。
为什么模型在出错时听起来很确定#
语言模型不会去查事实。它是在续写文本:给定目前为止的所有内容,它挑选最可能出现的下一个词。可以把它想象成手机上的自动补全,只是读过的内容多得多。当真实答案是模型学到过的东西时,最可能的词和真实的词会对上。当不是时,最可能的词依然流畅,而流畅听起来就像确定。
有两种情况可以解释你会遇到的许多编造答案:
- 事实不在模型里。 它发生在模型训练结束之后,或者它存在于模型从未见过的你的私有文档中。问上个月的新闻,你可能会得到一个基于旧模式构建的自信答案。
- 事实在你的文档中缺失,但问题假设它存在。 模型会填补空白。想象一个学生,每道考题都必须写点什么,从不允许留空。
自己试试试一试:模型会怎么处理你的文本无法回答的问题?显示答案
把一段短文本粘贴到聊天中(一份菜单、一项政策、一个食谱),然后问一个它明显不包含的细节,比如未列出的菜品的价格。读一读回复。有些答案会说文本没有提到它。另一些则会编造一个看似合理的细节。你得到哪一种取决于模型和你的措辞,而下面的四个习惯会把它推向第一种。
减少编造答案的四个习惯#
假设你粘贴了一份租赁协议,想知道滞纳金。这份协议没有滞纳金条款,这将是我们接下来的测试案例。
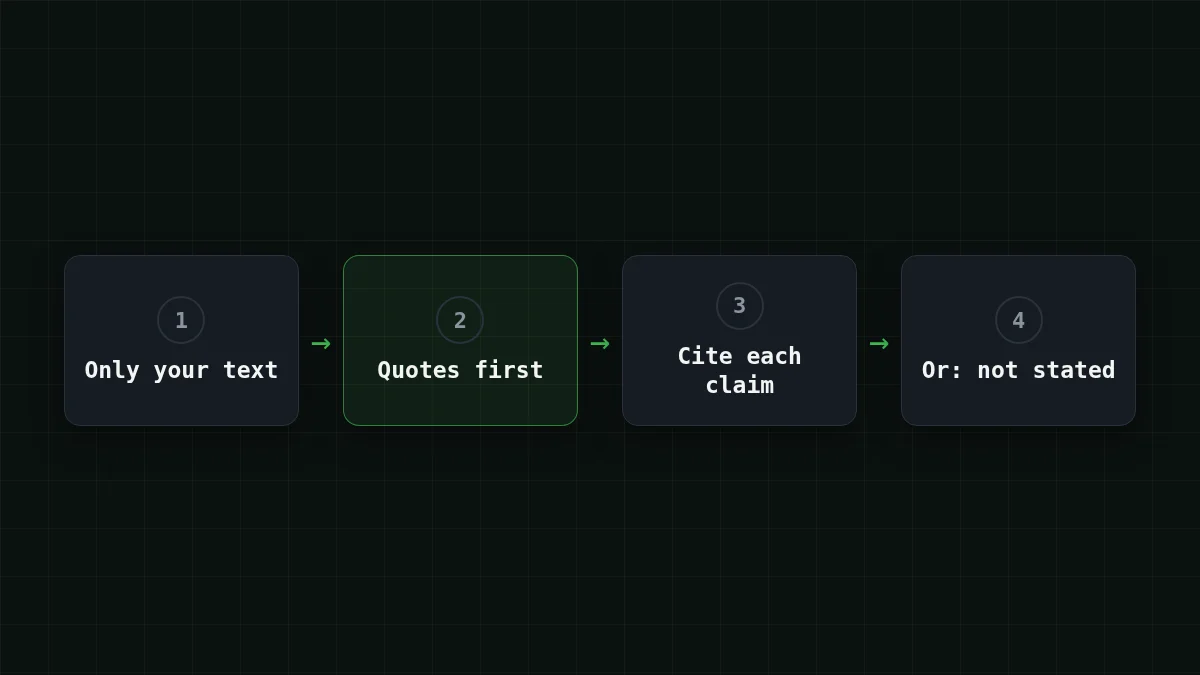
1. 允许“我不知道”#
一个认为每个问题都必须回答的模型就会去回答。告诉它规则不是这样:
If the document doesn't say, answer exactly: "Not stated in the document."
Do not guess.
Anthropic 把这列为第一步,也是最简单的一步:明确给模型承认自己不知道的许可。
2. 先引用,后回答#
对于长文档(Anthropic 的指南把界限划在约 20,000 个 token,大约 15,000 个词),要求在任何分析之前先给出逐字引用,并让答案建立在引用之上:
First, copy the sentences relevant to my question, word for word,
under the heading "Quotes". If there are none, write "No relevant quotes."
Then answer using only those quotes.
模型在得出结论之前必须指向确实存在的文本。读一遍引用也只需要你五秒钟。
3. 让它引用,并丢弃它无法支撑的内容#
要求在每个论断之后给出支撑引用,然后让模型自我检查:
After each claim, put the supporting quote in brackets.
Then re-read your answer: if a claim has no quote, delete it.
这是 Anthropic 的验证步骤:没有引用,就没有论断。
4. 把它限制在你给它的文本内#
Use only the document between the <document> tags.
Do not use outside knowledge.
Anthropic 把限制外部知识、只使用提供的文档列为其高级技术之一。如果你要基于自己的文档构建机器人,这也是应该照搬的习惯:机器人从你的页面回答,而不是从记忆中回答。
一个例子的前后对比#
同一份协议,同一个问题,两个提示词。左边那个是我们大多数人的起点。
比较
同一个问题,两个提示词
之前
Here is my rental agreement:
[agreement text]

What is the late fee?
一个觉得自己必须回答的模型可能会给你一个数字。
之后
<document>
[agreement text]
</document>

Question: What is the late fee?

Use only the document above. First copy the relevant
sentences word for word under "Quotes" (or write
"No relevant quotes."). Then answer using only those
quotes, with the quote in brackets after each claim.
If the document doesn't say, answer exactly:
"Not stated in the document."
你在这里想要得到的答案:“没有相关引用。”然后是“文档中未陈述。”
“之后”的提示词更长,这没关系:你写一次,然后重复使用。
四个习惯放进一个 API 请求#
如果你通过 API 调用模型,这些习惯放进系统消息,你的文档放进用户消息,并用标签包裹。这个请求使用 CheapTokens 的 OpenAI 兼容端点;密钥来自环境变量,完整的模型 id 是 MiniMaxAI/(从 CheapTokens 文档 获取 id,因为不同提供商的名称不同)。
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "MiniMaxAI/MiniMax-M2.7",
    "messages": [
      {"role": "system", "content": "Use only the document in the <document> tags. No outside knowledge. First list word-for-word quotes relevant to the question under “Quotes”, or write “No relevant quotes.” Then answer using only those quotes, with the quote in brackets after each claim. If the document does not say, answer: “Not stated in the document.”"},
      {"role": "user", "content": "<document>[paste the agreement here]</document> What is the late fee?"}
    ]
  }'
回复在 choices[0]. 中。如果这是你的第一次调用,你的第一个 CheapTokens API 请求 会一步步讲解密钥和余额。
引用的成本#
引用会让答案更长,而在大多数模型上,答案是一次请求中更贵的一侧(参见 输入与输出 token)。因此,先引用的习惯负担得起,但并非免费。
假设一份 40 页的报告大约 25,000 个 token,引用加上答案大约 1,500 个。在 MiniMax-M2.7 上,这样一次请求花费 $0.0015。表格展示了同样的请求在每个模型上的情况,并附有 OpenRouter 一列,这样你可以按总计比较,把输入和输出算在一起:
| 模型 | 输入 $/1M | 输出 $/1M | 费用 | OpenRouter |
|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00056 | $0.00096 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00053 | $0.002 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0015 | $0.0177 |
总计 25,000 个输入 token 和 1,500 个输出 token。每 100 万 token 的价格为当前价格,会随我们的资费一同变动;OpenRouter 列显示相同工作负载的参考价格。
MiniMax-M2.7 支持 180K 上下文,答案最多 8,192 个 token,任何时段都是固定价格,所以 25,000 token 的报告和很长的引用答案都能装下。当前价格在定价页面上,模型说明在文档中。
这些习惯解决不了什么#
它们能大幅减少编造答案,但不能消除。Anthropic 直接这么说:任何重要的内容都要核实。在合同中,这意味着把数字、日期和名称与原始页面核对。
同一页面上还有两个技巧值得了解。Best-of-N:把同一个问题问几次并比较,因为一个在多次运行之间变化的细节,说明模型在猜测。完全相同的请求可能返回完全相同的回复,所以稍微改变措辞或温度(参见 系统提示词与温度)。而思考模式让模型在回答前检查自己的推理,这会消耗额外的 token(为什么思考更贵)。
清单
在你信任基于自己文档构建的答案之前


