AI สำหรับผู้เริ่มต้นคู่มือ
ทำไม AI จึงกุเรื่องขึ้น และ 4 พฤติกรรมในพรอมต์ที่ลดมันได้
hallucination ของ AI คืออะไร ทำไมโมเดลจึงฟังดูมั่นใจและผิด และสี่พฤติกรรมในพรอมต์ที่คัดลอกวางได้พร้อมตัวอย่างก่อน/หลังสำหรับเอกสารของคุณเอง
ในหน้านี้
- ทำไมโมเดลจึงฟังดูมั่นใจเมื่อมันผิด
- สี่พฤติกรรมที่ลดคำตอบที่กุขึ้น
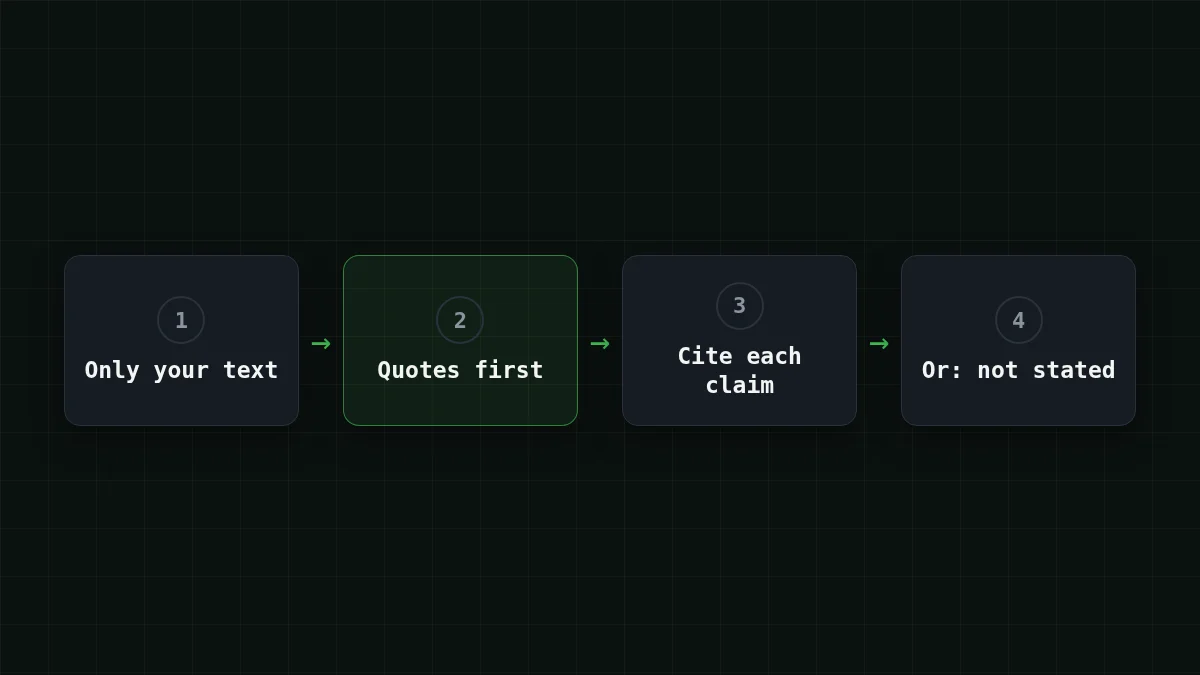
- 1. อนุญาตให้พูดว่า "ไม่รู้"
- 2. อ้างก่อน ตอบทีหลัง
- 3. ให้อ้างอิง และตัดสิ่งที่ไม่สามารถสนับสนุนได้
- 4. จำกัดให้อยู่เฉพาะข้อความที่คุณให้
- ก่อนและหลังในตัวอย่างเดียว
- ทั้งสี่พฤติกรรมในคำขอ API เดียว
- การอ้างอิงมีต้นทุนเท่าไร
- สิ่งที่พฤติกรรมเหล่านี้ไม่ได้แก้
สัญญาเช่าของคุณไม่มีข้อกำหนดเรื่องค่าปรับล่าช้า คุณถามแชทบอทว่าค่าปรับล่าช้าคือเท่าไร และบางครั้งมันตอบเป็นเปอร์เซ็นต์พร้อมวันครบกำหนด มั่นใจ เจาะจง และกุขึ้นมา
นั่นคือ hallucination: โมเดลเขียนข้อความที่ลื่นไหลแต่ผิดข้อเท็จจริงหรือไม่ตรงกับบริบทที่คุณให้ เอกสารของ Anthropic เกี่ยวกับการลด hallucination (ตรวจหน้าเมื่อ 27 ตุลาคม 2026; ไม่ระบุวันที่เผยแพร่) กล่าวว่าแม้แต่โมเดลที่ล้ำหน้าที่สุดก็ทำเช่นนี้บางครั้ง และได้ระบุพฤติกรรมที่ช่วยได้ สี่ข้อในนั้นใส่ไว้ในพรอมต์ได้ และคุณสามารถวางตามที่เป็นอยู่ด้านล่างได้เลย
ทำไมโมเดลจึงฟังดูมั่นใจเมื่อมันผิด#
โมเดลภาษาไม่ได้ค้นหาข้อเท็จจริง มันต่อข้อความ: จากทุกอย่างที่ผ่านมา มันเลือกคำที่มีแนวโน้มจะตามมามากที่สุด คิดถึง autocomplete บนโทรศัพท์ของคุณ แต่ผ่านการอ่านมามากกว่ามาก เมื่อคำตอบที่แท้จริงเป็นสิ่งที่โมเดลเรียนรู้มา คำที่มีแนวโน้มและคำที่แท้จริงก็ตรงกัน เมื่อไม่ใช่ คำที่มีแนวโน้มก็ยังลื่นไหล และความลื่นไหลฟังดูเหมือนความมั่นใจ
สองสถานการณ์อธิบายคำตอบที่กุขึ้นจำนวนมากที่คุณจะพบ:
- ข้อเท็จจริงไม่อยู่ในโมเดล มันเกิดขึ้นหลังการฝึกโมเดลสิ้นสุด หรืออยู่ในเอกสารส่วนตัวของคุณที่โมเดลไม่เคยเห็น ถามเกี่ยวกับข่าวเดือนที่แล้วคุณอาจได้คำตอบที่มั่นใจซึ่งสร้างจากรูปแบบเก่าๆ
- ข้อเท็จจริงขาดหายจากเอกสารของคุณ แต่คำถามสมมติว่ามีอยู่ โมเดลเติมช่องว่าง นึกภาพนักเรียนที่ต้องเขียนอะไรบางอย่างสำหรับทุกข้อสอบและไม่เคยได้รับอนุญาตให้เว้นว่าง
ลองด้วยตัวเองลองดู: โมเดลทำอะไรกับคำถามที่ข้อความของคุณตอบไม่ได้?แสดงคำตอบ
วางข้อความสั้นๆ ลงในแชท (เมนู นโยบาย สูตรอาหาร) แล้วถามเกี่ยวกับรายละเอียดที่มันไม่มีอย่างชัดเจน เช่น ราคาของเมนูที่ไม่ได้ระบุไว้ อ่านคำตอบ บางคำตอบบอกว่าข้อความไม่ได้กล่าวถึง บางคำตอบกุรายละเอียดที่สมเหตุสมผล คุณจะได้แบบไหนขึ้นอยู่กับโมเดลและถ้อยคำของคุณ และพฤติกรรมสี่ข้อด้านล่างผลักดันให้ไปทางแรก
สี่พฤติกรรมที่ลดคำตอบที่กุขึ้น#
สมมติว่าคุณวางสัญญาเช่าและต้องการทราบค่าปรับล่าช้า สัญญานี้ไม่มีข้อกำหนดเรื่องค่าปรับล่าช้า และจะเป็นกรณีทดสอบของเราต่อจากนี้
1. อนุญาตให้พูดว่า "ไม่รู้"#
โมเดลที่เชื่อว่าทุกคำถามต้องได้รับคำตอบจะตอบมัน บอกมันว่านั่นไม่ใช่กฎ:
If the document doesn't say, answer exactly: "Not stated in the document."
Do not guess.
Anthropic ระบุสิ่งนี้เป็นขั้นตอนแรกและง่ายที่สุด: ให้สิทธิ์โมเดลอย่างชัดเจนในการยอมรับว่าไม่รู้
2. อ้างก่อน ตอบทีหลัง#
สำหรับเอกสารยาว (แนวทางของ Anthropic ลากเส้นที่ประมาณ 20,000 โทเค็น หรือราว 15,000 คำ) ขอคำอ้างอิงแบบคำต่อคำก่อนการวิเคราะห์ใดๆ และให้คำตอบตั้งอยู่บนคำอ้างอิงเหล่านั้น:
First, copy the sentences relevant to my question, word for word,
under the heading "Quotes". If there are none, write "No relevant quotes."
Then answer using only those quotes.
โมเดลต้องชี้ไปที่ข้อความที่มีอยู่จริงก่อนจะสรุปอะไร อีกทั้งการอ่านคำอ้างอิงยังใช้เวลาคุณห้าวินาที
3. ให้อ้างอิง และตัดสิ่งที่ไม่สามารถสนับสนุนได้#
ขอคำอ้างอิงสนับสนุนหลังทุกข้อกล่าวอ้าง แล้วให้โมเดลตรวจสอบตัวเอง:
After each claim, put the supporting quote in brackets.
Then re-read your answer: if a claim has no quote, delete it.
นี่คือขั้นตอนการตรวจสอบของ Anthropic: ไม่มีคำอ้างอิง ไม่มีข้อกล่าวอ้าง
4. จำกัดให้อยู่เฉพาะข้อความที่คุณให้#
Use only the document between the <document> tags.
Do not use outside knowledge.
Anthropic ระบุการจำกัดความรู้ภายนอกให้อยู่เฉพาะเอกสารที่ให้ไว้ในเทคนิคขั้นสูงของตน และยังเป็นพฤติกรรมที่ควรคัดลอกหากคุณกำลังสร้างบอทบนเอกสารของคุณเอง: บอทตอบจากหน้าของคุณ ไม่ใช่จากความจำ
ก่อนและหลังในตัวอย่างเดียว#
สัญญาเดียวกัน คำถามเดียวกัน สองพรอมต์ อันซ้ายคือวิธีที่พวกเราเริ่มกันส่วนใหญ่
เปรียบเทียบ
คำถามเดียวกัน สองพรอมต์
ก่อน
Here is my rental agreement:
[agreement text]

What is the late fee?
โมเดลที่รู้สึกว่าต้องตอบอาจให้ตัวเลขคุณ
หลัง
<document>
[agreement text]
</document>

Question: What is the late fee?

Use only the document above. First copy the relevant
sentences word for word under "Quotes" (or write
"No relevant quotes."). Then answer using only those
quotes, with the quote in brackets after each claim.
If the document doesn't say, answer exactly:
"Not stated in the document."
คำตอบที่คุณต้องการในที่นี้: "ไม่มีคำอ้างอิงที่เกี่ยวข้อง" แล้วก็ "ไม่ได้ระบุในเอกสาร"
พรอมต์ "หลัง" ยาวกว่า และนั่นก็โอเค: คุณเขียนครั้งเดียวแล้วใช้ซ้ำ
ทั้งสี่พฤติกรรมในคำขอ API เดียว#
หากคุณเรียกโมเดลผ่าน API พฤติกรรมเหล่านี้จะอยู่ใน system message และเอกสารของคุณอยู่ใน user message ห่อด้วยแท็ก คำขอนี้ใช้ endpoint ที่เข้ากันได้กับ OpenAI ของ CheapTokens; คีย์มาจากตัวแปรสภาพแวดล้อม และ model id เต็มคือ MiniMaxAI/ (เอา id จาก เอกสาร CheapTokens เพราะชื่อแตกต่างกันระหว่างผู้ให้บริการ)
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "MiniMaxAI/MiniMax-M2.7",
    "messages": [
      {"role": "system", "content": "Use only the document in the <document> tags. No outside knowledge. First list word-for-word quotes relevant to the question under “Quotes”, or write “No relevant quotes.” Then answer using only those quotes, with the quote in brackets after each claim. If the document does not say, answer: “Not stated in the document.”"},
      {"role": "user", "content": "<document>[paste the agreement here]</document> What is the late fee?"}
    ]
  }'
คำตอบอยู่ใน choices[0]. หากนี่เป็นการเรียกครั้งแรกของคุณ คำขอ API ครั้งแรกของคุณกับ CheapTokens อธิบายคีย์และขั้นตอนการเติมยอดทีละขั้น
การอ้างอิงมีต้นทุนเท่าไร#
การอ้างอิงทำให้คำตอบยาวขึ้น และในโมเดลส่วนใหญ่คำตอบคือฝั่งที่มีราคาแพงกว่าของคำขอ (ดู โทเค็นอินพุตเทียบเอาต์พุต) พฤติกรรมอ้างก่อนจึงมีต้นทุนต่ำแต่ไม่ฟรี
สมมติรายงาน 40 หน้าประมาณ 25,000 โทเค็น และคำอ้างอิงบวกคำตอบรวมประมาณ 1,500 คำขอแบบนี้หนึ่งครั้งบน MiniMax-M2.7 ราคา $0.0015 ตารางแสดงคำขอเดียวกันบนทุกโมเดล พร้อมคอลัมน์ OpenRouter เพื่อให้คุณเปรียบเทียบแบบรวม โดยนับอินพุตและเอาต์พุตรวมกัน:
| โมเดล | Input $/1M | Output $/1M | ค่าใช้จ่าย | OpenRouter |
|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00056 | $0.00096 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00053 | $0.002 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0015 | $0.0177 |
25,000 โทเค็นอินพุตและ 1,500 โทเค็นเอาต์พุตรวมทั้งหมด ราคาต่อ 1M โทเค็นเป็นราคาปัจจุบันและเปลี่ยนแปลงไปพร้อมกับอัตราค่าบริการของเรา คอลัมน์ OpenRouter แสดงราคาอ้างอิงสำหรับปริมาณงานเดียวกัน
MiniMax-M2.7 รองรับบริบท 180K และคำตอบสูงสุด 8,192 โทเค็นในราคาคงที่เดียวทุกชั่วโมง ดังนั้นรายงาน 25,000 โทเค็นและคำตอบอ้างอิงยาวๆ จึงพอดี ราคาปัจจุบันอยู่ที่ หน้าราคา และโมเดลอธิบายไว้ใน เอกสาร
สิ่งที่พฤติกรรมเหล่านี้ไม่ได้แก้#
มันลดคำตอบที่กุขึ้นได้มาก แต่ไม่ได้กำจัดออกไป Anthropic กล่าวไว้ตรงๆ: ตรวจสอบทุกอย่างที่สำคัญ ในสัญญา นั่นหมายถึงตัวเลข วันที่ และชื่อ เทียบกับหน้าต้นฉบับ
มีเทคนิคอีกสองอย่างจากหน้าเดียวกันที่ควรรู้ Best-of-N: ถามคำถามเดิมหลายครั้งแล้วเปรียบเทียบ เพราะรายละเอียดที่เปลี่ยนไปในแต่ละครั้งเป็นสัญญาณว่าโมเดลกำลังเดา คำขอที่เหมือนกันอาจได้คำตอบที่เหมือนกัน ดังนั้นเปลี่ยนถ้อยคำเล็กน้อยหรือ temperature (ดู system prompt และ temperature) และโหมดคิดช่วยให้โมเดลตรวจสอบเหตุผลของตัวเองก่อนตอบ ซึ่งมีค่าใช้จ่ายโทเค็นเพิ่ม (ทำไมการคิดจึงมีค่าใช้จ่ายมากกว่า)
เช็กลิสต์
ก่อนที่คุณจะเชื่อคำตอบที่สร้างจากเอกสารของคุณ


