Por que a IA inventa coisas e 4 hábitos de prompt que reduzem isso
O que são alucinações de IA, por que um modelo soa seguro e está errado, e quatro hábitos de prompt para copiar e colar com um exemplo de antes/depois para seus próprios documentos.
Nesta página
- Por que um modelo soa seguro quando está errado
- Quatro hábitos que reduzem respostas inventadas
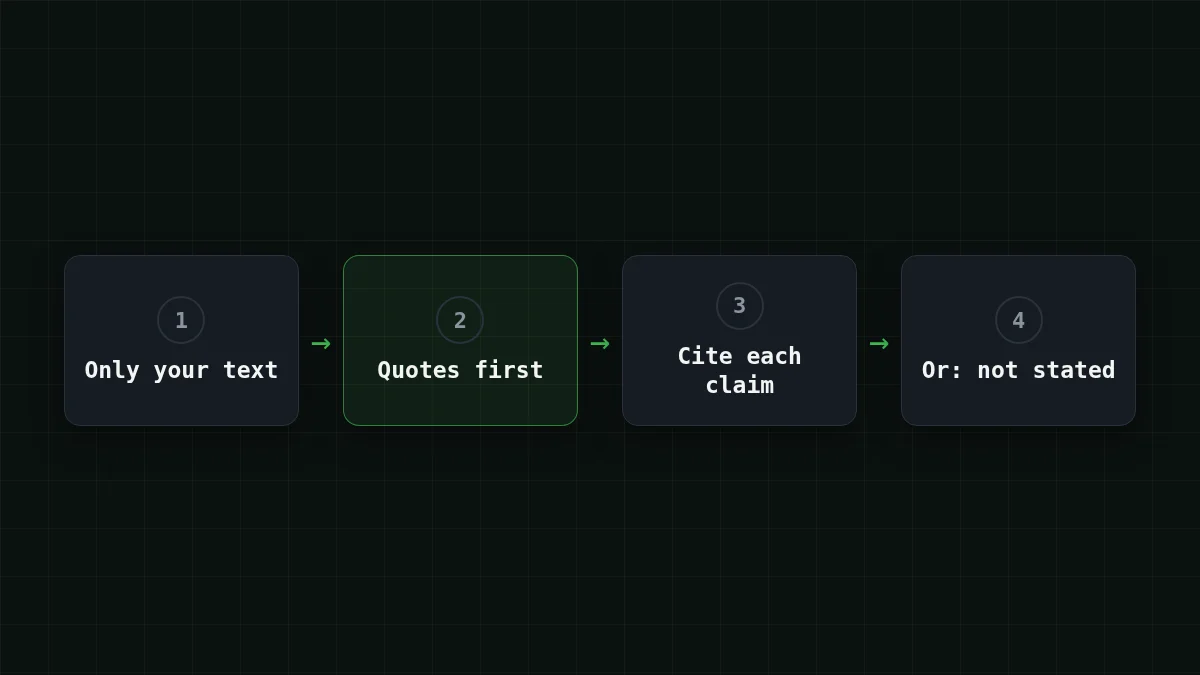
- 1. Permita "não sei"
- 2. Cite primeiro, responda depois
- 3. Faça-o citar, e descarte o que ele não consegue comprovar
- 4. Restrinja-o ao texto que você forneceu
- Antes e depois em um exemplo
- Todos os quatro hábitos em uma única requisição de API
- Quanto custa citar
- O que esses hábitos não corrigem
Seu contrato de aluguel não tem cláusula de multa por atraso. Você pergunta a um chatbot qual é a multa por atraso, e às vezes ele responde com uma porcentagem e uma data de vencimento. Confiante, específico e inventado.
Isso é uma alucinação: o modelo escreve um texto fluente que está factualmente errado ou não corresponde ao contexto que você forneceu. A documentação da Anthropic sobre redução de alucinações (página verificada em 27 de outubro de 2026; não traz data de publicação) diz que até os modelos mais avançados fazem isso às vezes, e lista os hábitos que ajudam. Quatro deles cabem dentro de um prompt, e você pode colá-los como estão abaixo.
Por que um modelo soa seguro quando está errado#
Um modelo de linguagem não consulta fatos. Ele continua texto: dado tudo até agora, ele escolhe as palavras que provavelmente vêm a seguir. Pense no autocomplete do seu celular, só que muito mais lido. Quando a resposta verdadeira é algo que o modelo aprendeu, as palavras prováveis e as palavras verdadeiras coincidem. Quando não é, as palavras prováveis continuam fluentes, e fluente soa como seguro.
Duas situações explicam muitas das respostas inventadas que você vai encontrar:
- O fato não está no modelo. Aconteceu depois que o treinamento do modelo terminou, ou está no seu documento privado que o modelo nunca viu. Pergunte sobre as notícias do mês passado e você pode receber uma resposta confiante construída a partir de padrões mais antigos.
- O fato está faltando no seu documento, mas a pergunta assume que ele existe. O modelo preenche a lacuna. Imagine um aluno que precisa escrever algo para cada questão da prova e nunca pode deixar uma em branco.
Experimente você mesmoExperimente: o que um modelo faz com uma pergunta que seu texto não consegue responder?Mostrar resposta
Cole um texto curto em um chat (um menu, uma política, uma receita) e pergunte sobre um detalhe que claramente não está nele, como o preço de um prato que não está listado. Leia a resposta. Algumas respostas dizem que o texto não menciona isso. Outras inventam um detalhe plausível. Qual você recebe depende do modelo e da sua formulação, e os quatro hábitos abaixo empurram para a primeira.
Quatro hábitos que reduzem respostas inventadas#
Digamos que você colou um contrato de aluguel e quer a multa por atraso. Este contrato não tem cláusula de multa por atraso, e será nosso caso de teste daqui em diante.
1. Permita "não sei"#
Um modelo que acredita que toda pergunta deve ser respondida vai respondê-la. Diga a ele que essa não é a regra:
If the document doesn't say, answer exactly: "Not stated in the document."
Do not guess.
A Anthropic lista isso como o primeiro e mais simples passo: dar explicitamente ao modelo permissão para admitir que não sabe.
2. Cite primeiro, responda depois#
Para documentos longos (a orientação da Anthropic traça a linha em cerca de 20.000 tokens, aproximadamente 15.000 palavras), peça citações palavra por palavra antes de qualquer análise, e faça a resposta se apoiar nelas:
First, copy the sentences relevant to my question, word for word,
under the heading "Quotes". If there are none, write "No relevant quotes."
Then answer using only those quotes.
O modelo tem que apontar para texto que realmente está lá antes de concluir qualquer coisa. Ler as citações também leva cinco segundos.
3. Faça-o citar, e descarte o que ele não consegue comprovar#
Peça uma citação de apoio após cada afirmação, depois faça o modelo se verificar:
After each claim, put the supporting quote in brackets.
Then re-read your answer: if a claim has no quote, delete it.
Este é o passo de verificação da Anthropic: sem citação, sem afirmação.
4. Restrinja-o ao texto que você forneceu#
Use only the document between the <document> tags.
Do not use outside knowledge.
A Anthropic lista limitar o conhecimento externo aos documentos fornecidos entre suas técnicas avançadas. É também o hábito a copiar se você está construindo um bot sobre seus próprios documentos: o bot responde a partir das suas páginas, não da memória.
Antes e depois em um exemplo#
Mesmo contrato, mesma pergunta, dois prompts. O da esquerda é como a maioria de nós começa.
Comparar
Mesma pergunta, dois prompts
Antes
Here is my rental agreement:
[agreement text]

What is the late fee?
Um modelo que sente que precisa responder pode lhe dar um número.
Depois
<document>
[agreement text]
</document>

Question: What is the late fee?

Use only the document above. First copy the relevant
sentences word for word under "Quotes" (or write
"No relevant quotes."). Then answer using only those
quotes, with the quote in brackets after each claim.
If the document doesn't say, answer exactly:
"Not stated in the document."
A resposta que você busca aqui: "Nenhuma citação relevante." e depois "Não declarado no documento."
O prompt "depois" é mais longo, e tudo bem: você o escreve uma vez e o reutiliza.
Todos os quatro hábitos em uma única requisição de API#
Se você chama um modelo pela API, os hábitos vão na mensagem de sistema e seu documento vai na mensagem de usuário, envolto em tags. Esta requisição usa o endpoint compatível com OpenAI da CheapTokens; a chave vem de uma variável de ambiente, e o id completo do modelo é MiniMaxAI/ (pegue os ids na documentação da CheapTokens, porque os nomes diferem entre provedores).
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "MiniMaxAI/MiniMax-M2.7",
    "messages": [
      {"role": "system", "content": "Use only the document in the <document> tags. No outside knowledge. First list word-for-word quotes relevant to the question under “Quotes”, or write “No relevant quotes.” Then answer using only those quotes, with the quote in brackets after each claim. If the document does not say, answer: “Not stated in the document.”"},
      {"role": "user", "content": "<document>[paste the agreement here]</document> What is the late fee?"}
    ]
  }'
A resposta está em choices[0].. Se esta é sua primeira chamada, Sua primeira requisição de API com a CheapTokens explica a chave e o passo de saldo passo a passo.
Quanto custa citar#
Citar torna a resposta mais longa, e na maioria dos modelos a resposta é o lado mais caro de uma requisição (veja tokens de entrada vs saída). O hábito de citar primeiro, portanto, é barato de bancar, mas não é gratuito.
Digamos que um relatório de 40 páginas tenha cerca de 25.000 tokens e as citações mais a resposta cheguem a cerca de 1.500. Uma requisição dessas no MiniMax-M2.7 custa $0.0015. A tabela mostra a mesma requisição em todos os modelos, com uma coluna OpenRouter, para você comparar no total, com entrada e saída contadas juntas:
| Modelo | Entrada $/1M | Saída $/1M | Custo | OpenRouter |
|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00056 | $0.00096 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00053 | $0.002 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0015 | $0.0177 |
25.000 tokens de entrada e 1.500 tokens de saída no total. Os preços por 1M de tokens são atuais e mudam junto com nossas tarifas; a coluna OpenRouter mostra preços de referência para a mesma carga de trabalho.
O MiniMax-M2.7 aceita um contexto de 180K e até 8.192 tokens em uma resposta a um preço fixo a qualquer hora, então um relatório de 25.000 tokens e uma resposta longa citada cabem. Os preços atuais estão na página de preços, e os modelos são descritos na documentação.
O que esses hábitos não corrigem#
Eles reduzem muito as respostas inventadas, mas não as eliminam. A Anthropic diz isso diretamente: verifique qualquer coisa importante. Em um contrato, isso significa os números, datas e nomes, contra a página original.
Dois outros truques da mesma página valem a pena conhecer. Best-of-N: faça a mesma pergunta algumas vezes e compare, porque um detalhe que muda de uma execução para outra é sinal de que o modelo está adivinhando. Uma requisição idêntica pode voltar como uma resposta idêntica, então mude um pouco a formulação ou a temperatura (veja prompt de sistema e temperatura). E um modo de raciocínio permite que o modelo verifique seu próprio raciocínio antes de responder, o que custa tokens extras (por que o raciocínio custa mais).
Lista de verificação
Antes de confiar em uma resposta construída sobre seus documentos


