AI для новичковИнструкция
Few-shot prompting: 3–5 примеров в промпте, чтобы модель держала формат
Как 3–5 примеров в промпте заставляют модель отвечать вашими метками или JSON: запрос на Python и расчёт лишних входных токенов.
Содержание
Ваш бот для тикетов должен отвечать одним словом: billing, bug или other. Почти всегда так и выходит. А потом приходит «Label: billing — клиент, похоже, расстроен из-за возврата», и код, который читает метку, спотыкается.
Обычно помогает не более длинная инструкция, а несколько примеров: положите в промпт 3–5 готовых тикетов с метками, и модель повторит образец. Это и есть few-shot prompting. В руководстве Anthropic по промптам (раздел «Use examples effectively», на 3 ноября 2026) примеры названы одним из самых надёжных способов задать формат, тон и структуру ответа, а рекомендуемое число — 3–5. Подвох в том, что каждый пример — это входные токены, и вы платите за них заново в каждом запросе. В разделе про расходы посчитаем это для бота, который разбирает 2 000 тикетов в день.
Что такое «few-shot»#
Представьте нового сотрудника на первой неделе в поддержке. Вы говорите: «Помечай тикеты как billing, bug или other» — и уходите. Что-то он пометит так, как вы задумали, что-то нет. А теперь оставьте ему три тикета, которые уже помечены, и скажите: «Вот так». Тот же сотрудник, а сюрпризов куда меньше.
С моделями то же самое. Только инструкция — это zero-shot. Инструкция плюс несколько разобранных примеров — few-shot (на странице Anthropic встречается ещё слово multishot). «Shot» здесь просто пример.
Сравнение
Одна задача, два промпта
Только инструкция
Label the support ticket as billing, bug or other.Инструкция и примеры
Label the support ticket with one word: billing, bug or other.

Ticket: I was charged twice for one top-up.
Label: billing

Ticket: The export button does nothing.
Label: bug

Ticket: Do you have a dark theme?
Label: other
Во втором промпте нигде не объяснено, что такое billing. Это показывают сами примеры, и вместе со смыслом они передают формат. Одну явную строку инструкции всё равно лучше оставить, поэтому в версии ниже она есть.
Три правила хороших примеров#
На странице Anthropic хорошие примеры сводятся к трём словам:
- Relevant (близкие к делу): похожи на тикеты, которые приходят на самом деле, а не на чужую задачу.
- Diverse (разнообразные): покрывают крайние случаи и не похожи друг на друга, чтобы модель не уцепилась за случайную закономерность.
- Structured (оформленные): обёрнуты в теги (
<example>, а несколько штук — внутри<examples>), чтобы модель отличала примеры от инструкций. Там же сказано держать названия тегов одинаковыми.
Вот полный промпт, собранный по этим правилам. Сохраните его как prompt.txt:
<instructions>
Label the support ticket with exactly one word: billing, bug or other.
Reply with the label only.
</instructions>

<examples>
<example>
<ticket>I was charged twice for the same top-up.</ticket>
<label>billing</label>
</example>
<example>
<ticket>The export button does nothing when I click it.</ticket>
<label>bug</label>
</example>
<example>
<ticket>Do you have a dark theme?</ticket>
<label>other</label>
</example>
<example>
<ticket>Please refund me. Also, the page crashes on login.</ticket>
<label>billing</label>
</example>
<example>
<ticket>Is there an API for exporting reports?</ticket>
<label>other</label>
</example>
</examples>
Обратите внимание на четвёртый пример: просьба о возврате, где заодно упомянут сбой. Инструкция не решит спор в смешанном тикете, а пример решит. Здесь деньги важнее, поэтому метка billing. Какое бы правило вы ни выбрали, покажите его один раз.
Найдите пары
Какое правило нарушено?
Нажмите на элемент слева, затем на его пару
- Ваши примеры — однострочные приветствия из чата, а настоящие тикеты — длинные письмаНе relevant: примеры должны быть близки к реальной задаче
- У всех ваших примеров одна и та же меткаНе diverse: модель может поймать случайную закономерность
- Примеры вставлены обычным текстом между инструкциямиНе structured: оберните их в теги, чтобы их не приняли за инструкции
Отправьте промпт через API#
Промпт одинаков в каждом запросе, меняется только новый тикет. Путь каждого тикета короткий:
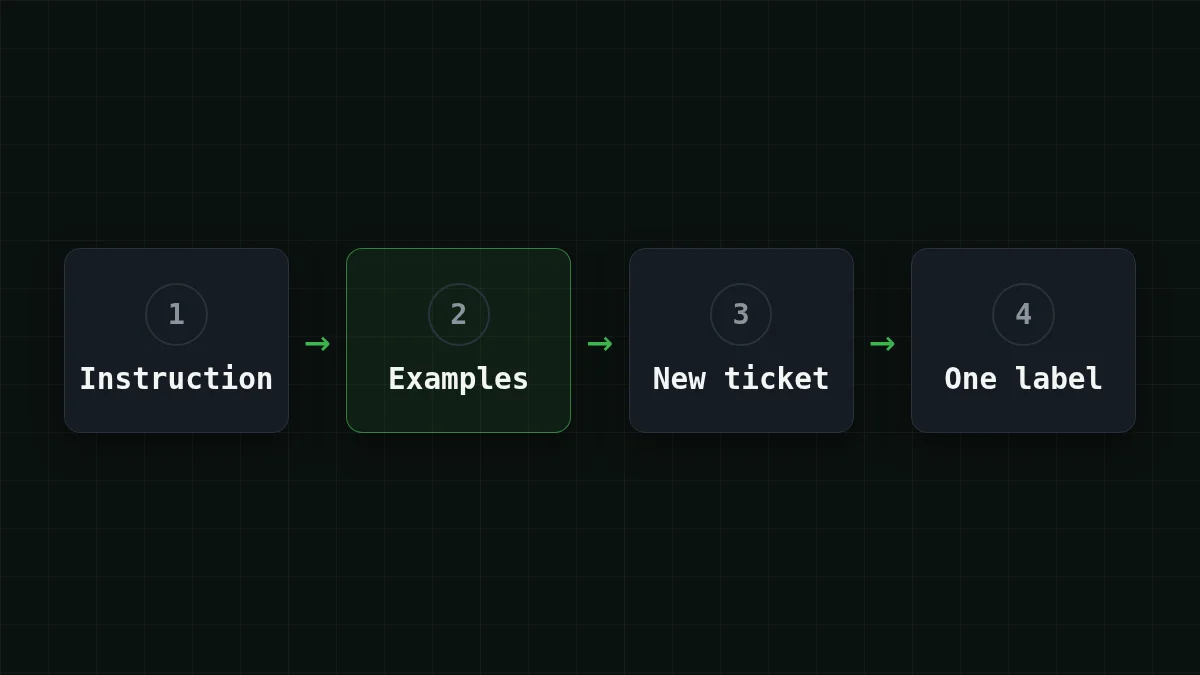
Вот это на Python с пакетом openai. Адрес — API CheapTokens, ключ лежит в переменной окружения (как хранить ключ безопасно, написано в отдельной статье), а id модели — полный, из документации:
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)

PROMPT = open("prompt.txt", encoding="utf-8").read()


def label(ticket: str) -> str:
    response = client.chat.completions.create(
        model="deepseek-ai/DeepSeek-V4-Flash-0731",
        max_tokens=64,
        messages=[
            {"role": "system", "content": PROMPT},
            {"role": "user", "content": f"<ticket>{ticket}</ticket>"},
        ],
    )
    print(response.usage.prompt_tokens, response.usage.completion_tokens)
    return response.choices[0].message.content.strip()


print(label("The app shows a blank screen after the update."))
Если всё работает, вы увидите в одной строке два числа токенов, а затем саму метку — одно слово, например bug. Если вместо этого пришло предложение, примеры пока не справляются: проверьте теги и то, что каждая метка из вашей схемы встречается хотя бы раз.
Смотрите на первое число. Это весь промпт: инструкция, примеры и тикет, и оно растёт с каждым добавленным примером. Запустите скрипт один раз с полным prompt.txt, а второй — только с блоком <instructions>: разница между первыми числами и есть цена ваших примеров на один запрос.
Для такой массовой разметки подходит DeepSeek-V4-Flash: одна цена в любое время суток, контекст 380K токенов (длинный блок примеров поместится легко) и до 32 768 токенов в ответе. Для коротких задач разметки годится и GLM-5.3-Flash с контекстом 390K. Обе модели — на странице моделей, с одним балансом.
Сколько пять примеров добавляют к счёту#
Допустим, бот разбирает 2 000 тикетов в день. Пусть тикет занимает около 120 токенов, а инструкция — около 80, тогда запрос без примеров — это 80 + 120 = 200 входных токенов. Пять примеров по 60 токенов добавляют 5 × 60 = 300, и запрос с ними — 200 + 300 = 500. Ответ — одно слово, пусть это 3 выходных токена в обоих случаях. Это допущения: подставьте prompt_tokens, которые напечатал ваш скрипт.
За день 200 × 2 000 = 400 000 входных токенов превращаются в 500 × 2 000 = 1 000 000, а выход остаётся 3 × 2 000 = 6 000 токенов. На DeepSeek-V4-Flash это $0.0066 в день без примеров и $0.0156 с ними. Примеры стоят вам разницу между этими двумя числами, а взамен, по словам Anthropic, дают более ровные ответы.
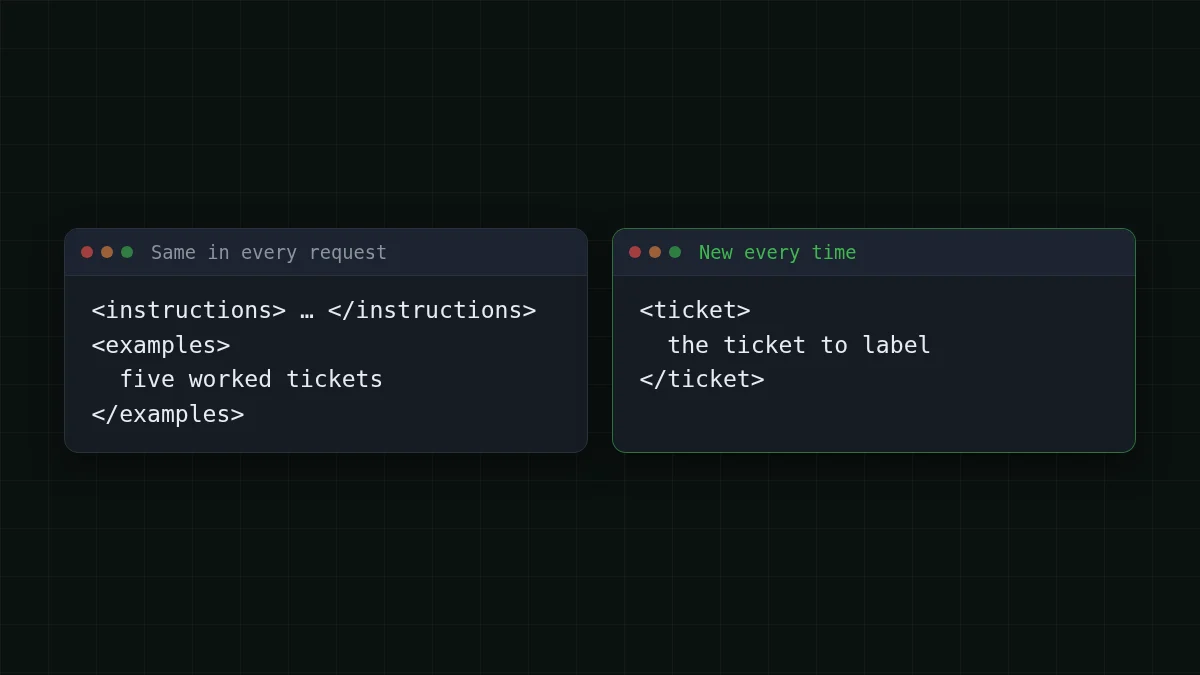
На этой картинке спрятана полезная деталь. Блок примеров одинаков в каждом запросе — это ровно тот случай, ради которого придумано кеширование промпта; как оно работает, объясняет статья что такое prompt caching.
А вот та же нагрузка — 500 входных и 3 выходных токена на запрос, 2 000 запросов — на разных моделях. Таблица пересчитывается по текущим ценам:
| Модель | Вход $/1M | Выход $/1M | За запрос | 2 000 запросов | OpenRouter, 2 000 запросов |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00001 | $0.0202 | $0.034 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0000078 | $0.0156 | $0.0708 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000025 | $0.0509 | $0.611 |
500 входных и 3 выходных токенов на запрос. Цены за 1M токенов актуальны и меняются вместе с нашими тарифами; столбец OpenRouter показывает справочные цены для той же нагрузки.
Если считать вход и выход вместе, DeepSeek-V4-Flash и GLM-5.3-Flash при такой нагрузке выходят дешевле OpenRouter. Полный прайс — на странице цен.
JSON, тон и проверка примеров#
Тот же приём закрывает ещё два случая. Нужны одни и те же поля JSON каждый раз? Сделайте ответом в примере сам JSON:
<example>
<ticket>I was charged twice for the same top-up.</ticket>
<output>{"label": "billing", "urgent": true}</output>
</example>
Про response_format и про то, что делать, если ответ всё равно невалиден, читайте в статье как получить валидный JSON от LLM API. Хотите переписать текст в одном тоне? «Дружелюбно, но коротко» — размытые слова; две пары «было → стало» объясняют лучше.
Прежде чем доверять набору примеров, возьмите 20 тикетов, которые вы уже разметили вручную, прогоните их и сверьте метки. Один такой проход скажет больше любого правила. Anthropic на своей странице советует и короткий путь: попросить модель оценить ваши примеры на релевантность и разнообразие или написать ещё несколько по образцу.
Чек-лист
Прежде чем доверять примерам
Когда примеры заработают, возникнет следующий вопрос: как не дать нескольким документам слиться в одном промпте. Об этом — как подписать каждый документ в промпте.


