AI dla początkującychPrzewodnik
Few-shot prompting: pokaż modelowi 3–5 przykładów, by dostać swój format
Jak 3–5 przykładów w tagach sprawia, że model odpowiada twoimi etykietami lub JSON-em, z żądaniem w Pythonie i dodatkowym kosztem wejścia na żądanie.
Na tej stronie
Twój bot do zgłoszeń powinien odpowiadać jednym słowem: billing, bug lub other. Większość odpowiedzi to dokładnie to. Potem przychodzi „Label: billing — the customer seems upset about a refund”, a kod, który czyta etykietę, się dławi.
Zwykłe rozwiązanie to nie dłuższa instrukcja. To kilka przykładów: wstaw 3–5 gotowych zgłoszeń z ich etykietami do promptu, a model skopiuje wzorzec. To jest few-shot prompting. Przewodnik po promptach Anthropic (sekcja „Use examples effectively”, sprawdzony 3 listopada 2026) nazywa przykłady jednym z najbardziej niezawodnych sposobów sterowania formatem, tonem i strukturą i zaleca 3–5 z nich. Haczyk: każdy przykład to dane wejściowe, za które płacisz ponownie przy każdym żądaniu. Sekcja kosztów poniżej liczy to dla bota, który obsługuje 2 000 zgłoszeń dziennie.
Co znaczy „few-shot”#
Wyobraź sobie nowego kolegę w pierwszym dniu przy stanowisku wsparcia. Mówisz „oznacz każde zgłoszenie jako billing, bug lub other” i odchodzisz. Część oznaczeń będzie zgodna z twoim wyobrażeniem, część nie. Teraz zostaw trzy zgłoszenia już oznaczone i powiedz „jak te”. Ten sam kolega, znacznie mniej niespodzianek.
Modele zachowują się tak samo. Sama instrukcja to zero-shot. Instrukcja plus kilka rozwiązanych przykładów to few-shot (strona Anthropic mówi też multishot). „Shot” to po prostu przykład.
Porównaj
To samo zadanie, dwa prompty
Tylko instrukcja
Label the support ticket as billing, bug or other.Instrukcja plus przykłady
Label the support ticket with one word: billing, bug or other.

Ticket: I was charged twice for one top-up.
Label: billing

Ticket: The export button does nothing.
Label: bug

Ticket: Do you have a dark theme?
Label: other
Drugi prompt nigdy nie wyjaśnia, co znaczy billing. Przykłady robią to przez pokazanie i niosą format razem ze znaczeniem. Jedna wyraźna linia instrukcji wciąż nie zaszkodzi, więc wersja poniżej ją zachowuje.
Trzy zasady działających przykładów#
Strona Anthropic sprowadza dobre przykłady do trzech słów:
- Trafne: bliskie zgłoszeniom, które naprawdę dostajesz, a nie jakiemuś innemu zadaniu.
- Różnorodne: obejmują przypadki brzegowe i różnią się od siebie, żeby model nie przyczepił się do przypadkowego wzorca.
- Ustrukturyzowane: opakowane w tagi (
<example>, i kilka wewnątrz<examples>), żeby model odróżnił przykłady od instrukcji. Ta sama strona mówi, by zachować spójne nazwy tagów.
Oto pełny prompt zbudowany w ten sposób. Zapisz go jako prompt.txt:
<instructions>
Label the support ticket with exactly one word: billing, bug or other.
Reply with the label only.
</instructions>

<examples>
<example>
<ticket>I was charged twice for the same top-up.</ticket>
<label>billing</label>
</example>
<example>
<ticket>The export button does nothing when I click it.</ticket>
<label>bug</label>
</example>
<example>
<ticket>Do you have a dark theme?</ticket>
<label>other</label>
</example>
<example>
<ticket>Please refund me. Also, the page crashes on login.</ticket>
<label>billing</label>
</example>
<example>
<ticket>Is there an API for exporting reports?</ticket>
<label>other</label>
</example>
</examples>
Spójrz na czwarty przykład: prośba o zwrot, która wspomina też o awarii. Instrukcja nie rozstrzygnie mieszanego zgłoszenia, przykład może. Tutaj wygrywają pieniądze, więc etykieta to billing. Jakąkolwiek zasadę wybierzesz, pokaż ją raz.
Dopasuj pary
Która zasada jest złamana?
Dotknij element po lewej, a następnie jego parę
- Twoje przykłady to jednolinijkowe powitania z czatu, ale prawdziwe zgłoszenia to długie e-maileNietrafne: przykłady muszą być bliskie prawdziwemu zadaniu
- Wszystkie twoje przykłady mają tę samą etykietęNieróżnorodne: model może przejąć przypadkowy wzorzec
- Przykłady są wklejone jako luźny tekst między instrukcjamiNieustrukturyzowane: opakuj je w tagi, żeby nie można było ich pomylić z instrukcjami
Wyślij to przez API#
Prompt to ten sam tekst w każdym żądaniu, a zmienia się tylko nowe zgłoszenie. Każde zgłoszenie przechodzi tę samą krótką drogę:
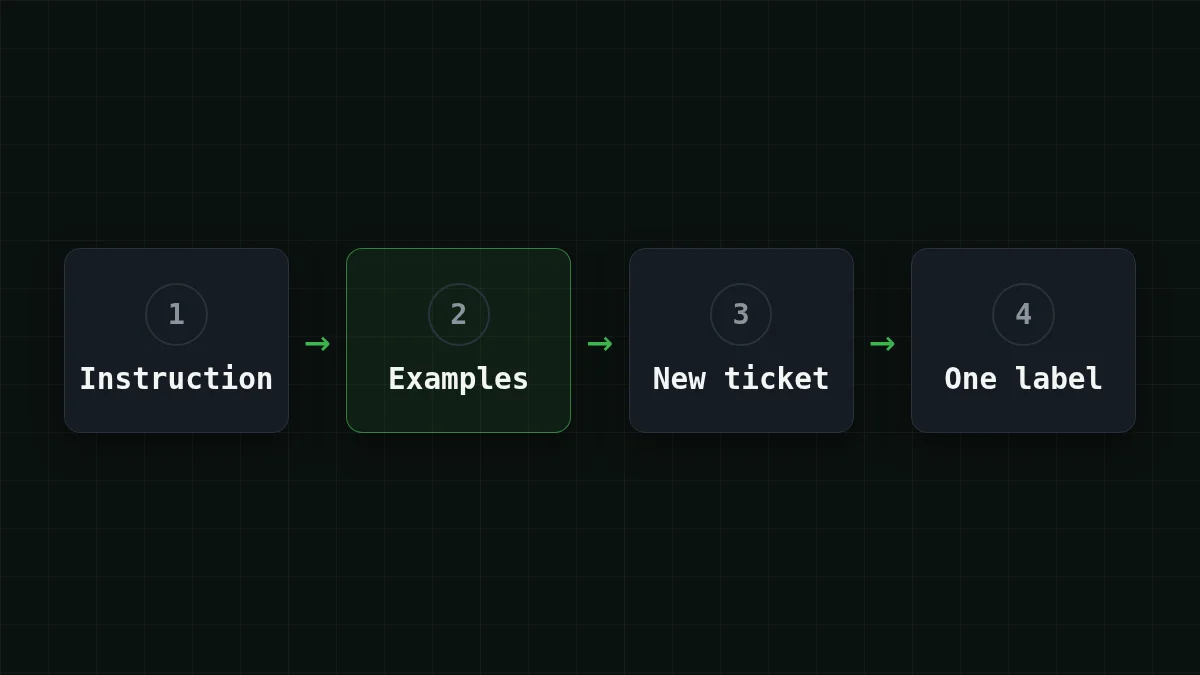
Oto to w Pythonie z pakietem openai. Adres to API CheapTokens, klucz siedzi w zmiennej środowiskowej (zobacz jak bezpiecznie przechowywać klucz), a id modelu to pełne id z dokumentacji:
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)

PROMPT = open("prompt.txt", encoding="utf-8").read()


def label(ticket: str) -> str:
    response = client.chat.completions.create(
        model="deepseek-ai/DeepSeek-V4-Flash-0731",
        max_tokens=64,
        messages=[
            {"role": "system", "content": PROMPT},
            {"role": "user", "content": f"<ticket>{ticket}</ticket>"},
        ],
    )
    print(response.usage.prompt_tokens, response.usage.completion_tokens)
    return response.choices[0].message.content.strip()


print(label("The app shows a blank screen after the update."))
Gdy działa, widzisz dwa liczniki tokenów w jednej linii, a potem samą etykietę, jedno słowo takie jak bug. Jeśli dostajesz zdanie, przykłady jeszcze nie robią swojego: sprawdź tagi i to, czy każda etykieta z twojego schematu pojawia się co najmniej raz.
Pierwsza liczba to ta, na którą trzeba patrzeć. To cały prompt, instrukcje plus przykłady plus zgłoszenie, i rośnie z każdym dodanym przykładem. Uruchom skrypt raz z pełnym prompt.txt i raz tylko z częścią <instructions>: różnica między dwiema pierwszymi liczbami to koszt twoich przykładów na żądanie.
DeepSeek-V4-Flash pasuje do takiego masowego etykietowania: jedna cena o każdej porze dnia, kontekst 380K tokenów (więc długi blok przykładów mieści się łatwo) i do 32 768 tokenów na odpowiedź. GLM-5.3-Flash z kontekstem 390K też działa do krótkich zadań etykietowania. Oba są na stronie modeli, za jednym saldem.
Ile pięć przykładów dodaje do rachunku#
Powiedzmy, że bot obsługuje 2 000 zgłoszeń dziennie. Załóż, że zgłoszenie to około 120 tokenów, a instrukcja około 80, więc żądanie bez przykładów to 80 + 120 = 200 tokenów wejściowych. Pięć przykładów po około 60 tokenów dodaje 5 × 60 = 300, więc żądanie z nimi to 200 + 300 = 500. Odpowiedź to jedno słowo, nazwijmy to 3 tokeny wyjściowe w obu przypadkach. To założenia: podstaw prompt_tokens, które wypisał twój skrypt.
W ciągu dnia 200 × 2 000 = 400 000 tokenów wejściowych staje się 500 × 2 000 = 1 000 000, podczas gdy wyjście zostaje na 3 × 2 000 = 6 000 tokenów. Na DeepSeek-V4-Flash to $0.0066 dziennie bez przykładów i $0.0156 z nimi. Przykłady kosztują cię różnicę między tymi dwiema liczbami, a według Anthropic kupują ci bardziej spójne wyjście.
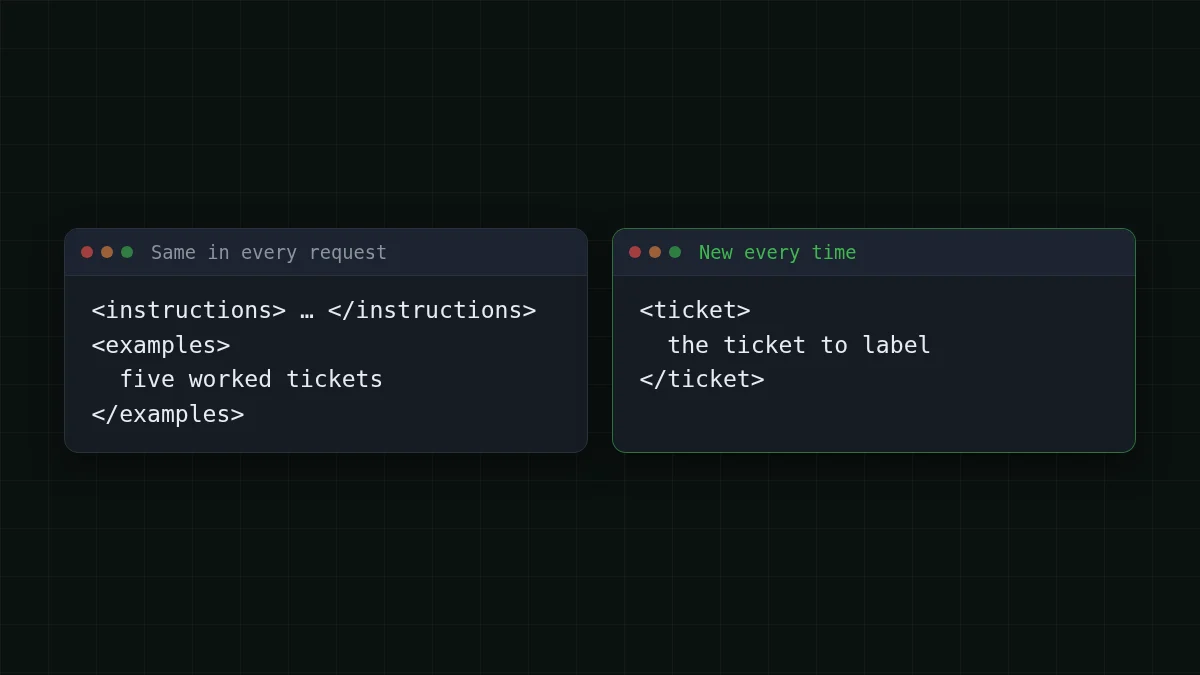
Ten obrazek ukrywa przydatny szczegół. Blok przykładów jest identyczny w każdym żądaniu, co jest dokładnie tym rodzajem powtarzanego początku, o którym mówi prompt caching; czym jest prompt caching wyjaśnia, jak to działa.
Oto to samo obciążenie, 500 tokenów wejściowych i 3 wyjściowe na żądanie, 2 000 żądań, w różnych modelach. Tabela przelicza z aktualnych cen:
| Model | Wejście $/1M | Wyjście $/1M | Za żądanie | 2000 żądań | OpenRouter, 2000 żądań |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00001 | $0.0202 | $0.034 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0000078 | $0.0156 | $0.0708 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000025 | $0.0509 | $0.611 |
500 tokenów wejściowych i 3 tokenów wyjściowych na żądanie. Ceny za 1 mln tokenów są aktualne i zmieniają się wraz z naszymi taryfami; kolumna OpenRouter pokazuje ceny referencyjne dla tego samego obciążenia.
Liczone razem wejście i wyjście, DeepSeek-V4-Flash i GLM-5.3-Flash wychodzą taniej niż OpenRouter przy tym obciążeniu. Pełna lista cen jest na stronie cennika.
JSON, ton i sprawdzanie przykładów#
Ten sam trik obejmuje dwa pozostałe przypadki, na które się natkniesz. Potrzebujesz tych samych pól JSON za każdym razem? Zrób z przykładu samą odpowiedź JSON:
<example>
<ticket>I was charged twice for the same top-up.</ticket>
<output>{"label": "billing", "urgent": true}</output>
</example>
O response_format i o tym, co robić, gdy odpowiedź wciąż jest niepoprawna, przeczytasz w uzyskaj poprawny JSON z API LLM. Chcesz przepisać tekst w jednym tonie? Przymiotniki jak „friendly but brief” są niejasne; dwie pary przed-i-po pokazują to lepiej.
Zanim zaufasz jakiemukolwiek zestawowi przykładów, weź 20 zgłoszeń, które już ręcznie oznaczyłeś, przepuść je i porównaj. Jeden przebieg mówi więcej niż jakakolwiek zasada. Strona Anthropic dodaje skrót: poproś model, by ocenił twoje przykłady pod kątem trafności i różnorodności albo napisał więcej na podstawie tych, które masz.
Lista kontrolna
Zanim zaufasz swoim przykładom
Gdy przykłady działają, następne pytanie brzmi, jak nie pozwolić kilku dokumentom zlać się w jednym promptcie. Oznacz każdy dokument w promptcie omawia to.


