AI для початківцівПосібник
Few-shot prompting: покажіть моделі 3–5 прикладів, щоб отримати свій формат
Як 3–5 прикладів із тегами змушують модель відповідати вашими мітками або JSON, із запитом мовою Python і додатковими витратами на вхідні дані за запит.
На цій сторінці
Ваш бот для тікетів має відповідати одним словом: billing, bug або other. Більшість відповідей саме такі. А потім надходить «Label: billing — the customer seems upset about a refund», і код, що читає мітку, затинається.
Звичайне виправлення — не довша інструкція. Це кілька прикладів: покладіть 3–5 готових тікетів з їхніми мітками в промпт, і модель скопіює шаблон. Це і є few-shot prompting. Посібник із промптингу від Anthropic (розділ «Use examples effectively», перевірено 3 листопада 2026) називає приклади одним із найнадійніших способів керувати форматом, тоном і структурою та рекомендує 3–5 з них. Підступ: кожен приклад — це вхідні дані, за які ви платите знову з кожним запитом. Розділ про витрати нижче рахує це для бота, що обробляє 2 000 тікетів на день.
Що означає «few-shot»#
Уявіть нового колегу в перший день за столом підтримки. Ви кажете «позначай кожен тікет як billing, bug або other» і йдете. Частина міток збіжиться з вашою ідеєю, частина — ні. Тепер залиште три тікети, які вже позначені, і скажіть «як ці». Той самий колега, значно менше сюрпризів.
Моделі поводяться так само. Лише інструкція називається zero-shot. Інструкція плюс кілька опрацьованих прикладів — це few-shot (сторінка Anthropic також каже multishot). «Shot» — це просто приклад.
Порівняйте
Те саме завдання, два промпти
Лише інструкція
Label the support ticket as billing, bug or other.Інструкція плюс приклади
Label the support ticket with one word: billing, bug or other.

Ticket: I was charged twice for one top-up.
Label: billing

Ticket: The export button does nothing.
Label: bug

Ticket: Do you have a dark theme?
Label: other
Другий промпт ніколи не пояснює, що означає billing. Приклади роблять це показом, і вони несуть формат разом зі змістом. Один явний рядок інструкції все одно не завадить, тож версія нижче його зберігає.
Три правила для прикладів, що працюють#
Сторінка Anthropic зводить хороші приклади до трьох слів:
- Релевантні: близькі до тікетів, які ви справді отримуєте, а не до якогось іншого завдання.
- Різноманітні: вони охоплюють крайові випадки й відрізняються один від одного, щоб модель не зачепилася за випадковий шаблон.
- Структуровані: обгорнуті в теги (
<example>, і кілька всередині<examples>), щоб модель могла відрізнити приклади від інструкцій. Та сама сторінка радить зберігати назви тегів узгодженими.
Ось повний промпт, побудований у такий спосіб. Збережіть його як prompt.txt:
<instructions>
Label the support ticket with exactly one word: billing, bug or other.
Reply with the label only.
</instructions>

<examples>
<example>
<ticket>I was charged twice for the same top-up.</ticket>
<label>billing</label>
</example>
<example>
<ticket>The export button does nothing when I click it.</ticket>
<label>bug</label>
</example>
<example>
<ticket>Do you have a dark theme?</ticket>
<label>other</label>
</example>
<example>
<ticket>Please refund me. Also, the page crashes on login.</ticket>
<label>billing</label>
</example>
<example>
<ticket>Is there an API for exporting reports?</ticket>
<label>other</label>
</example>
</examples>
Погляньте на четвертий приклад: запит на повернення коштів, який також згадує збій. Інструкція не може вирішити змішаний тікет, а приклад може. Тут перемагають гроші, тож мітка — billing. Яке б правило ви не обрали, покажіть його один раз.
З'єднайте пари
Яке правило порушено?
Торкніться елемента ліворуч, потім його пари
- Ваші приклади — однорядкові привітання в чаті, а справжні тікети — довгі листиНе релевантні: приклади мають бути близькими до реального завдання
- Усі ваші приклади мають однакову міткуНе різноманітні: модель може підхопити випадковий шаблон
- Приклади вставлені як вільний текст між інструкціямиНе структуровані: обгорніть їх у теги, щоб їх не можна було сплутати з інструкціями
Надішліть це через API#
Промпт — це той самий текст у кожному запиті, і змінюється лише новий тікет. Кожен тікет проходить ту саму коротку подорож:
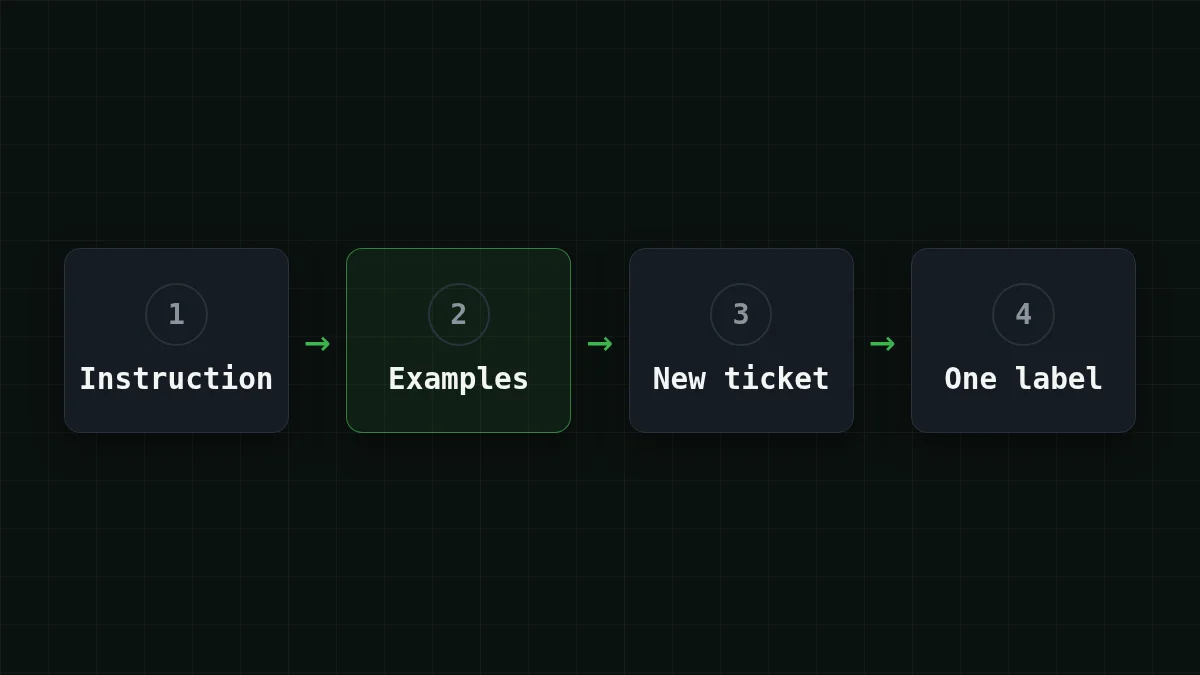
Ось це мовою Python з пакетом openai. Адреса — це API CheapTokens, ключ лежить у змінній середовища (див. як безпечно зберігати ключ), а id моделі — повний з документації:
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)

PROMPT = open("prompt.txt", encoding="utf-8").read()


def label(ticket: str) -> str:
    response = client.chat.completions.create(
        model="deepseek-ai/DeepSeek-V4-Flash-0731",
        max_tokens=64,
        messages=[
            {"role": "system", "content": PROMPT},
            {"role": "user", "content": f"<ticket>{ticket}</ticket>"},
        ],
    )
    print(response.usage.prompt_tokens, response.usage.completion_tokens)
    return response.choices[0].message.content.strip()


print(label("The app shows a blank screen after the update."))
Коли це працює, ви бачите два лічильники токенів в одному рядку, а потім саму мітку, одне слово, як-от bug. Якщо натомість ви отримуєте речення, приклади ще не виконують свою роботу: перевірте теги й те, що кожна мітка з вашої схеми з'являється принаймні один раз.
Перше число — те, за чим варто стежити. Це весь промпт: інструкції плюс приклади плюс тікет, і він зростає з кожним доданим прикладом. Запустіть скрипт один раз із повним prompt.txt і один раз лише з частиною <instructions>: різниця між двома першими числами — це те, скільки ваші приклади коштують за запит.
DeepSeek-V4-Flash підходить для такого масового маркування: одна ціна в будь-який час доби, контекст на 380K токенів (тож довгий блок прикладів легко вміщується) і до 32 768 токенів на відповідь. GLM-5.3-Flash із контекстом 390K також працює для коротких завдань маркування. Обидві є на сторінці моделей, за одним балансом.
Що п'ять прикладів додають до рахунку#
Скажімо, бот обробляє 2 000 тікетів на день. Припустімо, тікет — це близько 120 токенів, а інструкція — близько 80, тож запит без прикладів — це 80 + 120 = 200 вхідних токенів. П'ять прикладів по ~60 токенів кожен додають 5 × 60 = 300, тож запит із ними — це 200 + 300 = 500. Відповідь — одне слово, назвімо це 3 вихідними токенами в обох випадках. Це припущення: підставте prompt_tokens, які надрукував ваш скрипт.
За день 200 × 2 000 = 400 000 вхідних токенів стає 500 × 2 000 = 1 000 000, тоді як вихід залишається на рівні 3 × 2 000 = 6 000 токенів. На DeepSeek-V4-Flash це $0.0066 на день без прикладів і $0.0156 з ними. Приклади коштують вам різниці між цими двома числами, і, за словами Anthropic, вони дають вам більш узгоджений вихід.
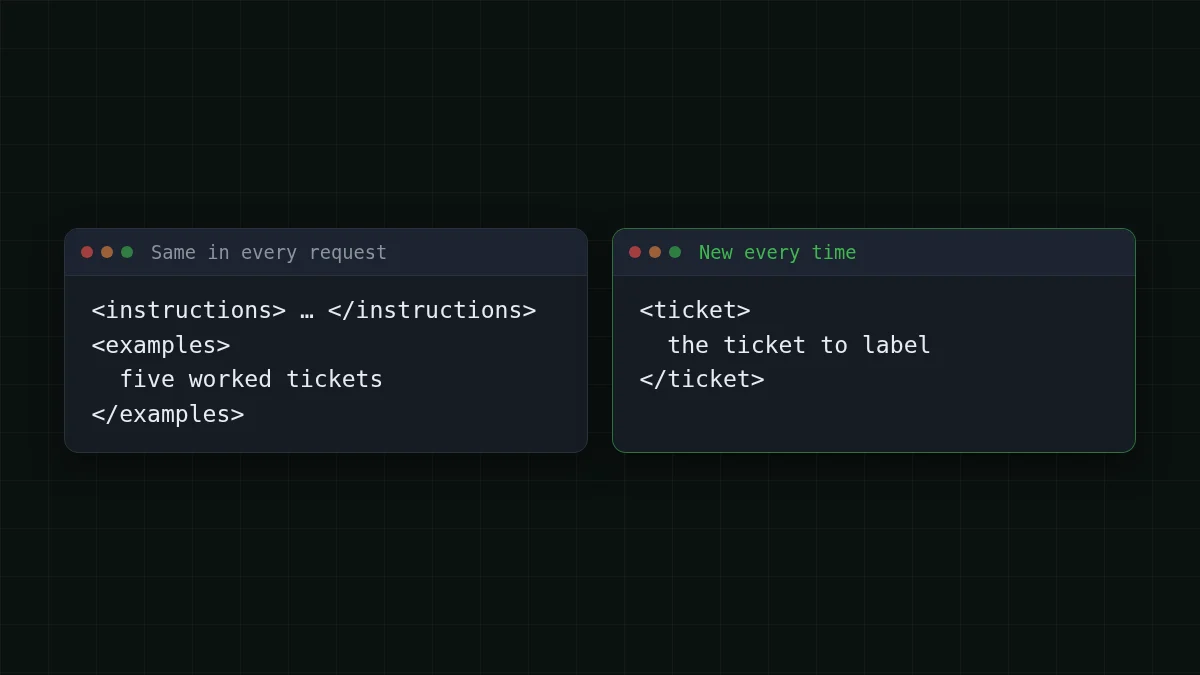
Ця картинка приховує корисну деталь. Блок прикладів ідентичний у кожному запиті, а це саме той тип повторюваного початку, про який ідеться в prompt caching; що таке prompt caching пояснює, як це працює.
Ось те саме навантаження, 500 вхідних і 3 вихідних токени за запит, 2 000 запитів, по моделях. Таблиця перераховується за поточними цінами:
| Модель | Вхід $/1М | Вихід $/1М | За запит | 2 000 запитів | OpenRouter, 2 000 запитів |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00001 | $0.0202 | $0.034 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0000078 | $0.0156 | $0.0708 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000025 | $0.0509 | $0.611 |
500 вхідних і 3 вихідних токенів на запит. Ціни за 1 млн токенів актуальні та змінюються разом із нашими тарифами; стовпець OpenRouter показує довідкові ціни для того самого навантаження.
Якщо рахувати вхід і вихід разом, DeepSeek-V4-Flash і GLM-5.3-Flash виходять дешевшими за OpenRouter за такого навантаження. Повний список цін — на сторінці цін.
JSON, тон і перевірка ваших прикладів#
Той самий прийом покриває два інші випадки, з якими ви зіткнетеся. Потрібні ті самі поля JSON щоразу? Зробіть так, щоб приклад відповідав самим JSON:
<example>
<ticket>I was charged twice for the same top-up.</ticket>
<output>{"label": "billing", "urgent": true}</output>
</example>
Про response_format і що робити, коли відповідь усе ще недійсна, див. отримати валідний JSON від LLM API. Хочете переписати текст в одному тоні? Прикметники на кшталт «дружній, але короткий» — розпливчасті; дві пари «до і після» показують це краще.
Перш ніж довіряти будь-якому набору прикладів, візьміть 20 тікетів, які ви вже позначили вручну, запустіть їх і порівняйте. Один прохід скаже вам більше, ніж будь-яке правило. Сторінка Anthropic додає ярлик: попросіть модель оцінити ваші приклади на релевантність і різноманітність або написати більше на основі наявних.
Чек-лист
Перш ніж довіряти своїм прикладам
Щойно приклади запрацюють, наступне питання — як не дати кільком документам змішатися в одному промпті. Позначте кожен документ у промпті розповідає про це.


