KI für EinsteigerAnleitung
Few-Shot-Prompting: Zeige dem Modell 3–5 Beispiele, um dein Format zu bekommen
Wie 3–5 getaggte Beispiele ein Modell dazu bringen, in deinen Labels oder JSON zu antworten, mit einer Python-Anfrage und den zusätzlichen Input-Kosten pro Anfrage.
Auf dieser Seite
Dein Ticket-Bot sollte mit einem Wort antworten: billing, bug oder other. Die meisten Antworten sind genau das. Dann kommt eine als „Label: billing — der Kunde scheint wegen einer Rückerstattung verärgert zu sein“, und der Code, der das Label liest, bricht ab.
Die übliche Lösung ist keine längere Anweisung. Es sind ein paar Beispiele: Packe 3–5 fertige Tickets mit ihren Labels in den Prompt, und das Modell kopiert das Muster. Das ist Few-Shot-Prompting. Anthropics Prompting-Guide (Abschnitt „Use examples effectively“, geprüft am 3. November 2026) nennt Beispiele eine der zuverlässigsten Methoden, um Format, Ton und Struktur zu steuern, und empfiehlt 3–5 davon. Der Haken: Jedes Beispiel ist Input, den du bei jeder Anfrage erneut bezahlst. Der Kostenabschnitt unten rechnet es für einen Bot durch, der 2.000 Tickets pro Tag bearbeitet.
Was „Few-Shot“ bedeutet#
Stell dir eine neue Kollegin an ihrem ersten Tag am Support-Desk vor. Du sagst „tagge jedes Ticket mit billing, bug oder other“ und gehst weg. Einige Tags werden deiner Vorstellung entsprechen, andere nicht. Jetzt hinterlasse drei Tickets, die bereits getaggt sind, und sage „so wie diese“. Dieselbe Kollegin, deutlich weniger Überraschungen.
Modelle verhalten sich genauso. Nur eine Anweisung nennt man Zero-Shot. Anweisung plus mehrere ausgearbeitete Beispiele ist Few-Shot (Anthropics Seite sagt auch Multishot). Ein „Shot“ ist einfach ein Beispiel.
Vergleichen
Dieselbe Aufgabe, zwei Prompts
Nur Anweisung
Label the support ticket as billing, bug or other.Anweisung plus Beispiele
Label the support ticket with one word: billing, bug or other.

Ticket: I was charged twice for one top-up.
Label: billing

Ticket: The export button does nothing.
Label: bug

Ticket: Do you have a dark theme?
Label: other
Der zweite Prompt erklärt nie, was billing bedeutet. Die Beispiele tun es, indem sie es zeigen, und sie transportieren das Format zusammen mit der Bedeutung. Eine explizite Anweisungszeile schadet trotzdem nicht, deshalb behält die Version unten sie bei.
Drei Regeln für Beispiele, die funktionieren#
Anthropics Seite bringt gute Beispiele auf drei Wörter:
- Relevant: nah an den Tickets, die du wirklich bekommst, nicht an irgendeiner anderen Aufgabe.
- Diverse: sie decken Randfälle ab und unterscheiden sich voneinander, damit das Modell sich nicht an ein zufälliges Muster klammert.
- Structured: in Tags eingebettet (
<example>, und mehrere innerhalb von<examples>), damit das Modell Beispiele von Anweisungen unterscheiden kann. Dieselbe Seite sagt, man soll die Tag-Namen konsistent halten.
Hier ist ein vollständiger Prompt, so aufgebaut. Speichere ihn als prompt.txt:
<instructions>
Label the support ticket with exactly one word: billing, bug or other.
Reply with the label only.
</instructions>

<examples>
<example>
<ticket>I was charged twice for the same top-up.</ticket>
<label>billing</label>
</example>
<example>
<ticket>The export button does nothing when I click it.</ticket>
<label>bug</label>
</example>
<example>
<ticket>Do you have a dark theme?</ticket>
<label>other</label>
</example>
<example>
<ticket>Please refund me. Also, the page crashes on login.</ticket>
<label>billing</label>
</example>
<example>
<ticket>Is there an API for exporting reports?</ticket>
<label>other</label>
</example>
</examples>
Schau dir das vierte Beispiel an: eine Rückerstattungsanfrage, die auch einen Absturz erwähnt. Eine Anweisung kann ein gemischtes Ticket nicht klären, ein Beispiel schon. Hier gewinnt das Geld, also ist das Label billing. Welche Regel du auch wählst, zeige sie einmal.
Paare zuordnen
Welche Regel ist verletzt?
Tippe auf ein Element links, dann auf sein Paar
- Deine Beispiele sind einzeilige Chat-Begrüßungen, aber echte Tickets sind lange E-MailsNicht relevant: Beispiele müssen nah an der echten Aufgabe sein
- Alle deine Beispiele tragen dasselbe LabelNicht divers: das Modell kann ein zufälliges Muster aufgreifen
- Beispiele sind als loser Text zwischen die Anweisungen geklebtNicht strukturiert: bette sie in Tags ein, damit sie nicht mit Anweisungen verwechselt werden
Durch die API schicken#
Der Prompt ist bei jeder Anfrage derselbe Text, und nur das neue Ticket ändert sich. Jedes Ticket macht dieselbe kurze Reise:
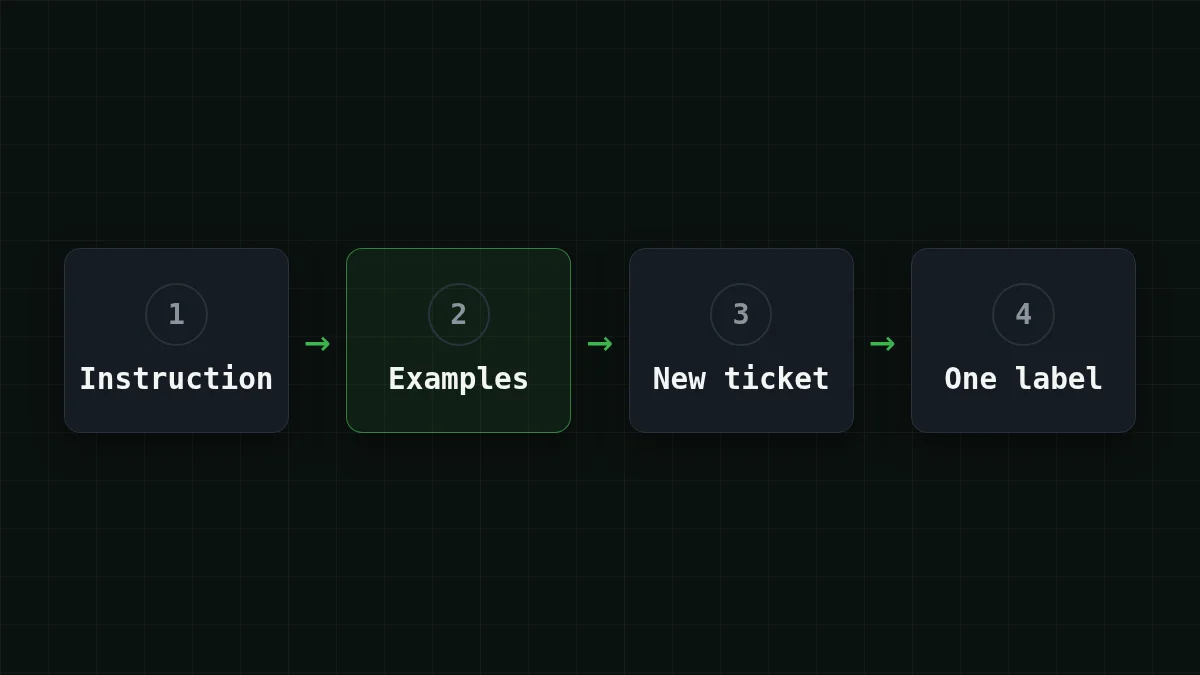
Hier ist es in Python mit dem openai-Paket. Die Adresse ist die CheapTokens API, der Key steckt in einer Umgebungsvariable (siehe wie man einen Key sicher speichert), und die Modell-ID ist die vollständige aus der Doku:
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)

PROMPT = open("prompt.txt", encoding="utf-8").read()


def label(ticket: str) -> str:
    response = client.chat.completions.create(
        model="deepseek-ai/DeepSeek-V4-Flash-0731",
        max_tokens=64,
        messages=[
            {"role": "system", "content": PROMPT},
            {"role": "user", "content": f"<ticket>{ticket}</ticket>"},
        ],
    )
    print(response.usage.prompt_tokens, response.usage.completion_tokens)
    return response.choices[0].message.content.strip()


print(label("The app shows a blank screen after the update."))
Wenn es funktioniert, siehst du zwei Token-Zahlen in einer Zeile und dann das Label selbst, ein Wort wie bug. Wenn du stattdessen einen Satz bekommst, leisten die Beispiele ihre Arbeit noch nicht: Prüfe die Tags und ob jedes Label aus deinem Schema mindestens einmal vorkommt.
Die erste Zahl ist die, auf die du achten solltest. Sie ist der ganze Prompt, Anweisungen plus Beispiele plus das Ticket, und sie wächst mit jedem Beispiel, das du hinzufügst. Führe das Skript einmal mit dem vollständigen prompt.txt und einmal nur mit dem <instructions>-Teil aus: Die Differenz zwischen den beiden ersten Zahlen sind die Kosten deiner Beispiele pro Anfrage.
DeepSeek-V4-Flash eignet sich für diese Art Massen-Labeling: ein Preis zu jeder Tageszeit, ein Kontext von 380K Tokens (sodass ein langer Beispielblock leicht hineinpasst) und bis zu 32.768 Tokens pro Antwort. GLM-5.3-Flash mit 390K Kontext funktioniert für kurze Labeling-Aufgaben ebenfalls. Beide stehen auf der Modellseite, hinter einem Guthaben.
Was fünf Beispiele zur Rechnung hinzufügen#
Sagen wir, der Bot bearbeitet 2.000 Tickets pro Tag. Nimm an, ein Ticket hat etwa 120 Tokens und die Anweisung etwa 80, also ist eine Anfrage ohne Beispiele 80 + 120 = 200 Input-Tokens. Fünf Beispiele mit je etwa 60 Tokens fügen 5 × 60 = 300 hinzu, also ist eine Anfrage mit ihnen 200 + 300 = 500. Die Antwort ist ein Wort, nennen wir es in beiden Fällen 3 Output-Tokens. Das sind Annahmen: Setze die prompt_tokens ein, die dein Skript ausgegeben hat.
Über einen Tag werden aus 200 × 2.000 = 400.000 Input-Tokens 500 × 2.000 = 1.000.000, während der Output bei 3 × 2.000 = 6.000 Tokens bleibt. Auf DeepSeek-V4-Flash sind das $0.0066 pro Tag ohne Beispiele und $0.0156 mit ihnen. Die Beispiele kosten dich die Differenz zwischen diesen beiden Zahlen, und laut Anthropic kaufst du dir dafür konsistenteren Output.
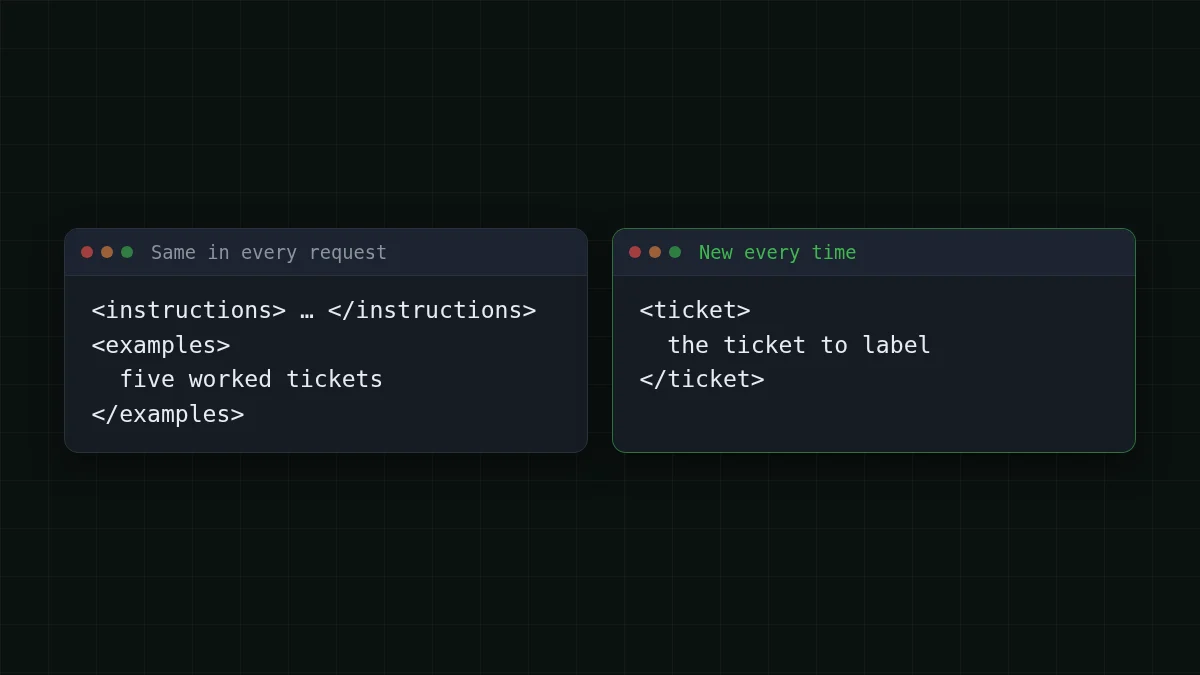
Dieses Bild verbirgt ein nützliches Detail. Der Beispielblock ist bei jeder Anfrage identisch, und genau das ist die Art wiederholter Anfang, um den es beim Prompt-Caching geht; was ist Prompt-Caching erklärt, wie das funktioniert.
Hier ist dieselbe Last, 500 Input- und 3 Output-Tokens pro Anfrage, 2.000 Anfragen, über mehrere Modelle. Die Tabelle rechnet mit aktuellen Preisen:
| Modell | Input $/1M | Output $/1M | Pro Anfrage | 2.000 Anfragen | OpenRouter, 2.000 Anfragen |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00001 | $0.0202 | $0.034 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0000078 | $0.0156 | $0.0708 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000025 | $0.0509 | $0.611 |
500 Input- und 3 Output-Tokens pro Anfrage. Die Preise pro 1 Mio. Tokens sind aktuell und ändern sich zusammen mit unseren Tarifen; die OpenRouter-Spalte zeigt Referenzpreise für dieselbe Arbeitslast.
Input und Output zusammengerechnet kommen DeepSeek-V4-Flash und GLM-5.3-Flash bei dieser Last günstiger weg als OpenRouter. Die vollständige Preisliste steht auf der Preisseite.
JSON, Ton und das Prüfen deiner Beispiele#
Derselbe Trick deckt die anderen beiden Fälle ab, auf die du stoßen wirst. Brauchst du jedes Mal dieselben JSON-Felder? Lass das Beispiel selbst das JSON sein:
<example>
<ticket>I was charged twice for the same top-up.</ticket>
<output>{"label": "billing", "urgent": true}</output>
</example>
Für response_format und was zu tun ist, wenn eine Antwort trotzdem ungültig ist, siehe gültiges JSON von einer LLM-API bekommen. Willst du Text in einem bestimmten Ton umgeschrieben haben? Adjektive wie „freundlich, aber knapp“ sind vage; zwei Vorher-Nachher-Paare zeigen es besser.
Bevor du irgendeinem Beispielsatz vertraust, nimm 20 Tickets, die du bereits von Hand gelabelt hast, lass sie durchlaufen und vergleiche. Ein Durchlauf sagt dir mehr als jede Regel. Anthropics Seite fügt eine Abkürzung hinzu: Bitte das Modell, deine Beispiele nach Relevanz und Vielfalt zu bewerten oder weitere aus den vorhandenen zu schreiben.
Checkliste
Bevor du deinen Beispielen vertraust
Sobald die Beispiele funktionieren, ist die nächste Frage, wie du verhinderst, dass mehrere Dokumente in einem Prompt ineinander verschwimmen. Jedes Dokument in einem Prompt labeln behandelt das.


