AI per principiantiGuida
Few-shot prompting: mostra al modello 3–5 esempi per ottenere il tuo formato
Come 3–5 esempi con tag fanno rispondere un modello con le tue etichette o JSON, con una richiesta Python e il costo extra di input per richiesta.
In questa pagina
Il tuo bot per i ticket dovrebbe rispondere con una sola parola: billing, bug o other. La maggior parte delle risposte è esattamente così. Poi ne arriva una come "Label: billing — the customer seems upset about a refund", e il codice che legge l'etichetta si blocca.
La soluzione abituale non è un'istruzione più lunga. Sono alcuni esempi: inserisci 3–5 ticket completati con le loro etichette nel prompt, e il modello copia il pattern. Questo è il few-shot prompting. La guida al prompting di Anthropic (sezione "Use examples effectively", consultata il 3 novembre 2026) definisce gli esempi uno dei modi più affidabili per guidare formato, tono e struttura, e ne raccomanda 3–5. Il problema: ogni esempio è input che paghi di nuovo a ogni richiesta. La sezione sui costi qui sotto lo calcola per un bot che gestisce 2.000 ticket al giorno.
Cosa significa "few-shot"#
Immagina un nuovo collega al suo primo giorno al supporto. Gli dici "etichetta ogni ticket come billing, bug o other" e te ne vai. Alcune etichette corrisponderanno alla tua idea, altre no. Ora lascia tre ticket già etichettati e digli "come questi". Stesso collega, molte meno sorprese.
I modelli si comportano allo stesso modo. La sola istruzione si chiama zero-shot. Istruzione più diversi esempi svolti è few-shot (la pagina di Anthropic dice anche multishot). Uno "shot" è semplicemente un esempio.
Confronta
Stesso compito, due prompt
Solo istruzione
Label the support ticket as billing, bug or other.Istruzione più esempi
Label the support ticket with one word: billing, bug or other.

Ticket: I was charged twice for one top-up.
Label: billing

Ticket: The export button does nothing.
Label: bug

Ticket: Do you have a dark theme?
Label: other
Il secondo prompt non spiega mai cosa significhi billing. Gli esempi lo fanno mostrando, e portano con sé il formato insieme al significato. Una riga esplicita di istruzione non guasta comunque, quindi la versione qui sotto la mantiene.
Tre regole per esempi che funzionano#
La pagina di Anthropic riduce i buoni esempi a tre parole:
- Rilevanti: vicini ai ticket che ricevi davvero, non a qualche altro compito.
- Diversi: coprono i casi limite e differiscono tra loro, così il modello non si aggrappa a un pattern accidentale.
- Strutturati: racchiusi in tag (
<example>, e diversi dentro<examples>) così il modello distingue gli esempi dalle istruzioni. La stessa pagina dice di mantenere coerenti i nomi dei tag.
Ecco un prompt completo costruito così. Salvalo come prompt.txt:
<instructions>
Label the support ticket with exactly one word: billing, bug or other.
Reply with the label only.
</instructions>

<examples>
<example>
<ticket>I was charged twice for the same top-up.</ticket>
<label>billing</label>
</example>
<example>
<ticket>The export button does nothing when I click it.</ticket>
<label>bug</label>
</example>
<example>
<ticket>Do you have a dark theme?</ticket>
<label>other</label>
</example>
<example>
<ticket>Please refund me. Also, the page crashes on login.</ticket>
<label>billing</label>
</example>
<example>
<ticket>Is there an API for exporting reports?</ticket>
<label>other</label>
</example>
</examples>
Guarda il quarto esempio: una richiesta di rimborso che menziona anche un crash. Un'istruzione non può risolvere un ticket misto, un esempio sì. Qui vince il denaro, quindi l'etichetta è billing. Qualunque regola scegli, mostrala una volta.
Abbina le coppie
Quale regola è violata?
Tocca un elemento a sinistra, poi il suo abbinamento
- I tuoi esempi sono saluti di chat di una riga, ma i ticket reali sono email lungheNon rilevanti: gli esempi devono essere vicini al compito reale
- Tutti i tuoi esempi portano la stessa etichettaNon diversi: il modello può cogliere un pattern accidentale
- Gli esempi sono incollati come testo libero tra le istruzioniNon strutturati: racchiudili in tag così non possono essere scambiati per istruzioni
Inviarlo tramite l'API#
Il prompt è lo stesso testo in ogni richiesta, e cambia solo il nuovo ticket. Ogni ticket fa lo stesso breve viaggio:
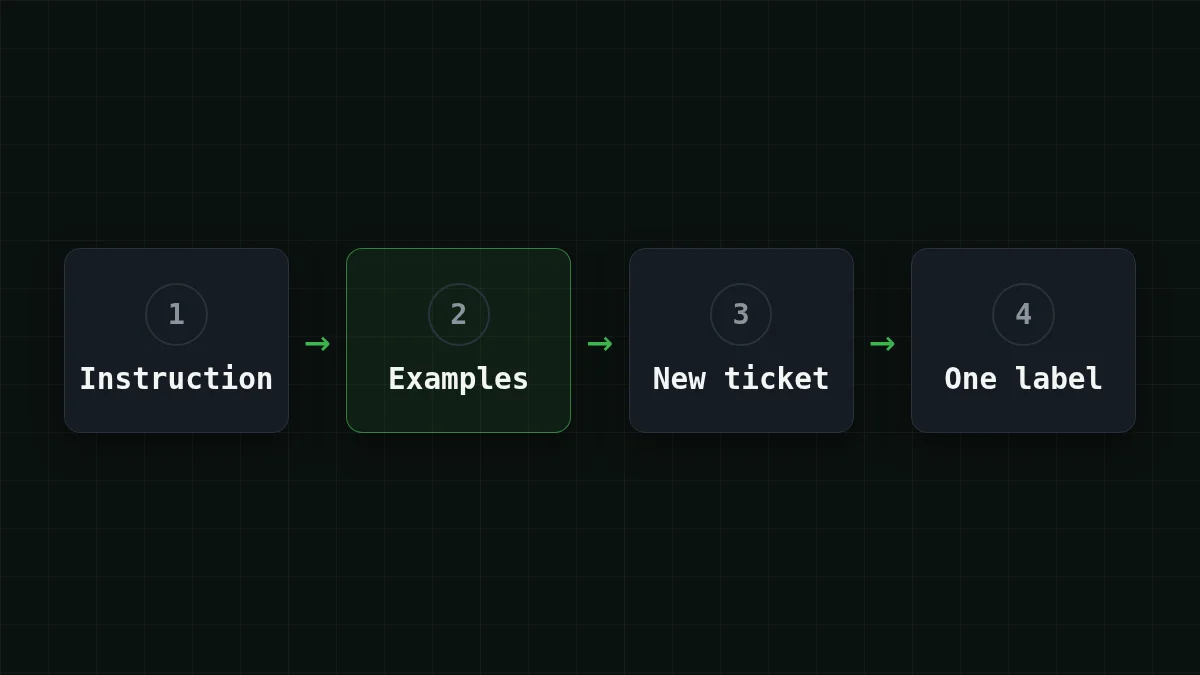
Ecco il codice in Python con il pacchetto openai. L'indirizzo è l'API di CheapTokens, la chiave sta in una variabile d'ambiente (vedi come memorizzare una chiave in modo sicuro), e l'id del modello è quello completo dalla documentazione:
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)

PROMPT = open("prompt.txt", encoding="utf-8").read()


def label(ticket: str) -> str:
    response = client.chat.completions.create(
        model="deepseek-ai/DeepSeek-V4-Flash-0731",
        max_tokens=64,
        messages=[
            {"role": "system", "content": PROMPT},
            {"role": "user", "content": f"<ticket>{ticket}</ticket>"},
        ],
    )
    print(response.usage.prompt_tokens, response.usage.completion_tokens)
    return response.choices[0].message.content.strip()


print(label("The app shows a blank screen after the update."))
Quando funziona vedi due conteggi di token su una riga e poi l'etichetta stessa, una parola come bug. Se ottieni una frase, gli esempi non stanno ancora facendo il loro lavoro: controlla i tag e che ogni etichetta del tuo schema compaia almeno una volta.
Il primo numero è quello da tenere d'occhio. È l'intero prompt, istruzioni più esempi più il ticket, e cresce con ogni esempio che aggiungi. Esegui lo script una volta con il prompt.txt completo e una volta con la sola parte <instructions>: la differenza tra i due primi numeri è quanto ti costano gli esempi per richiesta.
DeepSeek-V4-Flash è adatto a questo tipo di etichettatura di massa: un prezzo a qualsiasi ora del giorno, una finestra di contesto di 380K token (così un lungo blocco di esempi entra facilmente) e fino a 32.768 token per risposta. GLM-5.3-Flash, con un contesto di 390K, va bene anch'esso per compiti brevi di etichettatura. Entrambi sono sulla pagina dei modelli, dietro un unico saldo.
Quanto aggiungono cinque esempi alla fattura#
Diciamo che il bot gestisca 2.000 ticket al giorno. Supponi che un ticket sia circa 120 token e l'istruzione circa 80, quindi una richiesta senza esempi è 80 + 120 = 200 token di input. Cinque esempi da circa 60 token ciascuno aggiungono 5 × 60 = 300, quindi una richiesta con essi è 200 + 300 = 500. La risposta è una parola, chiamala 3 token di output in entrambi i casi. Queste sono ipotesi: sostituisci con i prompt_tokens che ha stampato il tuo script.
Nell'arco di un giorno, 200 × 2.000 = 400.000 token di input diventano 500 × 2.000 = 1.000.000, mentre l'output resta a 3 × 2.000 = 6.000 token. Su DeepSeek-V4-Flash sono $0.0066 al giorno senza esempi e $0.0156 con essi. Gli esempi ti costano la differenza tra questi due numeri, e secondo Anthropic ti danno un output più coerente.
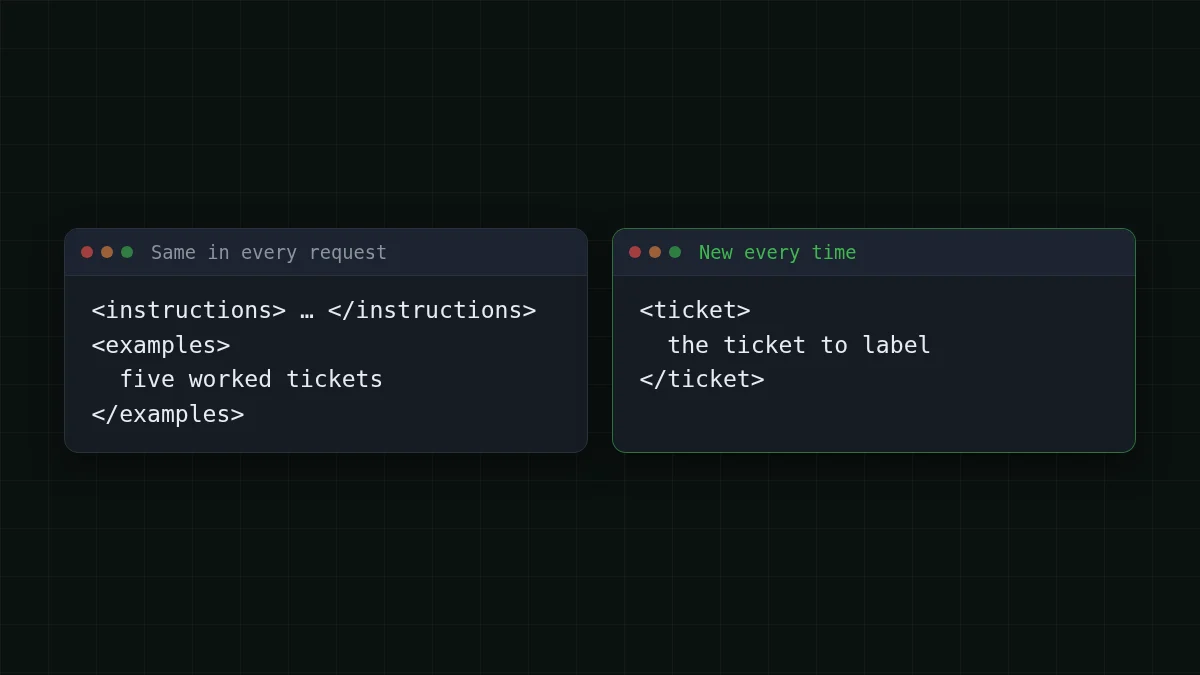
Quell'immagine nasconde un dettaglio utile. Il blocco degli esempi è identico in ogni richiesta, che è esattamente il tipo di inizio ripetuto di cui si occupa il prompt caching; cos'è il prompt caching spiega come funziona.
Ecco lo stesso carico, 500 token di input e 3 di output per richiesta, 2.000 richieste, tra i modelli. La tabella si ricalcola dai prezzi attuali:
| Modello | Input $/1M | Output $/1M | Per richiesta | 2000 richieste | OpenRouter, 2000 richieste |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00001 | $0.0202 | $0.034 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0000078 | $0.0156 | $0.0708 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000025 | $0.0509 | $0.611 |
500 token di input e 3 token di output per richiesta. I prezzi per 1M di token sono attuali e cambiano insieme alle nostre tariffe; la colonna OpenRouter mostra i prezzi di riferimento per lo stesso carico di lavoro.
Contando insieme input e output, DeepSeek-V4-Flash e GLM-5.3-Flash risultano più economici di OpenRouter con questo carico. L'elenco completo dei prezzi è sulla pagina dei prezzi.
JSON, tono e verifica dei tuoi esempi#
Lo stesso trucco copre gli altri due casi che incontrerai. Ti servono gli stessi campi JSON ogni volta? Fai in modo che l'esempio sia la risposta JSON stessa:
<example>
<ticket>I was charged twice for the same top-up.</ticket>
<output>{"label": "billing", "urgent": true}</output>
</example>
Per response_format e cosa fare quando una risposta non è ancora valida, vedi ottenere JSON valido da un'API LLM. Vuoi un testo riscritto con un certo tono? Aggettivi come "amichevole ma breve" sono vaghi; due coppie prima-e-dopo lo mostrano meglio.
Prima di fidarti di qualsiasi insieme di esempi, prendi 20 ticket che hai già etichettato a mano, eseguili e confronta. Un solo passaggio ti dice più di qualsiasi regola. La pagina di Anthropic aggiunge una scorciatoia: chiedi al modello di valutare i tuoi esempi per rilevanza e diversità, o di scriverne altri partendo da quelli che hai.
Lista di controllo
Prima di fidarti dei tuoi esempi
Una volta che gli esempi funzionano, la domanda successiva è come evitare che diversi documenti si confondano in un unico prompt. Etichettare ogni documento in un prompt se ne occupa.


