IA pour débutantsGuide
Few-shot prompting : montrez 3 à 5 exemples au modèle pour obtenir votre format
Comment 3 à 5 exemples balisés font répondre un modèle dans vos labels ou en JSON, avec une requête Python et le coût d'entrée supplémentaire par requête.
Sur cette page
Votre bot de tickets devrait répondre avec un seul mot : billing, bug ou other. La plupart des réponses sont exactement cela. Puis arrive « Label: billing — the customer seems upset about a refund », et le code qui lit le label s'étouffe.
Le correctif habituel n'est pas une instruction plus longue. Ce sont quelques exemples : placez 3 à 5 tickets terminés avec leurs labels dans le prompt, et le modèle copie le schéma. C'est le few-shot prompting. Le guide de prompting d'Anthropic (section « Use examples effectively », consultée le 3 novembre 2026) qualifie les exemples de l'un des moyens les plus fiables d'orienter le format, le ton et la structure, et en recommande 3 à 5. Le hic : chaque exemple est une entrée que vous payez à nouveau à chaque requête. La section coûts ci-dessous les compte pour un bot qui traite 2 000 tickets par jour.
Ce que signifie « few-shot »#
Imaginez un nouveau collègue à son premier jour au support. Vous dites « étiquette chaque ticket billing, bug ou other » et vous partez. Certaines étiquettes correspondront à votre idée, d'autres non. Maintenant, laissez trois tickets déjà étiquetés et dites « comme ceux-ci ». Même collègue, bien moins de surprises.
Les modèles se comportent de la même façon. Une instruction seule s'appelle zero-shot. Une instruction plus plusieurs exemples travaillés, c'est le few-shot (la page d'Anthropic dit aussi multishot). Un « shot » n'est qu'un exemple.
Comparer
Même tâche, deux prompts
Instruction seule
Label the support ticket as billing, bug or other.Instruction plus exemples
Label the support ticket with one word: billing, bug or other.

Ticket: I was charged twice for one top-up.
Label: billing

Ticket: The export button does nothing.
Label: bug

Ticket: Do you have a dark theme?
Label: other
Le second prompt n'explique jamais ce que signifie billing. Les exemples le font en montrant, et ils portent le format avec le sens. Une ligne d'instruction explicite ne fait toujours pas de mal, donc la version ci-dessous la conserve.
Trois règles pour des exemples qui fonctionnent#
La page d'Anthropic résume les bons exemples en trois mots :
- Pertinents : proches des tickets que vous recevez vraiment, pas d'une autre tâche.
- Divers : ils couvrent les cas limites et diffèrent les uns des autres, pour que le modèle ne s'accroche pas à un schéma accidentel.
- Structurés : enveloppés dans des balises (
<example>, et plusieurs dans<examples>) pour que le modèle distingue les exemples des instructions. La même page dit de garder les noms de balises cohérents.
Voici un prompt complet construit ainsi. Enregistrez-le sous prompt.txt :
<instructions>
Label the support ticket with exactly one word: billing, bug or other.
Reply with the label only.
</instructions>

<examples>
<example>
<ticket>I was charged twice for the same top-up.</ticket>
<label>billing</label>
</example>
<example>
<ticket>The export button does nothing when I click it.</ticket>
<label>bug</label>
</example>
<example>
<ticket>Do you have a dark theme?</ticket>
<label>other</label>
</example>
<example>
<ticket>Please refund me. Also, the page crashes on login.</ticket>
<label>billing</label>
</example>
<example>
<ticket>Is there an API for exporting reports?</ticket>
<label>other</label>
</example>
</examples>
Regardez le quatrième exemple : une demande de remboursement qui mentionne aussi un crash. Une instruction ne peut pas trancher un ticket mixte, un exemple le peut. Ici l'argent l'emporte, donc le label est billing. Quelle que soit la règle choisie, montrez-la une fois.
Associer les paires
Quelle règle est enfreinte ?
Touchez un élément à gauche, puis sa paire
- Vos exemples sont des salutations de chat d'une ligne, mais les vrais tickets sont de longs e-mailsPas pertinents : les exemples doivent être proches de la tâche réelle
- Tous vos exemples portent le même labelPas divers : le modèle peut saisir un schéma accidentel
- Les exemples sont collés en texte libre entre les instructionsPas structurés : enveloppez-les dans des balises pour qu'ils ne soient pas pris pour des instructions
Envoyez-le via l'API#
Le prompt est le même texte à chaque requête, seul le nouveau ticket change. Chaque ticket suit le même court trajet :
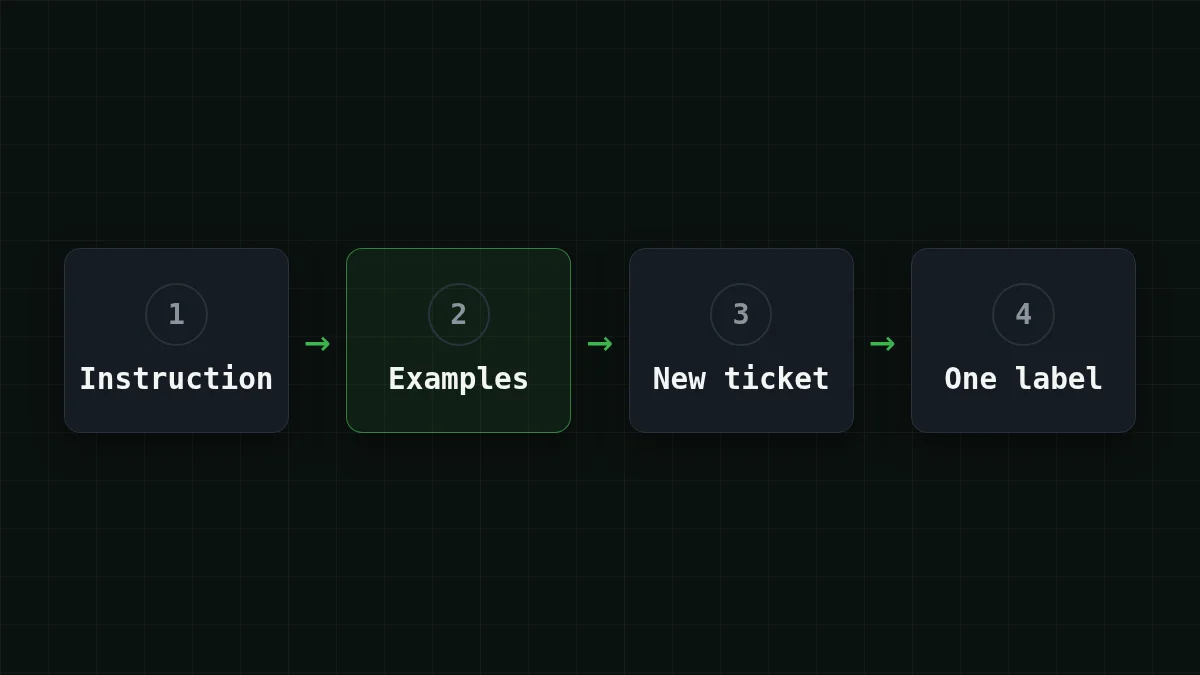
Voici en Python avec le paquet openai. L'adresse est l'API CheapTokens, la clé se trouve dans une variable d'environnement (voir comment stocker une clé en sécurité), et l'id du modèle est le complet de la documentation :
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)

PROMPT = open("prompt.txt", encoding="utf-8").read()


def label(ticket: str) -> str:
    response = client.chat.completions.create(
        model="deepseek-ai/DeepSeek-V4-Flash-0731",
        max_tokens=64,
        messages=[
            {"role": "system", "content": PROMPT},
            {"role": "user", "content": f"<ticket>{ticket}</ticket>"},
        ],
    )
    print(response.usage.prompt_tokens, response.usage.completion_tokens)
    return response.choices[0].message.content.strip()


print(label("The app shows a blank screen after the update."))
Quand ça marche, vous voyez deux comptes de tokens sur une ligne puis le label lui-même, un mot comme bug. Si vous obtenez une phrase à la place, les exemples ne font pas encore leur travail : vérifiez les balises et que chaque label de votre schéma apparaît au moins une fois.
Le premier nombre est celui à surveiller. C'est tout le prompt, instructions plus exemples plus le ticket, et il grandit à chaque exemple ajouté. Lancez le script une fois avec le prompt.txt complet et une fois avec seulement la partie <instructions> : l'écart entre les deux premiers nombres est ce que vos exemples coûtent par requête.
DeepSeek-V4-Flash convient à ce type d'étiquetage de masse : un prix à toute heure, un contexte de 380K tokens (donc un long bloc d'exemples tient facilement) et jusqu'à 32 768 tokens par réponse. GLM-5.3-Flash, avec un contexte de 390K, fonctionne aussi pour les tâches d'étiquetage courtes. Les deux sont sur la page des modèles, derrière un seul solde.
Ce que cinq exemples ajoutent à la facture#
Disons que le bot traite 2 000 tickets par jour. Supposez qu'un ticket fait environ 120 tokens et l'instruction environ 80, donc une requête sans exemples fait 80 + 120 = 200 tokens d'entrée. Cinq exemples d'environ 60 tokens chacun ajoutent 5 × 60 = 300, donc une requête avec eux fait 200 + 300 = 500. La réponse est un mot, disons 3 tokens de sortie dans les deux cas. Ce sont des hypothèses : remplacez par le prompt_tokens que votre script a affiché.
Sur une journée, 200 × 2 000 = 400 000 tokens d'entrée deviennent 500 × 2 000 = 1 000 000, tandis que la sortie reste à 3 × 2 000 = 6 000 tokens. Sur DeepSeek-V4-Flash, cela fait $0.0066 par jour sans exemples et $0.0156 avec. Les exemples vous coûtent l'écart entre ces deux nombres, et selon Anthropic ils vous achètent une sortie plus cohérente.
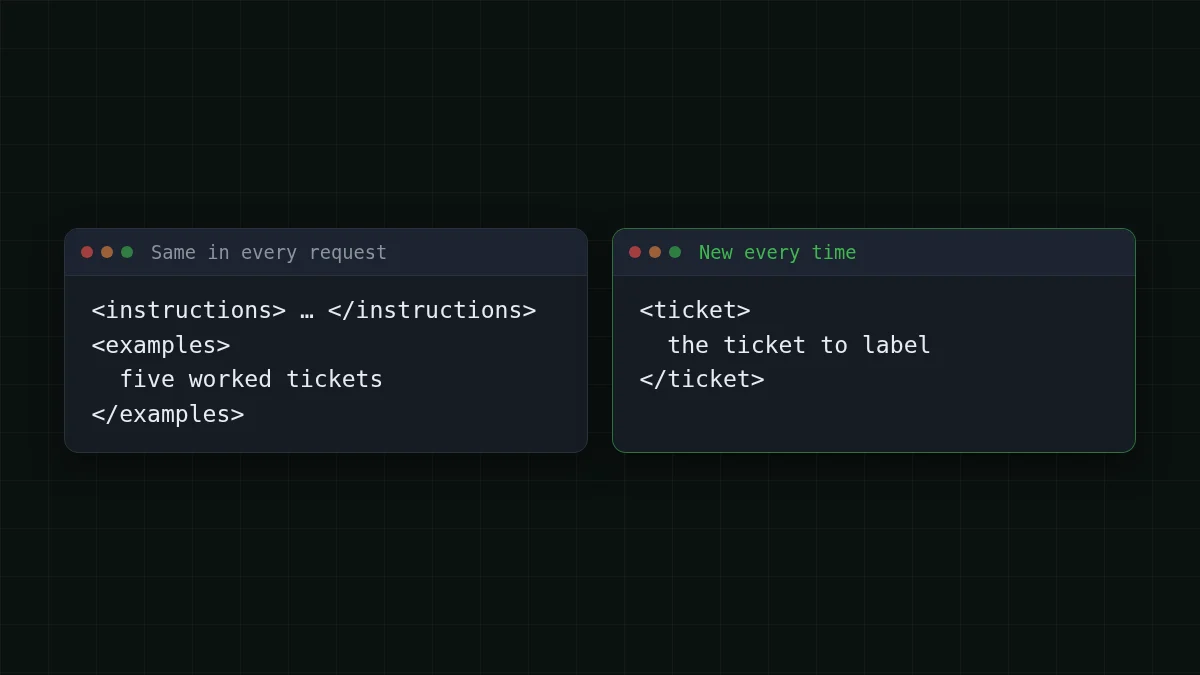
Cette image cache un détail utile. Le bloc d'exemples est identique à chaque requête, ce qui est exactement le type de début répété dont traite le prompt caching ; qu'est-ce que le prompt caching explique comment cela fonctionne.
Voici la même charge, 500 tokens d'entrée et 3 de sortie par requête, 2 000 requêtes, selon les modèles. Le tableau recalcule à partir des prix actuels :
| Modèle | Entrée $/1M | Sortie $/1M | Par requête | 2 000 requêtes | OpenRouter, 2 000 requêtes |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00001 | $0.0202 | $0.034 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0000078 | $0.0156 | $0.0708 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000025 | $0.0509 | $0.611 |
500 tokens d'entrée et 3 tokens de sortie par requête. Les prix par million de tokens sont actuels et évoluent avec nos tarifs ; la colonne OpenRouter indique des prix de référence pour la même charge de travail.
En comptant entrée et sortie ensemble, DeepSeek-V4-Flash et GLM-5.3-Flash reviennent moins cher qu'OpenRouter à cette charge. La liste complète des prix est sur la page de tarification.
JSON, ton, et vérification de vos exemples#
La même astuce couvre les deux autres cas que vous rencontrerez. Besoin des mêmes champs JSON à chaque fois ? Faites de l'exemple la réponse JSON elle-même :
<example>
<ticket>I was charged twice for the same top-up.</ticket>
<output>{"label": "billing", "urgent": true}</output>
</example>
Pour response_format et que faire quand une réponse n'est toujours pas valide, voir obtenir du JSON valide d'une API LLM. Vous voulez réécrire un texte dans un ton donné ? Des adjectifs comme « amical mais bref » sont vagues ; deux paires avant-après le montrent mieux.
Avant de faire confiance à un jeu d'exemples, prenez 20 tickets que vous avez déjà étiquetés à la main, exécutez-les et comparez. Une passe vous en dit plus que n'importe quelle règle. La page d'Anthropic ajoute un raccourci : demandez au modèle de noter vos exemples pour leur pertinence et leur diversité, ou d'en écrire d'autres à partir de ceux que vous avez.
Liste de contrôle
Avant de faire confiance à vos exemples
Une fois les exemples au point, la question suivante est comment éviter que plusieurs documents se brouillent dans un seul prompt. Étiqueter chaque document dans un prompt traite de cela.


