Few-shot prompting: muestra al modelo 3–5 ejemplos para obtener tu formato
Cómo 3–5 ejemplos etiquetados hacen que un modelo responda con tus etiquetas o JSON, con una petición en Python y el coste extra de entrada por petición.
En esta página
Tu bot de tickets debería responder con una sola palabra: billing, bug o other. La mayoría de las respuestas son exactamente eso. Luego llega una como «Label: billing — the customer seems upset about a refund», y el código que lee la etiqueta se atasca.
La solución habitual no es una instrucción más larga. Son unos pocos ejemplos: pon 3–5 tickets terminados con sus etiquetas en el prompt, y el modelo copia el patrón. Eso es el few-shot prompting. La guía de prompting de Anthropic (sección «Use examples effectively», consultada el 3 de noviembre de 2026) llama a los ejemplos una de las formas más fiables de dirigir el formato, el tono y la estructura, y recomienda 3–5. La pega: cada ejemplo es entrada que vuelves a pagar en cada petición. La sección de costes de abajo lo calcula para un bot que gestiona 2.000 tickets al día.
Qué significa «few-shot»#
Imagina a un compañero nuevo en su primer día en el mostrador de soporte. Le dices «etiqueta cada ticket como billing, bug u other» y te vas. Algunas etiquetas coincidirán con tu idea, otras no. Ahora déjale tres tickets ya etiquetados y dile «como estos». El mismo compañero, muchas menos sorpresas.
Los modelos se comportan igual. Solo con instrucción se llama zero-shot. Instrucción más varios ejemplos resueltos es few-shot (la página de Anthropic también dice multishot). Un «shot» es simplemente un ejemplo.
Comparar
La misma tarea, dos prompts
Solo instrucción
Label the support ticket as billing, bug or other.Instrucción más ejemplos
Label the support ticket with one word: billing, bug or other.

Ticket: I was charged twice for one top-up.
Label: billing

Ticket: The export button does nothing.
Label: bug

Ticket: Do you have a dark theme?
Label: other
El segundo prompt nunca explica qué significa billing. Los ejemplos lo hacen mostrando, y arrastran el formato junto con el significado. Una línea explícita de instrucción tampoco viene mal, así que la versión de abajo la mantiene.
Tres reglas para ejemplos que funcionan#
La página de Anthropic resume los buenos ejemplos en tres palabras:
- Relevantes: cercanos a los tickets que realmente recibes, no a otra tarea.
- Diversos: cubren casos límite y difieren entre sí, para que el modelo no se aferre a un patrón accidental.
- Estructurados: envueltos en etiquetas (
<example>, y varias dentro de<examples>) para que el modelo distinga ejemplos de instrucciones. La misma página dice que mantengas los nombres de las etiquetas consistentes.
Aquí tienes un prompt completo construido así. Guárdalo como prompt.txt:
<instructions>
Label the support ticket with exactly one word: billing, bug or other.
Reply with the label only.
</instructions>

<examples>
<example>
<ticket>I was charged twice for the same top-up.</ticket>
<label>billing</label>
</example>
<example>
<ticket>The export button does nothing when I click it.</ticket>
<label>bug</label>
</example>
<example>
<ticket>Do you have a dark theme?</ticket>
<label>other</label>
</example>
<example>
<ticket>Please refund me. Also, the page crashes on login.</ticket>
<label>billing</label>
</example>
<example>
<ticket>Is there an API for exporting reports?</ticket>
<label>other</label>
</example>
</examples>
Fíjate en el cuarto ejemplo: una solicitud de reembolso que también menciona un fallo. Una instrucción no puede resolver un ticket mixto, un ejemplo sí. Aquí gana el dinero, así que la etiqueta es billing. Sea cual sea la regla que elijas, muéstrala una vez.
Emparejar los pares
¿Qué regla se incumple?
Toca un elemento de la izquierda, luego su par
- Tus ejemplos son saludos de chat de una línea, pero los tickets reales son correos largosNo relevantes: los ejemplos deben parecerse a la tarea real
- Todos tus ejemplos llevan la misma etiquetaNo diversos: el modelo puede captar un patrón accidental
- Los ejemplos están pegados como texto suelto entre las instruccionesNo estructurados: envuélvelos en etiquetas para que no se confundan con instrucciones
Envíalo a través de la API#
El prompt es el mismo texto en cada petición, y solo cambia el ticket nuevo. Cada ticket pasa por el mismo viaje corto:
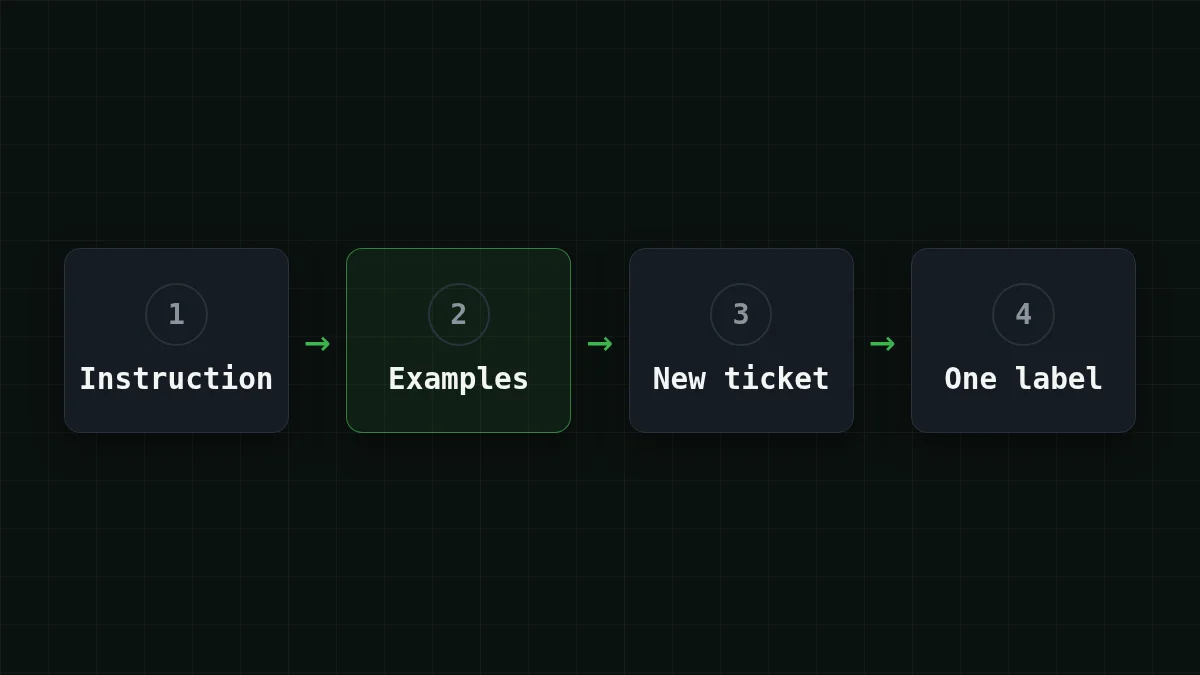
Aquí está en Python con el paquete openai. La dirección es la API de CheapTokens, la clave está en una variable de entorno (mira cómo guardar una clave de forma segura), y el id del modelo es el completo de la documentación:
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)

PROMPT = open("prompt.txt", encoding="utf-8").read()


def label(ticket: str) -> str:
    response = client.chat.completions.create(
        model="deepseek-ai/DeepSeek-V4-Flash-0731",
        max_tokens=64,
        messages=[
            {"role": "system", "content": PROMPT},
            {"role": "user", "content": f"<ticket>{ticket}</ticket>"},
        ],
    )
    print(response.usage.prompt_tokens, response.usage.completion_tokens)
    return response.choices[0].message.content.strip()


print(label("The app shows a blank screen after the update."))
Cuando funciona ves dos recuentos de tokens en una línea y luego la etiqueta en sí, una palabra como bug. Si recibes una frase, los ejemplos aún no hacen su trabajo: revisa las etiquetas y que cada etiqueta de tu esquema aparezca al menos una vez.
El primer número es el que hay que vigilar. Es todo el prompt, instrucciones más ejemplos más el ticket, y crece con cada ejemplo que añades. Ejecuta el script una vez con el prompt.txt completo y otra solo con la parte de <instructions>: la diferencia entre los dos primeros números es lo que cuestan tus ejemplos por petición.
DeepSeek-V4-Flash encaja para este tipo de etiquetado masivo: un precio a cualquier hora del día, un contexto de 380K tokens (así un bloque largo de ejemplos cabe sin problema) y hasta 32.768 tokens por respuesta. GLM-5.3-Flash, con un contexto de 390K, también sirve para tareas cortas de etiquetado. Ambos están en la página de modelos, detrás de un único saldo.
Qué añaden cinco ejemplos a la factura#
Digamos que el bot gestiona 2.000 tickets al día. Supón que un ticket son unos 120 tokens y la instrucción unos 80, así que una petición sin ejemplos son 80 + 120 = 200 tokens de entrada. Cinco ejemplos de unos 60 tokens cada uno añaden 5 × 60 = 300, así que una petición con ellos son 200 + 300 = 500. La respuesta es una palabra, pongamos 3 tokens de salida en ambos casos. Son suposiciones: sustituye el prompt_tokens que imprimió tu script.
A lo largo de un día, 200 × 2.000 = 400.000 tokens de entrada pasan a 500 × 2.000 = 1.000.000, mientras que la salida se queda en 3 × 2.000 = 6.000 tokens. En DeepSeek-V4-Flash eso es $0.0066 al día sin ejemplos y $0.0156 con ellos. Los ejemplos te cuestan la diferencia entre esos dos números, y según Anthropic te compran una salida más consistente.
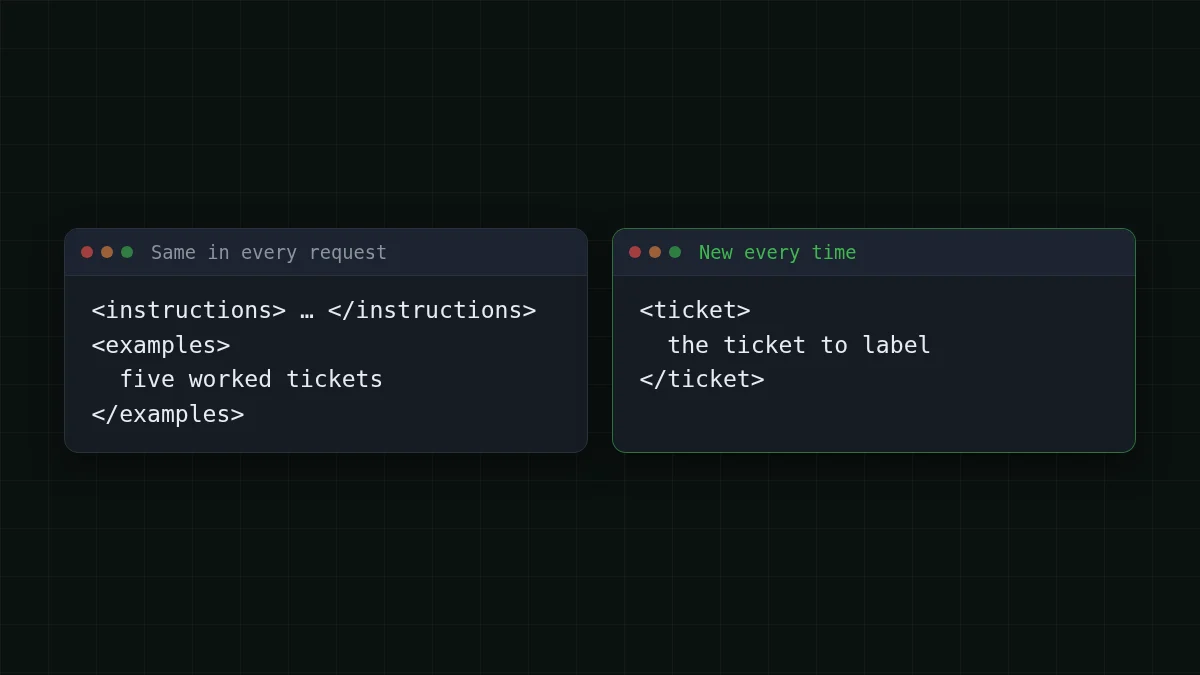
Esa imagen esconde un detalle útil. El bloque de ejemplos es idéntico en cada petición, que es justo el tipo de inicio repetido del que trata el prompt caching; qué es el prompt caching explica cómo funciona.
Aquí está la misma carga, 500 tokens de entrada y 3 de salida por petición, 2.000 peticiones, en varios modelos. La tabla se recalcula con los precios actuales:
| Modelo | Entrada $/1M | Salida $/1M | Por solicitud | 2000 solicitudes | OpenRouter, 2000 solicitudes |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00001 | $0.0202 | $0.034 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0000078 | $0.0156 | $0.0708 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000025 | $0.0509 | $0.611 |
500 tokens de entrada y 3 tokens de salida por solicitud. Los precios por 1M de tokens son actuales y cambian junto con nuestras tarifas; la columna de OpenRouter muestra precios de referencia para la misma carga de trabajo.
Contando entrada y salida juntas, DeepSeek-V4-Flash y GLM-5.3-Flash salen más baratos que OpenRouter con esta carga. La lista completa de precios está en la página de precios.
JSON, tono y comprobar tus ejemplos#
El mismo truco cubre los otros dos casos que te encontrarás. ¿Necesitas los mismos campos JSON siempre? Haz que el ejemplo responda el propio JSON:
<example>
<ticket>I was charged twice for the same top-up.</ticket>
<output>{"label": "billing", "urgent": true}</output>
</example>
Para response_format y qué hacer cuando una respuesta sigue sin ser válida, mira obtener JSON válido de una API de LLM. ¿Quieres reescribir texto en un tono concreto? Adjetivos como «amable pero breve» son vagos; dos pares de antes y después lo muestran mejor.
Antes de fiarte de cualquier conjunto de ejemplos, coge 20 tickets que ya hayas etiquetado a mano, pásalos y compara. Una pasada te dice más que cualquier regla. La página de Anthropic añade un atajo: pide al modelo que puntúe tus ejemplos por relevancia y diversidad, o que escriba más a partir de los que tienes.
Lista de verificación
Antes de fiarte de tus ejemplos
Una vez que los ejemplos funcionan, la siguiente pregunta es cómo evitar que varios documentos se mezclen en un solo prompt. Etiqueta cada documento en un prompt lo cubre.


