AI สำหรับผู้เริ่มต้นคู่มือ
Few-shot prompting: แสดงตัวอย่าง 3–5 ตัวให้โมเดลเพื่อให้ได้รูปแบบที่ต้องการ
ตัวอย่างที่มีแท็ก 3–5 ตัวทำให้โมเดลตอบด้วยป้ายกำกับหรือ JSON ของคุณอย่างไร พร้อมคำขอ Python และต้นทุนอินพุตเพิ่มต่อคำขอ
ในหน้านี้
บอทจัดการตั๋วของคุณควรตอบด้วยคำเดียว: billing, bug หรือ other คำตอบส่วนใหญ่เป็นเช่นนั้นจริง ๆ แล้วก็มีข้อความหนึ่งเข้ามาเป็น “Label: billing — the customer seems upset about a refund” และโค้ดที่อ่านป้ายกำกับก็พัง
วิธีแก้ปกติไม่ใช่คำสั่งที่ยาวขึ้น แต่คือตัวอย่างสองสามตัว: ใส่ตั๋วที่จัดการเสร็จแล้ว 3–5 ใบพร้อมป้ายกำกับลงในพรอมป์ต แล้วโมเดลจะลอกเลียนแบบแผน นั่นคือ few-shot prompting คู่มือการเขียนพรอมป์ต ของ Anthropic (หัวข้อ “Use examples effectively”, ตรวจสอบเมื่อ 3 พฤศจิกายน 2026) เรียกตัวอย่างว่าเป็นหนึ่งในวิธีที่เชื่อถือได้ที่สุดในการกำหนดรูปแบบ น้ำเสียง และโครงสร้าง และแนะนำให้ใช้ 3–5 ตัวอย่าง ข้อควรระวัง: ทุกตัวอย่างคืออินพุตที่คุณจ่ายซ้ำในทุกคำขอ ส่วนต้นทุนด้านล่างคำนวณสำหรับบอทที่จัดการตั๋ว 2,000 ใบต่อวัน
“Few-shot” หมายถึงอะไร#
ลองนึกถึงเพื่อนร่วมงานใหม่ในวันแรกที่โต๊ะซัพพอร์ต คุณบอกว่า “ติดป้ายแต่ละตั๋วเป็น billing, bug หรือ other” แล้วก็เดินจากไป ป้ายบางอันจะตรงกับที่คุณคิด บางอันก็ไม่ ตอนนี้ลองทิ้งตั๋วที่ติดป้ายแล้วสามใบไว้และบอกว่า “เหมือนพวกนี้” เพื่อนร่วมงานคนเดิม เซอร์ไพรส์น้อยลงมาก
โมเดลก็ทำงานแบบเดียวกัน คำสั่งอย่างเดียวเรียกว่า zero-shot คำสั่งพร้อมตัวอย่างที่ทำเสร็จแล้วหลายตัวเรียกว่า few-shot (หน้าของ Anthropic ยังเรียกอีกชื่อว่า multishot) “shot” ก็แค่ตัวอย่างหนึ่งตัว
เปรียบเทียบ
งานเดียวกัน สองพรอมป์ต
คำสั่งอย่างเดียว
Label the support ticket as billing, bug or other.คำสั่งพร้อมตัวอย่าง
Label the support ticket with one word: billing, bug or other.

Ticket: I was charged twice for one top-up.
Label: billing

Ticket: The export button does nothing.
Label: bug

Ticket: Do you have a dark theme?
Label: other
พรอมป์ตที่สองไม่เคยอธิบายว่า billing หมายถึงอะไร ตัวอย่างทำหน้าที่นั้นด้วยการแสดงให้เห็น และพารูปแบบมาพร้อมความหมาย การมีคำสั่งชัดเจนหนึ่งบรรทัดก็ยังไม่เสียหาย เวอร์ชันด้านล่างจึงเก็บไว้
สามกฎสำหรับตัวอย่างที่ได้ผล#
หน้าของ Anthropic สรุปตัวอย่างที่ดีไว้สามคำ:
- เกี่ยวข้อง: ใกล้เคียงกับตั๋วที่คุณได้รับจริง ไม่ใช่กับงานอื่น
- หลากหลาย: ครอบคลุมกรณีขอบและแตกต่างกัน เพื่อไม่ให้โมเดลจับรูปแบบที่บังเอิญ
- มีโครงสร้าง: ห่อด้วยแท็ก (
<example>และหลายอันภายใน<examples>) เพื่อให้โมเดลแยกตัวอย่างออกจากคำสั่งได้ หน้าเดียวกันยังบอกให้ใช้ชื่อแท็กให้สอดคล้องกัน
นี่คือพรอมป์ตเต็มที่สร้างตามวิธีนั้น บันทึกเป็น prompt.txt:
<instructions>
Label the support ticket with exactly one word: billing, bug or other.
Reply with the label only.
</instructions>

<examples>
<example>
<ticket>I was charged twice for the same top-up.</ticket>
<label>billing</label>
</example>
<example>
<ticket>The export button does nothing when I click it.</ticket>
<label>bug</label>
</example>
<example>
<ticket>Do you have a dark theme?</ticket>
<label>other</label>
</example>
<example>
<ticket>Please refund me. Also, the page crashes on login.</ticket>
<label>billing</label>
</example>
<example>
<ticket>Is there an API for exporting reports?</ticket>
<label>other</label>
</example>
</examples>
ดูตัวอย่างที่สี่: คำขอคืนเงินที่พูดถึงการแครชด้วย คำสั่งไม่สามารถตัดสินตั๋วแบบผสมได้ แต่ตัวอย่างทำได้ ที่นี่เรื่องเงินชนะ ป้ายกำกับจึงเป็น billing ไม่ว่าคุณจะเลือกกฎไหน แสดงมันสักครั้ง
จับคู่
กฎข้อไหนถูกละเมิด?
แตะรายการทางซ้าย แล้วแตะคู่ของมัน
- ตัวอย่างของคุณเป็นคำทักทายแชทบรรทัดเดียว แต่ตั๋วจริงเป็นอีเมลยาวไม่เกี่ยวข้อง: ตัวอย่างต้องใกล้เคียงกับงานจริง
- ตัวอย่างทั้งหมดของคุณมีป้ายกำกับเดียวกันไม่หลากหลาย: โมเดลอาจจับรูปแบบที่บังเอิญ
- ตัวอย่างถูกวางเป็นข้อความลอย ๆ ระหว่างคำสั่งไม่มีโครงสร้าง: ห่อด้วยแท็กเพื่อไม่ให้ถูกเข้าใจผิดว่าเป็นคำสั่ง
ส่งผ่าน API#
พรอมป์ตเป็นข้อความเดียวกันในทุกคำขอ และมีเพียงตั๋วใหม่ที่เปลี่ยน แต่ละตั๋วผ่านเส้นทางสั้น ๆ เดียวกัน:
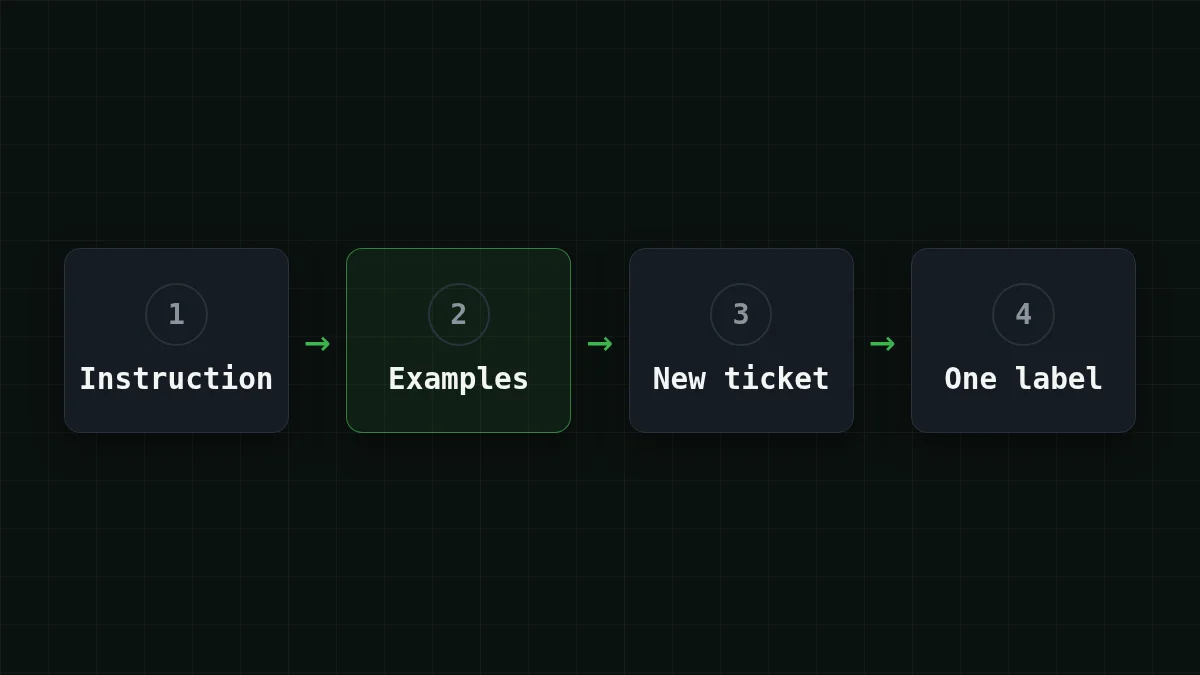
นี่คือใน Python ด้วยแพ็กเกจ openai ที่อยู่คือ CheapTokens API คีย์อยู่ในตัวแปรสภาพแวดล้อม (ดู วิธีเก็บคีย์อย่างปลอดภัย) และ id โมเดลเป็นแบบเต็มจาก เอกสาร:
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)

PROMPT = open("prompt.txt", encoding="utf-8").read()


def label(ticket: str) -> str:
    response = client.chat.completions.create(
        model="deepseek-ai/DeepSeek-V4-Flash-0731",
        max_tokens=64,
        messages=[
            {"role": "system", "content": PROMPT},
            {"role": "user", "content": f"<ticket>{ticket}</ticket>"},
        ],
    )
    print(response.usage.prompt_tokens, response.usage.completion_tokens)
    return response.choices[0].message.content.strip()


print(label("The app shows a blank screen after the update."))
เมื่อทำงานได้ คุณจะเห็นจำนวนโทเคนสองจำนวนในบรรทัดเดียว แล้วตามด้วยป้ายกำกับเอง หนึ่งคำเช่น bug ถ้าคุณได้ประโยคแทน แสดงว่าตัวอย่างยังทำหน้าที่ไม่ดี: ตรวจสอบแท็กและให้แน่ใจว่าทุกป้ายจากชุดของคุณปรากฏอย่างน้อยหนึ่งครั้ง
ตัวเลขแรกคือตัวที่ต้องจับตา มันคือพรอมป์ตทั้งหมด คำสั่งบวกตัวอย่างบวกตั๋ว และมันโตขึ้นทุกตัวอย่างที่คุณเพิ่ม รันสคริปต์หนึ่งครั้งด้วย prompt.txt เต็ม และอีกครั้งด้วยเฉพาะส่วน <instructions>: ช่องว่างระหว่างตัวเลขแรกสองตัวคือต้นทุนตัวอย่างต่อคำขอ
DeepSeek-V4-Flash เหมาะกับการติดป้ายจำนวนมากแบบนี้: ราคาเดียวทุกช่วงเวลา คอนเท็กซ์ 380K โทเคน (บล็อกตัวอย่างยาวจึงใส่ได้สบาย) และสูงสุด 32,768 โทเคนต่อคำตอบ GLM-5.3-Flash ที่มีคอนเท็กซ์ 390K ก็ใช้กับงานติดป้ายสั้น ๆ ได้เช่นกัน ทั้งคู่อยู่บน หน้ารุ่นโมเดล ภายใต้ยอดเงินเดียว
ห้าตัวอย่างเพิ่มอะไรให้บิล#
สมมติบอทจัดการตั๋ว 2,000 ใบต่อวัน สมมติตั๋วประมาณ 120 โทเคนและคำสั่งประมาณ 80 ดังนั้นคำขอที่ไม่มีตัวอย่างคือ 80 + 120 = 200 อินพุตโทเคน ห้าตัวอย่างที่ประมาณ 60 โทเคนแต่ละตัวเพิ่ม 5 × 60 = 300 ดังนั้นคำขอที่มีตัวอย่างคือ 200 + 300 = 500 คำตอบเป็นหนึ่งคำ เรียกได้ว่า 3 เอาต์พุตโทเคนทั้งสองกรณี นี่คือสมมติฐาน: เปลี่ยนเป็น prompt_tokens ที่สคริปต์ของคุณพิมพ์ออกมา
ตลอดหนึ่งวัน 200 × 2,000 = 400,000 อินพุตโทเคนกลายเป็น 500 × 2,000 = 1,000,000 ขณะที่เอาต์พุตคงอยู่ที่ 3 × 2,000 = 6,000 โทเคน บน DeepSeek-V4-Flash นั่นคือ $0.0066 ต่อวันโดยไม่มีตัวอย่าง และ $0.0156 เมื่อมี ตัวอย่างทำให้คุณเสียช่องว่างระหว่างสองตัวเลขนั้น และตาม Anthropic มันให้เอาต์พุตที่สอดคล้องกันมากขึ้น
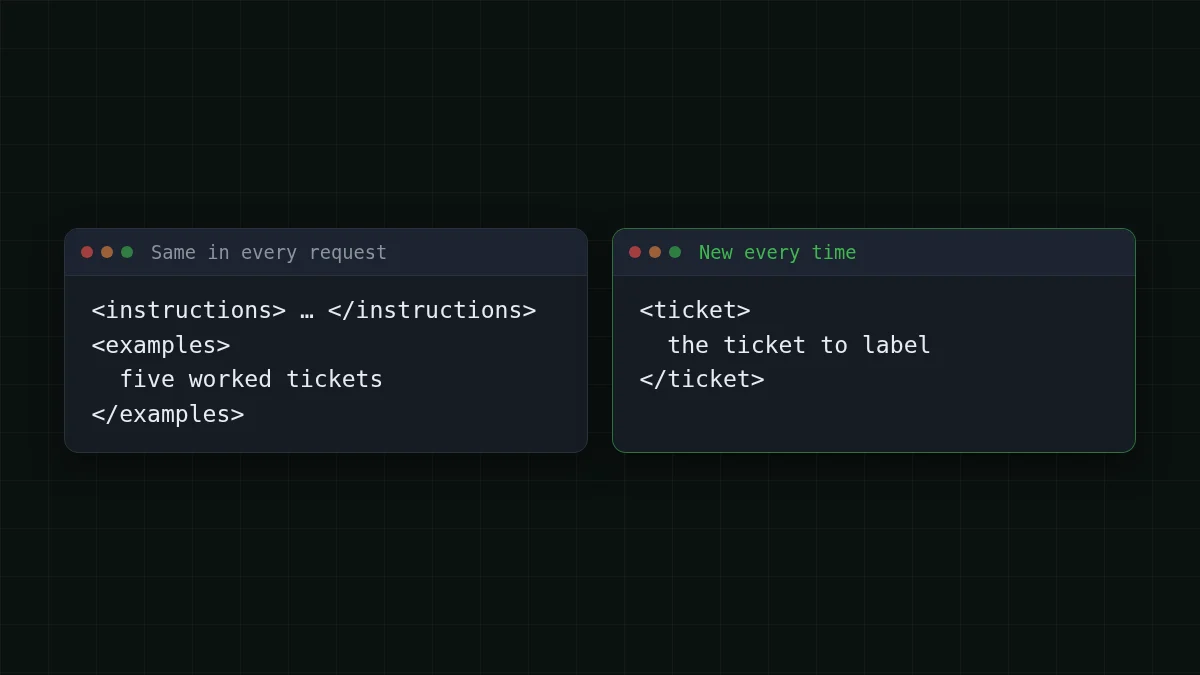
ภาพนั้นซ่อนรายละเอียดที่มีประโยชน์ บล็อกตัวอย่างเหมือนกันทุกคำขอ ซึ่งเป็นจุดเริ่มต้นซ้ำแบบที่ prompt caching พูดถึงพอดี prompt caching คืออะไร อธิบายว่ามันทำงานอย่างไร
นี่คือโหลดเดียวกัน 500 อินพุตและ 3 เอาต์พุตโทเคนต่อคำขอ 2,000 คำขอ ข้ามรุ่นโมเดล ตารางคำนวณใหม่จากราคาปัจจุบัน:
| โมเดล | Input $/1M | Output $/1M | ต่อคำขอ | 2,000 คำขอ | OpenRouter, 2,000 คำขอ |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00001 | $0.0202 | $0.034 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0000078 | $0.0156 | $0.0708 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000025 | $0.0509 | $0.611 |
500 โทเค็นอินพุตและ 3 โทเค็นเอาต์พุตต่อคำขอ ราคาต่อ 1M โทเค็นเป็นราคาปัจจุบันและเปลี่ยนแปลงไปพร้อมกับอัตราค่าบริการของเรา คอลัมน์ OpenRouter แสดงราคาอ้างอิงสำหรับปริมาณงานเดียวกัน
เมื่อนับอินพุตและเอาต์พุตรวมกัน DeepSeek-V4-Flash และ GLM-5.3-Flash ออกมา cheaper กว่า OpenRouter ที่โหลดนี้ รายการราคาเต็มอยู่บน หน้าราคา
JSON น้ำเสียง และการตรวจสอบตัวอย่าง#
กลเม็ดเดียวกันครอบคลุมอีกสองกรณีที่คุณจะเจอ ต้องการฟิลด์ JSON เดิมทุกครั้งไหม? ทำให้คำตอบตัวอย่างเป็น JSON เอง:
<example>
<ticket>I was charged twice for the same top-up.</ticket>
<output>{"label": "billing", "urgent": true}</output>
</example>
สำหรับ response_format และสิ่งที่ต้องทำเมื่อคำตอบยังไม่ถูกต้อง ดู รับ JSON ที่ถูกต้องจาก LLM API ต้องการให้ข้อความเขียนใหม่ในน้ำเสียงเดียว? คำคุณศัพท์อย่าง “เป็นมิตรแต่กระชับ” คลุมเครือ คู่ก่อน-หลังสองคู่แสดงได้ดีกว่า
ก่อนที่คุณจะเชื่อตัวอย่างชุดใดก็ตาม เอา 20 ตั๋วที่คุณติดป้ายด้วยมือแล้ว รันและเปรียบเทียบ รอบเดียวบอกคุณได้มากกว่ากฎใด ๆ หน้าของ Anthropic เพิ่มทางลัด: ขอให้โมเดลให้คะแนนตัวอย่างของคุณด้านความเกี่ยวข้องและความหลากหลาย หรือเขียนเพิ่มจากที่มีอยู่
เช็กลิสต์
ก่อนที่คุณจะเชื่อตัวอย่าง
เมื่อตัวอย่างทำงานได้ คำถามถัดไปคือทำอย่างไรไม่ให้เอกสารหลายชิ้นปนกันในพรอมป์ตเดียว ติดป้ายทุกเอกสารในพรอมป์ต ครอบคลุมเรื่องนั้น


