Few-shot prompting: mostre 3–5 exemplos ao modelo para obter seu formato
Como 3–5 exemplos com tags fazem um modelo responder com seus rótulos ou JSON, com uma requisição em Python e o custo extra de entrada por requisição.
Nesta página
Seu bot de tickets deve responder com uma palavra: billing, bug ou other. A maioria das respostas é exatamente isso. Aí chega uma como “Label: billing — the customer seems upset about a refund”, e o código que lê o rótulo engasga.
A correção habitual não é uma instrução mais longa. São alguns exemplos: coloque 3–5 tickets finalizados com seus rótulos no prompt, e o modelo copia o padrão. Isso é few-shot prompting. O guia de prompting da Anthropic (seção “Use examples effectively”, verificado em 3 de novembro de 2026) chama os exemplos de uma das formas mais confiáveis de direcionar formato, tom e estrutura, e recomenda 3–5 deles. O problema: cada exemplo é entrada pela qual você paga de novo a cada requisição. A seção de custos abaixo calcula isso para um bot que processa 2.000 tickets por dia.
O que significa “few-shot”#
Imagine um colega novo no primeiro dia no suporte. Você diz “classifique cada ticket como billing, bug ou other” e vai embora. Alguns rótulos vão bater com a sua ideia, outros não. Agora deixe três tickets já rotulados e diga “como estes”. Mesmo colega, muito menos surpresas.
Modelos se comportam do mesmo jeito. Só instrução é chamado de zero-shot. Instrução mais vários exemplos resolvidos é few-shot (a página da Anthropic também diz multishot). Um “shot” é apenas um exemplo.
Comparar
Mesma tarefa, dois prompts
Só instrução
Label the support ticket as billing, bug or other.Instrução mais exemplos
Label the support ticket with one word: billing, bug or other.

Ticket: I was charged twice for one top-up.
Label: billing

Ticket: The export button does nothing.
Label: bug

Ticket: Do you have a dark theme?
Label: other
O segundo prompt nunca explica o que billing significa. Os exemplos fazem isso mostrando, e carregam o formato junto com o significado. Uma linha explícita de instrução ainda não atrapalha, então a versão abaixo a mantém.
Três regras para exemplos que funcionam#
A página da Anthropic resume bons exemplos em três palavras:
- Relevantes: próximos dos tickets que você realmente recebe, não de alguma outra tarefa.
- Diversos: cobrem casos de borda e diferem entre si, para o modelo não se apegar a um padrão acidental.
- Estruturados: envolvidos em tags (
<example>, e vários dentro de<examples>) para o modelo distinguir exemplos de instruções. A mesma página diz para manter os nomes das tags consistentes.
Aqui está um prompt completo construído assim. Salve como prompt.txt:
<instructions>
Label the support ticket with exactly one word: billing, bug or other.
Reply with the label only.
</instructions>

<examples>
<example>
<ticket>I was charged twice for the same top-up.</ticket>
<label>billing</label>
</example>
<example>
<ticket>The export button does nothing when I click it.</ticket>
<label>bug</label>
</example>
<example>
<ticket>Do you have a dark theme?</ticket>
<label>other</label>
</example>
<example>
<ticket>Please refund me. Also, the page crashes on login.</ticket>
<label>billing</label>
</example>
<example>
<ticket>Is there an API for exporting reports?</ticket>
<label>other</label>
</example>
</examples>
Veja o quarto exemplo: um pedido de reembolso que também menciona um crash. Uma instrução não resolve um ticket misto, um exemplo resolve. Aqui o dinheiro vence, então o rótulo é billing. Qualquer regra que você escolher, mostre-a uma vez.
Emparelhar os pares
Qual regra está sendo quebrada?
Toque num item à esquerda, depois no seu par
- Seus exemplos são saudações de chat de uma linha, mas os tickets reais são e-mails longosNão relevantes: os exemplos devem ser próximos da tarefa real
- Todos os seus exemplos têm o mesmo rótuloNão diversos: o modelo pode captar um padrão acidental
- Os exemplos são colados como texto solto entre as instruçõesNão estruturados: envolva-os em tags para não serem confundidos com instruções
Envie pela API#
O prompt é o mesmo texto em toda requisição, e só o novo ticket muda. Cada ticket passa pelo mesmo trajeto curto:
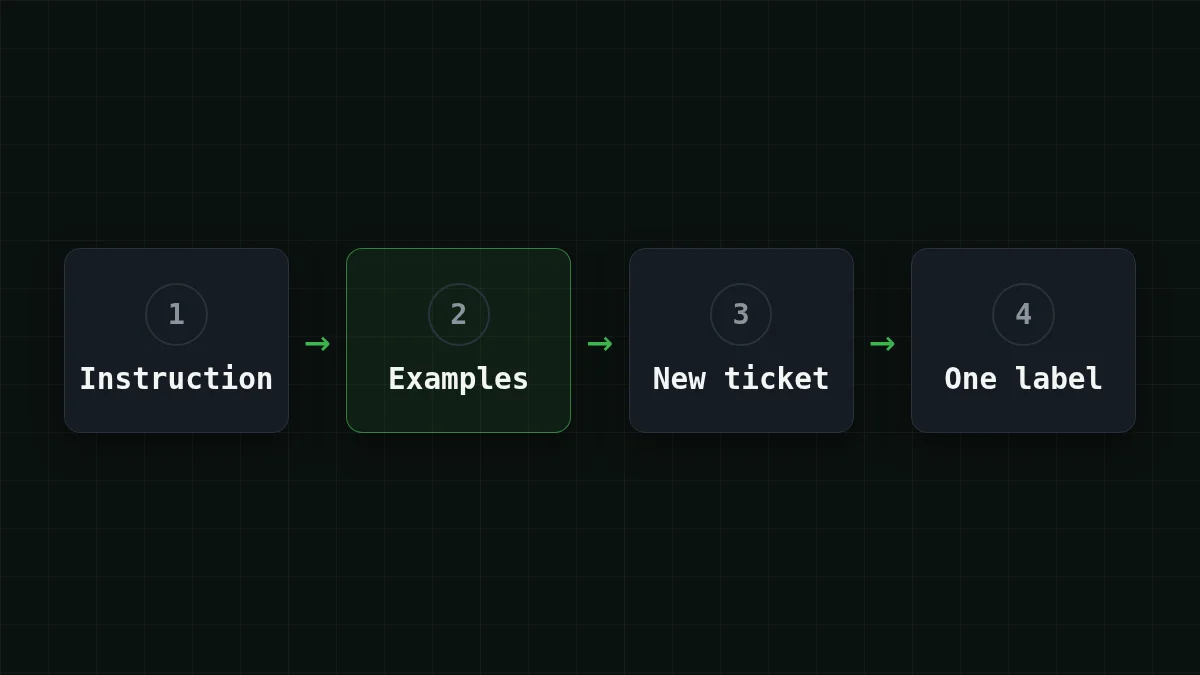
Aqui está em Python com o pacote openai. O endereço é a API da CheapTokens, a chave fica em uma variável de ambiente (veja como armazenar uma chave com segurança), e o id do modelo é o completo da documentação:
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)

PROMPT = open("prompt.txt", encoding="utf-8").read()


def label(ticket: str) -> str:
    response = client.chat.completions.create(
        model="deepseek-ai/DeepSeek-V4-Flash-0731",
        max_tokens=64,
        messages=[
            {"role": "system", "content": PROMPT},
            {"role": "user", "content": f"<ticket>{ticket}</ticket>"},
        ],
    )
    print(response.usage.prompt_tokens, response.usage.completion_tokens)
    return response.choices[0].message.content.strip()


print(label("The app shows a blank screen after the update."))
Quando funciona, você vê duas contagens de tokens em uma linha e depois o próprio rótulo, uma palavra como bug. Se vier uma frase, os exemplos ainda não estão fazendo o trabalho: confira as tags e se cada rótulo do seu esquema aparece pelo menos uma vez.
O primeiro número é o que importa. É o prompt inteiro, instruções mais exemplos mais o ticket, e cresce a cada exemplo que você adiciona. Rode o script uma vez com o prompt.txt completo e uma vez só com a parte <instructions>: a diferença entre os dois primeiros números é o que seus exemplos custam por requisição.
O DeepSeek-V4-Flash serve para esse tipo de rotulagem em massa: um preço a qualquer hora do dia, contexto de 380K tokens (então um bloco longo de exemplos cabe facilmente) e até 32.768 tokens por resposta. O GLM-5.3-Flash, com contexto de 390K, também funciona para tarefas curtas de rotulagem. Ambos estão na página de modelos, atrás de um único saldo.
O que cinco exemplos acrescentam à conta#
Digamos que o bot processe 2.000 tickets por dia. Suponha que um ticket tenha cerca de 120 tokens e a instrução cerca de 80, então uma requisição sem exemplos tem 80 + 120 = 200 tokens de entrada. Cinco exemplos de cerca de 60 tokens cada acrescentam 5 × 60 = 300, então uma requisição com eles tem 200 + 300 = 500. A resposta é uma palavra, digamos 3 tokens de saída nos dois casos. São suposições: troque pelo prompt_tokens que seu script imprimiu.
Ao longo de um dia, 200 × 2.000 = 400.000 tokens de entrada viram 500 × 2.000 = 1.000.000, enquanto a saída fica em 3 × 2.000 = 6.000 tokens. No DeepSeek-V4-Flash isso é $0.0066 por dia sem exemplos e $0.0156 com eles. Os exemplos custam a diferença entre esses dois números, e segundo a Anthropic eles compram uma saída mais consistente.
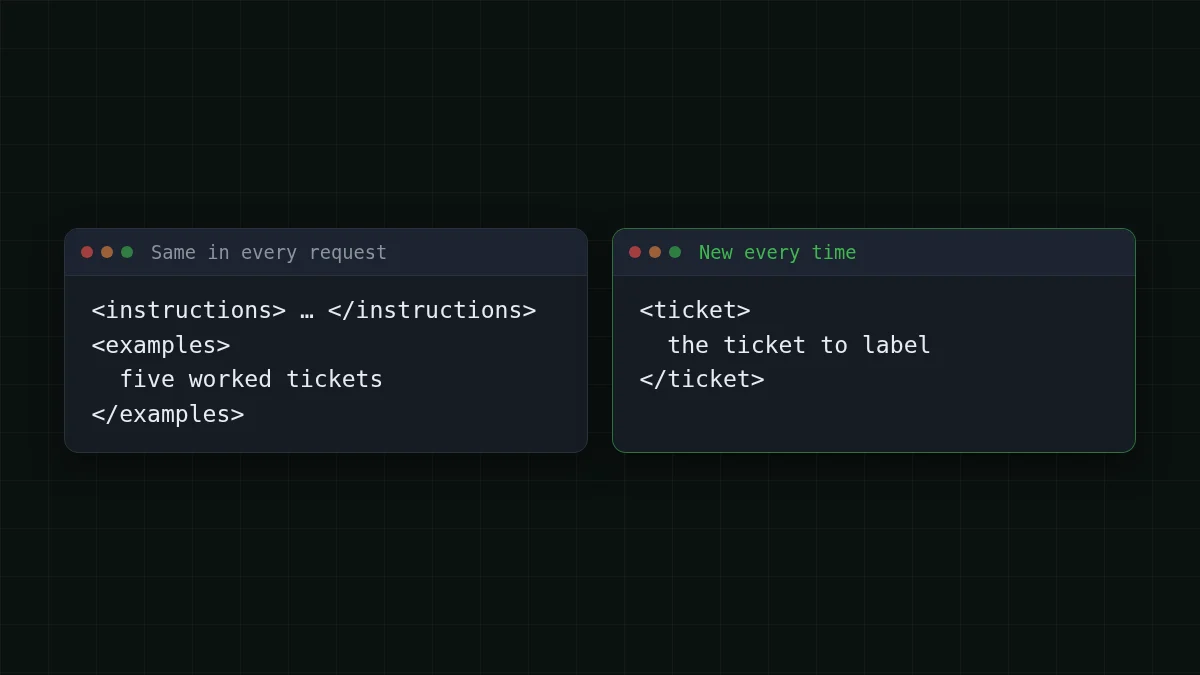
Essa imagem esconde um detalhe útil. O bloco de exemplos é idêntico em toda requisição, que é exatamente o tipo de início repetido do qual trata o prompt caching; o que é prompt caching explica como isso funciona.
Aqui está a mesma carga, 500 tokens de entrada e 3 de saída por requisição, 2.000 requisições, entre modelos. A tabela recalcula com os preços atuais:
| Modelo | Entrada $/1M | Saída $/1M | Por solicitação | 2.000 solicitações | OpenRouter, 2.000 solicitações |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00001 | $0.0202 | $0.034 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0000078 | $0.0156 | $0.0708 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000025 | $0.0509 | $0.611 |
500 tokens de entrada e 3 tokens de saída por solicitação. Os preços por 1M de tokens são atuais e mudam junto com nossas tarifas; a coluna OpenRouter mostra preços de referência para a mesma carga de trabalho.
Com entrada e saída contadas juntas, DeepSeek-V4-Flash e GLM-5.3-Flash saem mais baratos que o OpenRouter nessa carga. A lista completa de preços está na página de preços.
JSON, tom e a verificação dos seus exemplos#
O mesmo truque cobre os outros dois casos que você vai encontrar. Precisa dos mesmos campos JSON toda vez? Faça o exemplo responder o próprio JSON:
<example>
<ticket>I was charged twice for the same top-up.</ticket>
<output>{"label": "billing", "urgent": true}</output>
</example>
Para response_format e o que fazer quando uma resposta ainda não é válida, veja obtenha JSON válido de uma API de LLM. Quer texto reescrito em um tom? Adjetivos como “amigável mas breve” são vagos; dois pares de antes e depois mostram melhor.
Antes de confiar em qualquer conjunto de exemplos, pegue 20 tickets que você já rotulou à mão, rode-os e compare. Uma passada diz mais que qualquer regra. A página da Anthropic acrescenta um atalho: peça ao modelo para avaliar seus exemplos quanto a relevância e diversidade, ou para escrever mais a partir dos que você tem.
Lista de verificação
Antes de confiar nos seus exemplos
Depois que os exemplos funcionam, a próxima pergunta é como evitar que vários documentos se misturem em um prompt. Rotule cada documento em um prompt cobre isso.


