AI 入门指南
少样本提示:给模型看 3–5 个示例,得到你的格式
3–5 个带标签的示例如何让模型用你的标签或 JSON 回答,附 Python 请求和每次请求的额外输入成本。
你的工单机器人应该只用一个词回答:billing、bug 或 other。大多数回复正是如此。然后来了一条“Label: billing — the customer seems upset about a refund”,读取标签的代码就卡住了。
通常的解决办法不是写更长的指令,而是给几个示例:把 3–5 个已完成的工单连同标签放进提示词,模型就会照搬这个模式。这就是少样本提示。Anthropic 的提示词指南(“Use examples effectively”一节,2026 年 11 月 3 日查阅)称示例是引导格式、语气和结构最可靠的方法之一,并建议使用 3–5 个。问题在于:每个示例都是你每次请求都要重复付费的输入。下面的成本部分按一个每天处理 2,000 张工单的机器人来算。
“少样本”是什么意思#
想象一位新同事第一天到客服台上班。你说“把每张工单标成 billing、bug 或 other”,然后就走开了。有些标签会符合你的想法,有些不会。现在留下三张已经标好的工单,说“就像这些”。同一个人,意外会少得多。
模型的行为也一样。只有指令叫零样本。指令加几个示范示例叫少样本(Anthropic 的页面也写作 multishot)。一个“shot”就是一个示例。
比较
同一个任务,两种提示词
只有指令
Label the support ticket as billing, bug or other.指令加示例
Label the support ticket with one word: billing, bug or other.

Ticket: I was charged twice for one top-up.
Label: billing

Ticket: The export button does nothing.
Label: bug

Ticket: Do you have a dark theme?
Label: other
第二个提示词从未解释 billing 是什么意思。示例通过展示做到了这一点,并把格式和含义一起带了过来。不过保留一行明确的指令仍然没有坏处,所以下面的版本保留了它。
有效示例的三条规则#
Anthropic 的页面把好的示例归结为三个词:
- 相关:接近你真正收到的工单,而不是别的任务。
- 多样:覆盖边缘情况,彼此不同,这样模型不会抓住偶然的模式。
- 结构化:用标签包起来(
<example>,以及<examples>内的多个),这样模型能区分示例和指令。同一页面还说标签名要保持一致。
下面是一个按这种方式构建的完整提示词。把它保存为 prompt.txt:
<instructions>
Label the support ticket with exactly one word: billing, bug or other.
Reply with the label only.
</instructions>

<examples>
<example>
<ticket>I was charged twice for the same top-up.</ticket>
<label>billing</label>
</example>
<example>
<ticket>The export button does nothing when I click it.</ticket>
<label>bug</label>
</example>
<example>
<ticket>Do you have a dark theme?</ticket>
<label>other</label>
</example>
<example>
<ticket>Please refund me. Also, the page crashes on login.</ticket>
<label>billing</label>
</example>
<example>
<ticket>Is there an API for exporting reports?</ticket>
<label>other</label>
</example>
</examples>
看第四个示例:一个退款请求,同时也提到了崩溃。指令无法解决混合工单,示例可以。这里钱优先,所以标签是 billing。无论你选什么规则,都要展示一次。
配对
哪条规则被违反了?
点击左侧项目,然后点击其配对项
- 你的示例是一行聊天问候,但真实工单是长邮件不相关:示例必须接近真实任务
- 你所有的示例都带同一个标签不多样:模型可能学到偶然的模式
- 示例作为松散文本粘贴在指令之间未结构化:用标签包起来,这样它们不会被误认为指令
通过 API 发送#
提示词在每次请求中都是同样的文本,只有新工单会变。每张工单都走同样的短流程:
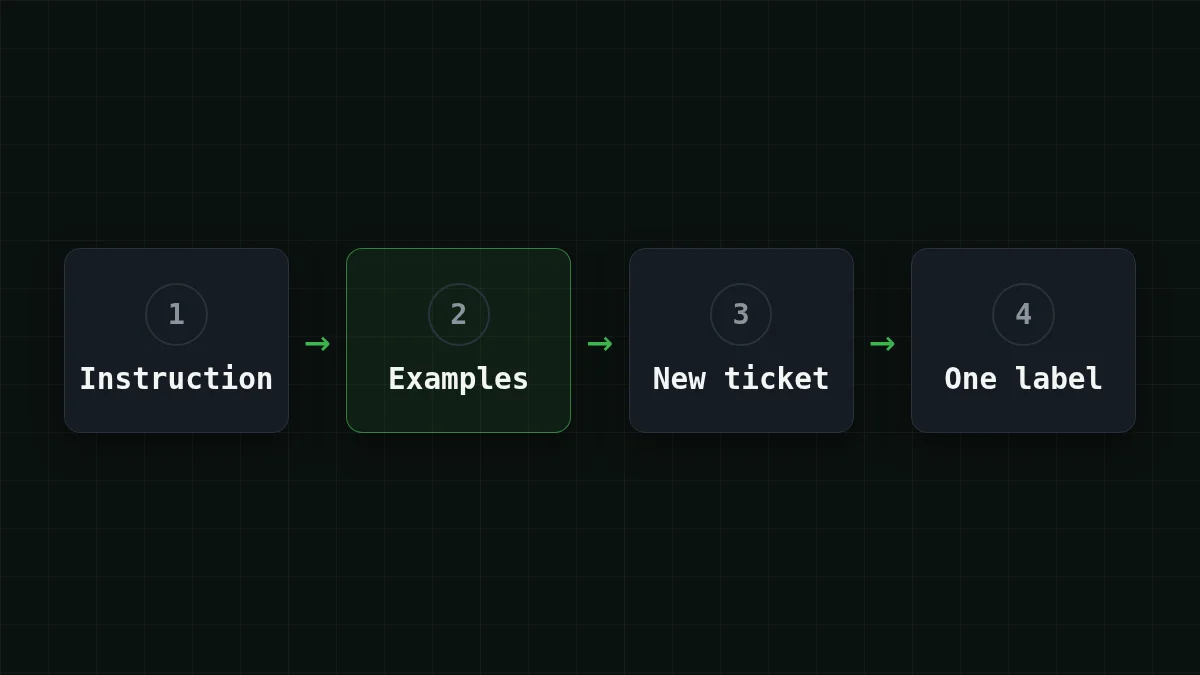
下面是使用 openai 包的 Python 版本。地址是 CheapTokens API,密钥放在环境变量中(见如何安全存储密钥),模型 id 是文档中的完整 id:
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)

PROMPT = open("prompt.txt", encoding="utf-8").read()


def label(ticket: str) -> str:
    response = client.chat.completions.create(
        model="deepseek-ai/DeepSeek-V4-Flash-0731",
        max_tokens=64,
        messages=[
            {"role": "system", "content": PROMPT},
            {"role": "user", "content": f"<ticket>{ticket}</ticket>"},
        ],
    )
    print(response.usage.prompt_tokens, response.usage.completion_tokens)
    return response.choices[0].message.content.strip()


print(label("The app shows a blank screen after the update."))
成功时你会在一行看到两个 token 计数,然后是标签本身,一个词,比如 bug。如果你得到的是一句话,说明示例还没发挥作用:检查标签,并确认你方案中的每个标签至少出现一次。
第一个数字是要关注的。它是整个提示词,指令加示例加工单,每加一个示例它都会增长。用完整的 prompt.txt 运行一次脚本,再只用 <instructions> 部分运行一次:两个第一个数字之间的差距就是你的示例每次请求的成本。
DeepSeek-V4-Flash 适合这类批量标注:任何时段一个价格,380K token 上下文(所以长示例块很容易放下),每次回答最多 32,768 token。GLM-5.3-Flash 有 390K 上下文,也适合短标注任务。两者都在模型页面上,共用一个余额。
五个示例给账单增加多少#
假设机器人每天处理 2,000 张工单。假设一张工单约 120 token,指令约 80,那么不带示例的请求是 80 + 120 = 200 个输入 token。五个示例每个约 60 token,增加 5 × 60 = 300,所以带示例的请求是 200 + 300 = 500。回答是一个词,两种情况下都算 3 个输出 token。这些是假设:换成你脚本打印的 prompt_tokens。
一天下来,200 × 2,000 = 400,000 个输入 token 变成 500 × 2,000 = 1,000,000,而输出保持在 3 × 2,000 = 6,000 token。在 DeepSeek-V4-Flash 上,这是不带示例每天 $0.0066,带示例每天 $0.0156。示例的成本就是这两个数字之间的差距,而按 Anthropic 的说法,它们换来的是更一致的输出。
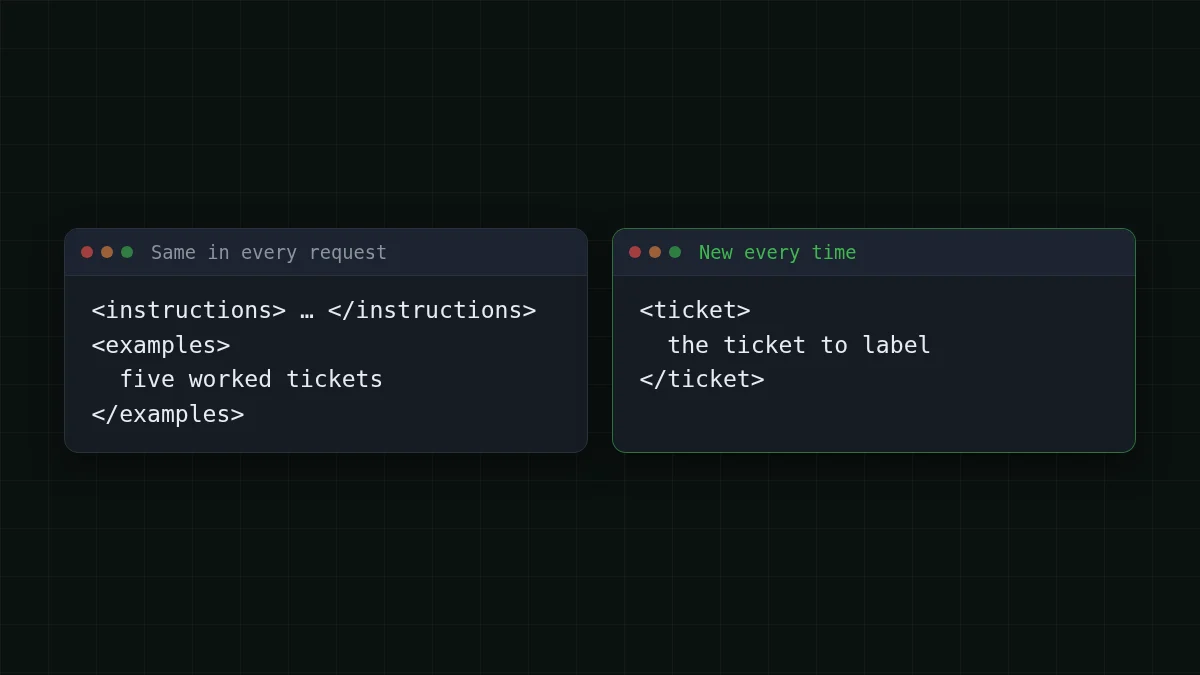
这张图隐藏了一个有用的细节。示例块在每次请求中都完全相同,这正是提示词缓存所关注的重复开头;什么是提示词缓存解释了其工作原理。
下面是同样的负载,每次请求 500 个输入和 3 个输出 token,2,000 次请求,跨模型对比。表格根据当前价格重新计算:
| 模型 | 输入 $/1M | 输出 $/1M | 每次请求 | 2,000 次请求 | OpenRouter,2,000 次请求 |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00001 | $0.0202 | $0.034 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0000078 | $0.0156 | $0.0708 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000025 | $0.0509 | $0.611 |
每次请求 500 个输入 token 和 3 个输出 token。每 100 万 token 的价格为当前价格,会随我们的资费一同变动;OpenRouter 列显示相同工作负载的参考价格。
把输入和输出加在一起,在这个负载下 DeepSeek-V4-Flash 和 GLM-5.3-Flash 比 OpenRouter 更便宜。完整价格表在定价页面上。
JSON、语气和检查你的示例#
同样的技巧也适用于你会遇到的另外两种情况。需要每次都有相同的 JSON 字段?让示例回答本身就是 JSON:
<example>
<ticket>I was charged twice for the same top-up.</ticket>
<output>{"label": "billing", "urgent": true}</output>
</example>
关于 response_format 以及回复仍然无效时该怎么办,见从 LLM API 获取有效 JSON。想用一种语气重写文本?像“友好但简短”这样的形容词很模糊;两对前后对比能更好地展示。
在信任任何一组示例之前,拿 20 张你已经手工标注过的工单,运行它们并比较。一次运行比任何规则都更能说明问题。Anthropic 的页面还提供了一个捷径:让模型评估你的示例的相关性和多样性,或者根据你已有的示例写出更多。
清单
在信任你的示例之前
一旦示例生效,下一个问题是如何防止多个文档在一个提示词中混在一起。在提示词中标注每个文档涵盖了这一点。


