DeepSeek تفتح مصدر DeepInfer: ما هو ومن ينبغي أن يستضيفه ذاتيًا
أصدرت DeepSeek إطار DeepInfer بموجب Apache-2.0: شيفرة استدلال لـ V4.1-Flash. ما يتضمنه، والعتاد الذي يحتاجه، ومتى يكون API الخيار الأبسط.
في هذه الصفحة
في 20 أكتوبر 2026، نشرت DeepSeek DeepInfer على GitHub (deepseek-) بموجب رخصة Apache License 2.0. وهو إطار الاستدلال لنماذج DeepSeek. وفقًا لملف README، فإنه يشغّل خدمات DeepSeek الإنتاجية واسعة النطاق. تاريخ الإصدار مأخوذ من منشور @deepseek_ai كما نقله ملخص Telegram؛ أما ملف README نفسه فلا يحمل تاريخًا.
ما هو DeepInfer#
DeepInfer هو شيفرة تشغّل نموذجًا على وحدات GPU أو NPU بسرعة. وهو ليس نموذجًا وليس خدمة مستضافة. النموذج الوحيد المدعوم هو DeepSeek-V4.1-Flash. افتراضيًا، ينزّل نقطة التحقق deepseek- إلى ذاكرة Hugging Face المؤقتة عند التشغيل الأول. وإذا كانت لديك الأوزان بالفعل، فاضبط DEEPINFER_ لاستخدام نسخة محلية.
ما يتضمنه الإصدار#
يسرد ملف README هذه الميزات:
- نوى محسّنة (kernels)؛
- التوازي في البيانات والسياق والخبراء مع موازنة الأحمال؛
- فك التشفير التخميني مع تحقق قائم على الثقة؛
- إعادة تشغيل محدودة بنافذة منزلقة لمرحلة prefill؛
- جدولة غير متزامنة؛
- استدلال ثابت عبر الدفعات وأخذ عينات حتمي؛
- مخرجات منظمة: تعبيرات نمطية ومخطط JSON وقواعد نحوية.
العديد من هذه الميزات مخصصة لـ NVIDIA فقط.
ما لا يتضمنه#
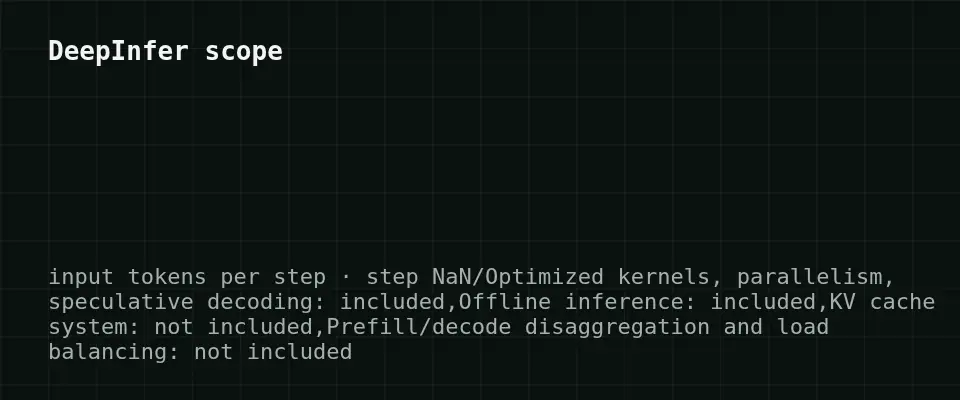
يوفر هذا الإصدار الاستدلال دون اتصال فقط. يذكر ملف README أن خدمة الاستدلال الكاملة تحتاج أيضًا إلى نظام ذاكرة KV المؤقتة وفصل مرحلة prefill عن decode وموازنة الأحمال، وهذه ليست جزءًا من الإصدار. لذا تحصل على المحرك، لا على حزمة الإنتاج كاملة. أما وضعها خلف واجهة API للمستخدمين فهو عمل تقوم به بنفسك.
العتاد والإعداد#
قم بتمرير الجدول لليمين →
| المتطلب | التفاصيل |
|---|---|
| المسرّعات | وحدات NVIDIA SM100 GPU أو Huawei Ascend 950 NPU |
| نظام التشغيل | Linux |
| المترجم | GCC 13+ |
| Python | 3.12 |
| بيئة التشغيل | CUDA 13 (NVIDIA) أو CANN 9.2 (Ascend) |
قيسَت المعايير المنشورة (مخططات Pareto لمرحلتي prefill وdecode) على 4 وحدات SM100 GPU لمرحلة prefill و64 لمرحلة decode، كل منها ضمن نطاق توسّع واحد. المخططات صور، لذا لا نقتبس أرقام الإنتاجية أو زمن الاستجابة. كما لا تتوفر لدينا بيانات عمّا إذا كان DeepInfer يغيّر سعر API لأي جهة، لذا لا نقدّم أي ادعاء من هذا القبيل.
هل ينبغي أن تشغّله بنفسك؟#
الاستضافة الذاتية منطقية إذا كنت تشغّل بالفعل عتاد SM100 أو Ascend 950، أو تحتاج تحكمًا كاملًا في الأوزان والسلوك الحتمي أو الثابت عبر الدفعات، أو تريد بناء طبقة تقديم خاصة بك. يُظهر إعداد المعايير (عشرات وحدات GPU لمرحلة decode) ما صُمّم الإطار من أجله: التقديم واسع النطاق.
إذا كنت تحتاج فقط إلى مخرجات من عائلة DeepSeek في تطبيقك، فإن الإطار يمثل بنية تحتية كثيرة تتحمل عبئها. استدعاء API أبسط: لا وحدات GPU، ولا إصدارات CUDA أو CANN تحتاج إلى مطابقتها.
خيار API لنوع المهمة نفسه#
إذا كنت تفضّل ألا تشغّل عنقود GPU خاصًا بك، فإن MiniMax-M2.7 على CheapTokens يتولى مهام الدردشة والبرمجة والوكلاء عبر API، مع:
- رصيد واحد لجميع النماذج وAPI متوافق مع OpenAI وAnthropic؛
- حتى 8,192 رمز إخراج لكل إجابة وسياق 180K؛
- سعر ثابت لكل نموذج دون ساعات ذروة؛
- أرخص من OpenRouter إجمالًا، مع احتساب الإدخال والإخراج معًا.
الأسعار الحالية لكل 1M رمز: الإدخال $0.05، الإخراج $0.15. مثال لعبء عمل من 2,000 رمز إدخال و500 رمز إخراج لكل طلب، و1,000 طلب:
| النموذج | الإدخال $/1M | الإخراج $/1M | لكل طلب | 1,000 طلبات | OpenRouter، 1,000 طلبات |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00006 | $0.06 | $0.121 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00008 | $0.08 | $0.173 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00018 | $0.175 | $1.20 |
2,000 رمز إدخال و500 رمز إخراج لكل طلب. الأسعار لكل مليون رمز حالية وتتغير مع تعريفاتنا؛ يعرض عمود OpenRouter أسعارًا مرجعية لنفس حجم العمل.
راجع مقال DeepSeek-V4.1-Flash-1017 لمعرفة ما تغيّر في النموذج نفسه.
الخلاصة#
DeepInfer إصدار مفتوح حقيقي لشيفرة استدلال إنتاجية، لكنه دون اتصال فقط ومرتبط بعتاد محدد (NVIDIA SM100 أو Ascend 950). ستجده الفرق التي تملك هذا العتاد وفريق تقديم مثيرًا للاهتمام. أما معظم المطورين فسيواصلون استدعاء API ومقارنة التكاليف وفق مزيج الرموز الخاص بهم.


