Новини AIРозбір
DeepSeek відкриває код DeepInfer: що це і кому варто розгортати самостійно
DeepSeek випустив DeepInfer під Apache-2.0: код інференсу для V4.1-Flash. Що входить, яке обладнання потрібне і коли API — простіший вибір.
На цій сторінці
20 жовтня 2026 року DeepSeek опублікував DeepInfer на GitHub (deepseek-) під ліцензією Apache License 2.0. Це фреймворк інференсу для моделей DeepSeek. Згідно з README, він забезпечує роботу великомасштабних продакшн-сервісів DeepSeek. Дата релізу взята з посту @deepseek_ai, переданого через дайджест у Telegram; у самому README дати немає.
Що таке DeepInfer#
DeepInfer — це код, який швидко запускає модель на GPU або NPU. Це не модель і не хостинговий сервіс. Єдина підтримувана модель — DeepSeek-V4.1-Flash. За замовчуванням під час першого запуску він завантажує чекпойнт deepseek- у кеш Hugging Face. Якщо ваги вже є, задайте DEEPINFER_, щоб використовувати локальну копію.
Що входить до складу#
У README перелічено такі можливості:
- оптимізовані ядра;
- паралелізм даних, контексту та експертів із балансуванням навантаження;
- спекулятивне декодування з перевіркою на основі впевненості;
- обмежене повторення ковзного вікна для prefill;
- асинхронне планування;
- інференс, інваріантний до батчу, та детермінована семплізація;
- структуровані виходи: regex, JSON schema та граматики.
Кілька з цих можливостей працюють лише на NVIDIA.
Що не входить#
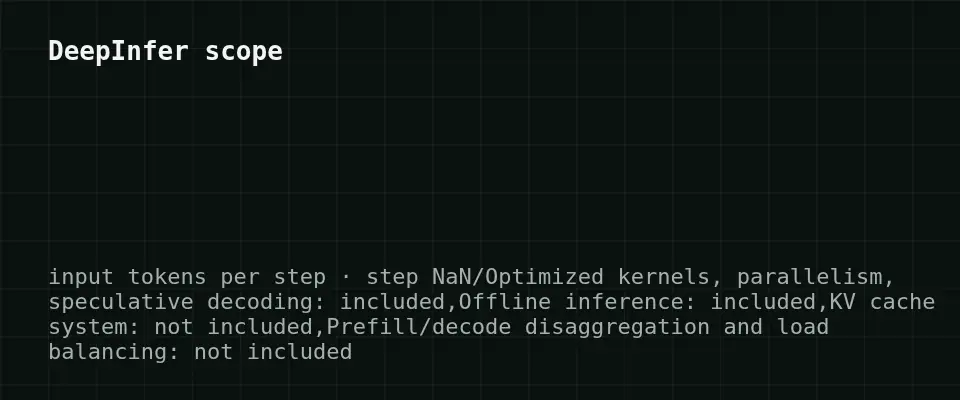
Цей реліз надає лише офлайн-інференс. У README зазначено, що повноцінному сервісу інференсу також потрібні система KV-кешу, розділення prefill/decode та балансування навантаження, і вони не входять до релізу. Тож ви отримуєте рушій, а не весь продакшн-стек. Виставляння його за API для користувачів — це робота, яку вам доведеться виконати самостійно.
Апаратне забезпечення та налаштування#
Прокрутіть таблицю праворуч →
| Вимога | Деталі |
|---|---|
| Прискорювачі | GPU NVIDIA SM100 або NPU Huawei Ascend 950 |
| ОС | Linux |
| Компілятор | GCC 13+ |
| Python | 3.12 |
| Середовище виконання | CUDA 13 (NVIDIA) або CANN 9.2 (Ascend) |
Опубліковані бенчмарки (графіки Парето для prefill і decode) вимірювалися на 4 GPU SM100 для prefill і 64 для decode, кожен у межах одного домену scale-up. Графіки є зображеннями, тому ми не наводимо цифри пропускної здатності чи затримки. У нас також немає даних, чи DeepInfer змінює чиїсь ціни на API, тож ми не робимо таких тверджень.
Чи варто запускати його самостійно?#
Самостійний хостинг має сенс, якщо ви вже експлуатуєте обладнання SM100 або Ascend 950, потребуєте повного контролю над вагами та детермінованої поведінки чи поведінки, інваріантної до батчу, або хочете побудувати власний шар обслуговування. Налаштування бенчмарку (десятки GPU для decode) показує, для чого налаштований фреймворк: великомасштабного обслуговування.
Якщо вам просто потрібен вихід моделей сімейства DeepSeek у вашому застосунку, фреймворк — це забагато інфраструктури, яку доведеться взяти на себе. Виклик API простіший: без GPU, без узгодження версій CUDA чи CANN.
Варіант API для того самого типу завдань#
Якщо ви не хочете запускати власний кластер GPU, MiniMax-M2.7 на CheapTokens обробляє чат, кодування та агентні завдання через API, з:
- одним балансом для всіх моделей та API, сумісним з OpenAI і Anthropic;
- до 8 192 вихідних токенів на відповідь і контекстом 180K;
- фіксованою ціною за модель без пікових годин;
- дешевше за OpenRouter загалом, з урахуванням вхідних і вихідних токенів разом.
Поточні ціни за 1M токенів: вхідні $0.05, вихідні $0.15. Приклад навантаження: 2 000 вхідних і 500 вихідних токенів на запит, 1 000 запитів:
| Модель | Вхід $/1М | Вихід $/1М | За запит | 1 000 запитів | OpenRouter, 1 000 запитів |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00006 | $0.06 | $0.121 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00008 | $0.08 | $0.173 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00018 | $0.175 | $1.20 |
2 000 вхідних і 500 вихідних токенів на запит. Ціни за 1 млн токенів актуальні та змінюються разом із нашими тарифами; стовпець OpenRouter показує довідкові ціни для того самого навантаження.
Про те, що змінилося в самій моделі, дивіться в статті про DeepSeek-V4.1-Flash-1017.
Підсумок#
DeepInfer — це справжній відкритий реліз продакшн-коду для інференсу, але лише офлайн і прив'язаний до конкретного обладнання (NVIDIA SM100 або Ascend 950). Командам із таким обладнанням і командою обслуговування він буде цікавим. Більшість розробників і далі викликатимуть API і порівнюватимуть витрати для свого набору токенів.


