Noticias de IAAnálisis
DeepSeek libera DeepInfer como código abierto: qué es y quién debería autoalojarlo
DeepSeek publicó DeepInfer bajo Apache-2.0: código de inferencia para V4.1-Flash. Qué incluye, qué hardware necesita y cuándo una API es la opción más sencilla.
En esta página
El 20 de octubre de 2026 DeepSeek publicó DeepInfer en GitHub (deepseek-) bajo la Licencia Apache 2.0. Es el framework de inferencia para los modelos DeepSeek. Según el README, impulsa los servicios de producción a gran escala de DeepSeek. La fecha de publicación proviene de la publicación de @deepseek_ai tal como la retransmitió un resumen de Telegram; el README en sí no tiene fecha.
Qué es DeepInfer#
DeepInfer es código que ejecuta un modelo en GPUs o NPUs de forma rápida. No es un modelo ni un servicio alojado. El único modelo compatible es DeepSeek-V4.1-Flash. Por defecto descarga el checkpoint deepseek- en la caché de Hugging Face en la primera ejecución. Si ya tienes los pesos, configura DEEPINFER_ para usar una copia local.
Qué incluye#
El README enumera estas características:
- kernels optimizados;
- paralelismo de datos, contexto y expertos con balanceo de carga;
- decodificación especulativa con verificación basada en confianza;
- replay de ventana deslizante acotada para prefill;
- planificación asíncrona;
- inferencia invariante por lote y muestreo determinista;
- salidas estructuradas: regex, esquema JSON y gramática.
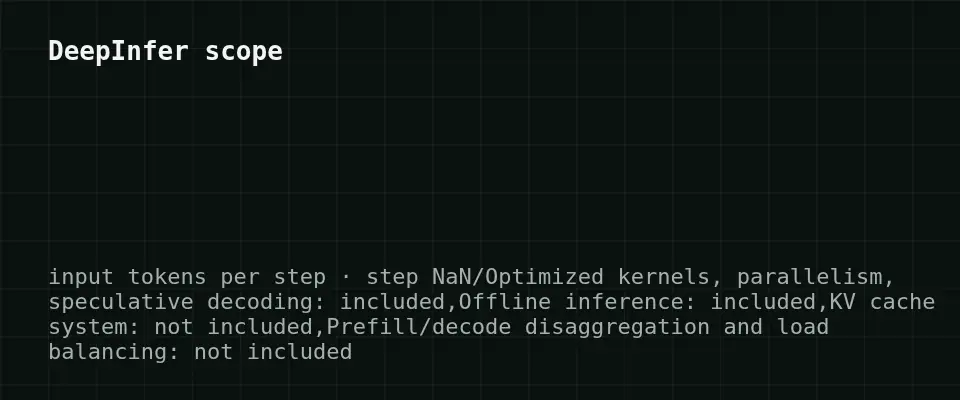
Varias de estas características son exclusivas de NVIDIA.
Qué no incluye#
Esta versión proporciona solo inferencia offline. El README indica que un servicio de inferencia completo también necesita un sistema de caché KV, desagregación prefill/decode y balanceo de carga, y estos no forman parte de la versión. Así que obtienes el motor, no todo el stack de producción. Ponerlo detrás de una API para los usuarios es trabajo que tendrías que hacer tú mismo.
Hardware y configuración#
Desplaza la tabla hacia la derecha →
| Requisito | Detalles |
|---|---|
| Aceleradores | GPUs NVIDIA SM100 o NPUs Huawei Ascend 950 |
| SO | Linux |
| Compilador | GCC 13+ |
| Python | 3.12 |
| Runtime | CUDA 13 (NVIDIA) o CANN 9.2 (Ascend) |
Los benchmarks publicados (gráficos de Pareto de prefill y decode) se midieron en 4 GPUs SM100 para prefill y 64 para decode, cada uno dentro de un único dominio de scale-up. Los gráficos son imágenes, así que no citamos cifras de throughput ni de latencia. Tampoco tenemos datos sobre si DeepInfer cambia el precio de la API de alguien, por lo que no hacemos tal afirmación.
¿Deberías ejecutarlo tú mismo?#
El autoalojamiento tiene sentido si ya operas hardware SM100 o Ascend 950, necesitas control total sobre los pesos y el comportamiento determinista o invariante por lote, o quieres construir tu propia capa de servicio. La configuración del benchmark (docenas de GPUs para decode) muestra para qué está optimizado el framework: servicio a gran escala.
Si solo necesitas salida de la familia DeepSeek en tu aplicación, el framework es mucha infraestructura que asumir. Llamar a una API es más sencillo: sin GPUs, sin versiones de CUDA o CANN que emparejar.
Una opción de API para el mismo tipo de tarea#
Si prefieres no ejecutar tu propio clúster de GPUs, MiniMax-M2.7 en CheapTokens maneja tareas de chat, programación y agentes a través de una API, con:
- un solo saldo para todos los modelos y una API compatible con OpenAI y Anthropic;
- hasta 8.192 tokens de salida por respuesta y un contexto de 180K;
- un precio fijo por modelo sin horas punta;
- más barato que OpenRouter en total, con entrada y salida contabilizadas juntas.
Precios actuales por 1M de tokens: entrada $0.05, salida $0.15. Un ejemplo de carga de trabajo de 2.000 tokens de entrada y 500 de salida por solicitud, 1.000 solicitudes:
| Modelo | Entrada $/1M | Salida $/1M | Por solicitud | 1000 solicitudes | OpenRouter, 1000 solicitudes |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00006 | $0.06 | $0.121 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00008 | $0.08 | $0.173 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00018 | $0.175 | $1.20 |
2000 tokens de entrada y 500 tokens de salida por solicitud. Los precios por 1M de tokens son actuales y cambian junto con nuestras tarifas; la columna de OpenRouter muestra precios de referencia para la misma carga de trabajo.
Consulta el artículo sobre DeepSeek-V4.1-Flash-1017 para ver qué cambió en el propio modelo.
Conclusión#
DeepInfer es una publicación abierta real de código de inferencia de producción, pero solo offline y ligada a hardware específico (NVIDIA SM100 o Ascend 950). Los equipos con ese hardware y un equipo de servicio lo encontrarán interesante. La mayoría de los desarrolladores seguirán llamando a una API y comparando costes para su propia mezcla de tokens.


