API y SDKGuía
Vercel AI SDK con una URL base personalizada: CheapTokens en TypeScript
Apunta el Vercel AI SDK a CheapTokens con createOpenAICompatible: un fragmento funcional de generateText y streamText, uso de tokens y soluciones a errores comunes.
En esta página
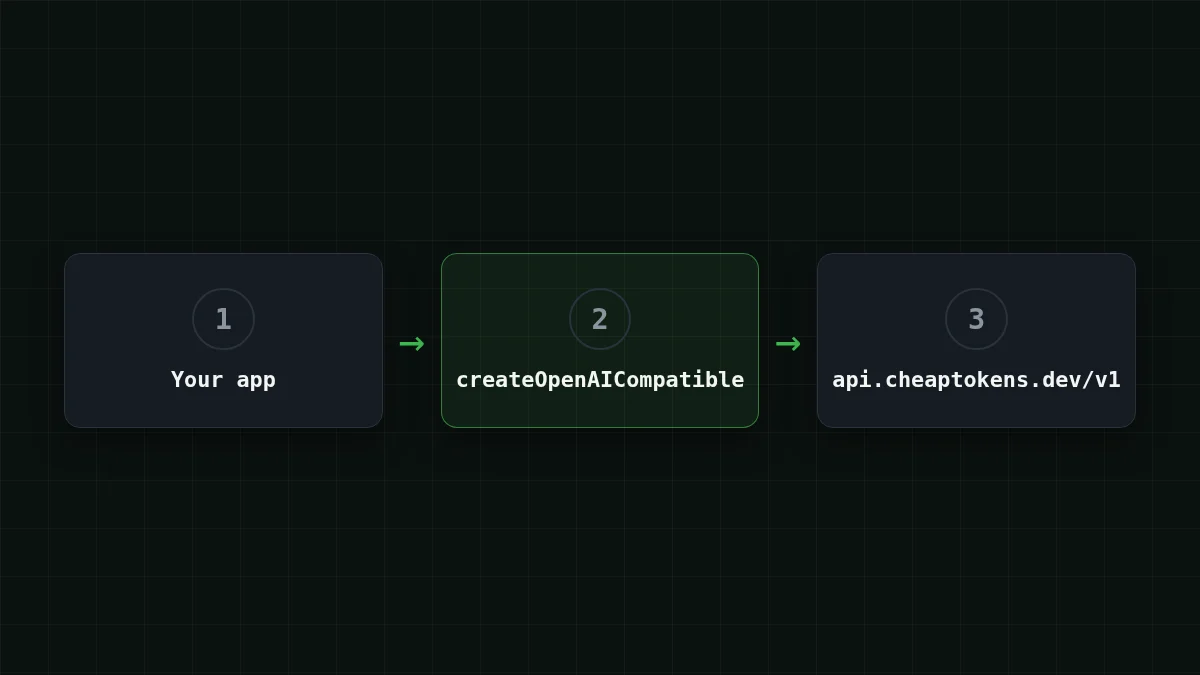
Para ejecutar el Vercel AI SDK en CheapTokens, instala @ai-, crea un proveedor con baseURL: 'https:/ y tu clave, y pasa provider('deepseek- como model. Todo lo demás en tu app, generateText, streamText, tus prompts, se queda como está.
Así que si ya tienes una ruta de Next.js o un script de Node que habla con un modelo alojado a través del AI SDK, cambias tres cosas: la URL base, la clave y el id del modelo. Esta guía verifica la configuración contra la página de proveedores compatibles con OpenAI del AI SDK (29 de octubre de 2026). Usa la interfaz Chat Completions de la API de CheapTokens, que es la que habla ese proveedor.
Instalar y crear el proveedor#
Dos paquetes: el paquete principal ai y el proveedor compatible con OpenAI.
npm install ai @ai-sdk/openai-compatible
export CHEAPTOKENS_API_KEY=ct_your_key_here
El orden de trabajo es corto:
Poner en orden
Pon la configuración en orden
Arrastra los elementos o usa las flechas
- Recarga el saldo y crea una clave de API
- Pon la clave en una variable de entorno
- Crea el proveedor con la baseURL de CheapTokens
- Pasa el id completo del modelo a generateText
El proveedor en sí es una sola llamada a createOpenAICompatible:
import { createOpenAICompatible } from '@ai-sdk/openai-compatible';

export const cheaptokens = createOpenAICompatible({
  name: 'cheaptokens',
  apiKey: process.env.CHEAPTOKENS_API_KEY,
  baseURL: 'https://api.cheaptokens.dev/v1',
  includeUsage: true,
});
name es solo una etiqueta para tus propios logs. includeUsage: true pide también los recuentos de tokens en las respuestas en streaming; sin él, el comportamiento por defecto es como false. Llamar a cheaptokens('model- te da un modelo de chat; cheaptokens. y cheaptokens. hacen lo mismo.
El id del modelo tiene que ser el completo: deepseek-. Un nombre corto como deepseek- es lo que ves en las tablas de precios, y la API no lo aceptará. Si no estás seguro de qué escribir, lista los modelos con GET /v1/models y copia el id de ahí.
generateText: una respuesta y su recuento de tokens#
Aquí tienes un script completo. Pide una respuesta corta e imprime tanto el texto como el objeto usage.
import { generateText } from 'ai';
import { cheaptokens } from './provider';

const result = await generateText({
  model: cheaptokens('deepseek-ai/DeepSeek-V4-Flash-0731'),
  prompt: 'Explain in two sentences what a base URL is.',
});

console.log(result.text);
console.log(result.usage);
Ejecútalo con npx tsx index.ts. Obtienes la respuesta como una cadena en result.text, y result.usage contiene los recuentos de tokens de entrada y salida de esa llamada. Imprimimos el objeto entero para que veas todo lo que hay en él. En la referencia del AI SDK para streamText (consultada el 29 de octubre de 2026) usage tiene inputTokens, outputTokens y totalTokens; comprueba los tipos de tu versión instalada antes de conectarlos a un panel.
¿Por qué molestarse en leer usage? Porque ese es el número que pagas. Digamos que tu app envía un prompt de 1.500 tokens y recibe una respuesta de 600 tokens. Esa petición cuesta $0.000083 a los precios actuales, y mil de ellas se ven así:
| Modelo | Entrada $/1M | Salida $/1M | Por solicitud | 1000 solicitudes | OpenRouter, 1000 solicitudes |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000054 | $0.054 | $0.107 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000083 | $0.0825 | $0.165 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00017 | $0.165 | $1.17 |
1500 tokens de entrada y 600 tokens de salida por solicitud. Los precios por 1M de tokens son actuales y cambian junto con nuestras tarifas; la columna de OpenRouter muestra precios de referencia para la misma carga de trabajo.
La columna de CheapTokens es en total, entrada y salida juntas, más barata que OpenRouter para todos los modelos de la tabla. Si quieres convertir usage en un presupuesto en marcha, tracking agent token cost muestra la idea en Python; la aritmética es la misma en TypeScript.
streamText: imprime palabras a medida que llegan#
Para una interfaz de chat quieres que el texto aparezca mientras el modelo sigue escribiendo. streamText te da un iterable asíncrono de fragmentos de texto.
import { streamText } from 'ai';
import { cheaptokens } from './provider';

const result = streamText({
  model: cheaptokens('deepseek-ai/DeepSeek-V4-Flash-0731'),
  prompt: 'Write a 100-word product description for a pocket notebook.',
});

for await (const chunk of result.textStream) {
  process.stdout.write(chunk);
}

console.log('\n', await result.usage);
Fíjate en que no hay await delante de streamText(...): devuelve enseguida y tú consumes el stream. usage es una promesa que se resuelve cuando termina el stream, así que la esperas después del bucle. En un route handler de Next.js devolverías el stream al navegador en lugar de escribir en stdout; la parte del proveedor es idéntica. Si quieres lo mismo con el SDK de OpenAI a secas, consulta streaming chat responses in Node.js.
Las respuestas largas no son problema aquí: DeepSeek-V4-Flash en CheapTokens puede escribir hasta 32.768 tokens en una respuesta, tiene una ventana de contexto de 380K y un único precio a cualquier hora. La página del modelo está en /en/cheap-deepseek/, y los precios actuales están en la página de precios.
Cambiar el modelo sin tocar el resto#
Como solo cambia el id del modelo, probar otro modelo es una edición de una línea. GLM-5.3-Flash tiene una ventana de contexto de 390K y responde hasta 8.192 tokens; a los precios actuales cuesta $0.02 por 1M de tokens de entrada y $0.04 por 1M de tokens de salida.
Pruébalo tú mismoPruébalo: ¿qué línea cambias para ejecutar el mismo script con GLM-5.3-Flash?Mostrar respuesta
Solo el id del modelo: cheaptokens('zai-. El proveedor, la clave, la baseURL y el resto del script se quedan igual.
Un patrón práctico es mantener el id en una variable de entorno (process.) para poder comparar dos modelos con el mismo prompt sin recompilar. La comparación DeepSeek vs GLM vs MiniMax ayuda a elegir cuáles merece la pena probar.
Si no funciona#
La mayoría de los fallos son una de tres cosas: la clave, la URL o el id del modelo.
- 401 significa que falta la clave o es incorrecta. Comprueba que
CHEAPTOKENS_está definida en el shell que ejecuta el script (un servidor Next.js la necesita enAPI_ KEY .env.localy un reinicio). - 404 normalmente significa que la baseURL perdió su
/v1o que el id del modelo es el nombre corto. Usahttps:/y el id completo./ api. cheaptokens. dev/ v1 - La respuesta se corta a mitad de frase. El modelo alcanzó un límite de salida; la solución para finish_reason "length" lo explica.
El recorrido más largo de los dos primeros está en API 401 o 404: clave, URL base o id de modelo incorrectos.
Lista de verificación
Antes de ejecutar el script
Para conectar otras herramientas y hacer la primera petición a mano, empieza por la documentación de CheapTokens.


