API & SDKGuide
SDK AI de Vercel avec une URL de base personnalisée : CheapTokens en TypeScript
Pointez le SDK AI de Vercel vers CheapTokens avec createOpenAICompatible : un extrait fonctionnel de generateText et streamText, l'usage des tokens et des correctifs pour les erreurs courantes.
Sur cette page
Pour exécuter le SDK AI de Vercel sur CheapTokens, installez @ai-, créez un provider avec baseURL: 'https:/ et votre clé, puis passez provider('deepseek- comme model. Tout le reste de votre app, generateText, streamText, vos prompts, reste inchangé.
Donc si vous avez déjà une route Next.js ou un script Node qui parle à un modèle hébergé via le SDK AI, vous changez trois choses : l'URL de base, la clé et l'id du modèle. Ce guide vérifie la configuration par rapport à la page des providers compatibles OpenAI du SDK AI (29 octobre 2026). Il utilise l'interface Chat Completions de l'API CheapTokens, qui est ce que parle ce provider.
Installer et créer le provider#
Deux paquets : le paquet principal ai et le provider compatible OpenAI.
npm install ai @ai-sdk/openai-compatible
export CHEAPTOKENS_API_KEY=ct_your_key_here
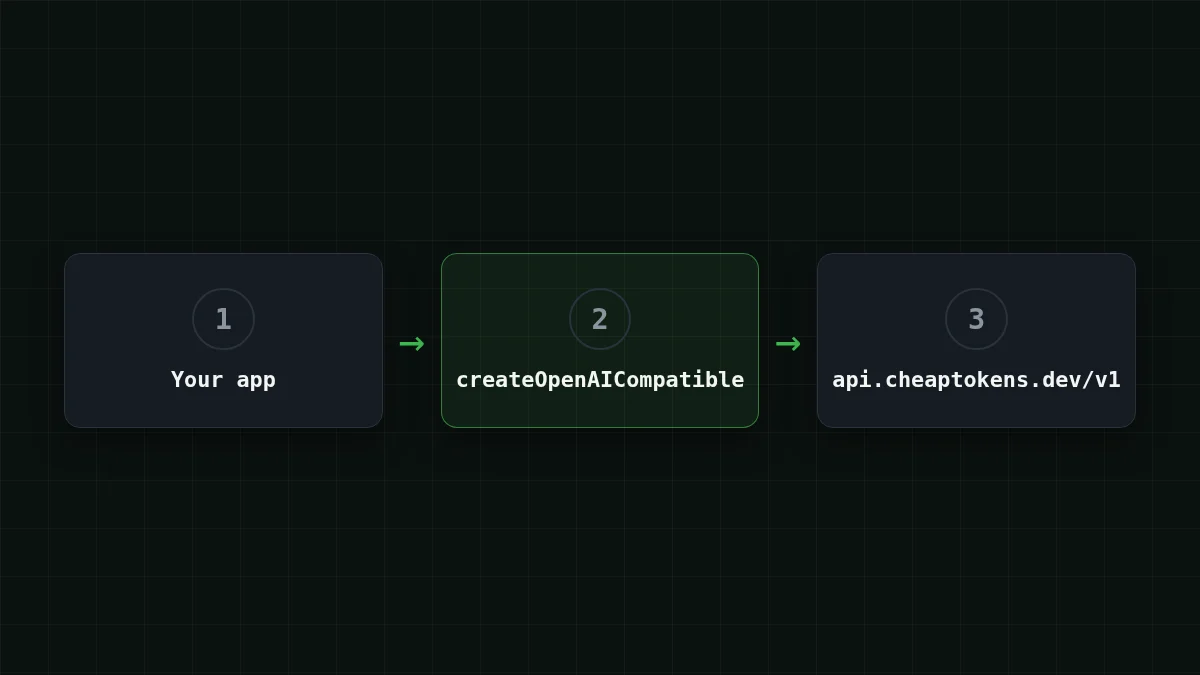
L'ordre des opérations est court :
Remettre en ordre
Mettez la configuration en ordre
Faites glisser les éléments ou utilisez les flèches
- Rechargez le solde et créez une clé API
- Placez la clé dans une variable d'environnement
- Créez le provider avec le baseURL de CheapTokens
- Passez l'id complet du modèle à generateText
Le provider lui-même est un seul appel à createOpenAICompatible :
import { createOpenAICompatible } from '@ai-sdk/openai-compatible';

export const cheaptokens = createOpenAICompatible({
  name: 'cheaptokens',
  apiKey: process.env.CHEAPTOKENS_API_KEY,
  baseURL: 'https://api.cheaptokens.dev/v1',
  includeUsage: true,
});
name n'est qu'un libellé pour vos propres logs. includeUsage: true demande aussi les décomptes de tokens dans les réponses en streaming ; sans cela, le comportement par défaut équivaut à false. Appeler cheaptokens('model- vous donne un modèle de chat ; cheaptokens. et cheaptokens. font la même chose.
L'id du modèle doit être le complet : deepseek-. Un nom court comme deepseek- est ce que vous voyez dans les tableaux de prix, et l'API ne l'acceptera pas. Si vous ne savez pas quoi saisir, listez les modèles avec GET /v1/models et copiez l'id depuis là.
generateText : une réponse et son décompte de tokens#
Voici un script complet. Il demande une réponse courte et affiche à la fois le texte et l'objet usage.
import { generateText } from 'ai';
import { cheaptokens } from './provider';

const result = await generateText({
  model: cheaptokens('deepseek-ai/DeepSeek-V4-Flash-0731'),
  prompt: 'Explain in two sentences what a base URL is.',
});

console.log(result.text);
console.log(result.usage);
Exécutez-le avec npx tsx index.ts. Vous obtenez la réponse sous forme de chaîne dans result.text, et result.usage contient les décomptes de tokens d'entrée et de sortie pour cet appel. Nous affichons l'objet entier pour que vous voyiez tout ce qu'il contient. Dans la référence du SDK AI pour streamText (vérifiée le 29 octobre 2026), usage a inputTokens, outputTokens et totalTokens ; vérifiez les types de votre version installée avant de les brancher dans un dashboard.
Pourquoi lire usage tout court ? Parce que c'est le nombre que vous payez. Disons que votre app envoie un prompt de 1 500 tokens et reçoit une réponse de 600 tokens. Cette requête coûte $0.000083 aux prix actuels, et mille d'entre elles ressemblent à ceci :
| Modèle | Entrée $/1M | Sortie $/1M | Par requête | 1 000 requêtes | OpenRouter, 1 000 requêtes |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000054 | $0.054 | $0.107 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000083 | $0.0825 | $0.165 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00017 | $0.165 | $1.17 |
1 500 tokens d'entrée et 600 tokens de sortie par requête. Les prix par million de tokens sont actuels et évoluent avec nos tarifs ; la colonne OpenRouter indique des prix de référence pour la même charge de travail.
La colonne CheapTokens est en total, entrée et sortie ensemble, moins chère qu'OpenRouter pour chaque modèle du tableau. Si vous voulez transformer usage en budget courant, tracking agent token cost montre l'idée en Python ; l'arithmétique est la même en TypeScript.
streamText : afficher les mots à mesure qu'ils arrivent#
Pour une UI de chat, vous voulez que le texte apparaisse pendant que le modèle écrit encore. streamText vous donne un itérable asynchrone de morceaux de texte.
import { streamText } from 'ai';
import { cheaptokens } from './provider';

const result = streamText({
  model: cheaptokens('deepseek-ai/DeepSeek-V4-Flash-0731'),
  prompt: 'Write a 100-word product description for a pocket notebook.',
});

for await (const chunk of result.textStream) {
  process.stdout.write(chunk);
}

console.log('\n', await result.usage);
Remarquez qu'il n'y a pas de await devant streamText(...) : il retourne immédiatement et vous consommez le flux. usage est une promesse qui se résout à la fin du flux, donc vous l'attendez après la boucle. Dans un gestionnaire de route Next.js, vous renverriez le flux au navigateur au lieu d'écrire sur stdout ; la partie provider est identique. Si vous voulez la même chose avec le SDK OpenAI simple, voir streaming chat responses in Node.js.
Les réponses longues passent ici : DeepSeek-V4-Flash sur CheapTokens peut écrire jusqu'à 32 768 tokens en une réponse, dispose d'une fenêtre de contexte de 380K et d'un prix unique à toute heure. La page du modèle est à /en/cheap-deepseek/, et les prix actuels sont sur la page de tarification.
Changer de modèle sans toucher au reste#
Comme seul l'id du modèle change, essayer un autre modèle est une modification d'une ligne. GLM-5.3-Flash dispose d'une fenêtre de contexte de 390K et répond jusqu'à 8 192 tokens ; aux prix actuels, il coûte $0.02 par 1M de tokens d'entrée et $0.04 par 1M de tokens de sortie.
Essayez vous-mêmeEssayez : quelle ligne changez-vous pour exécuter le même script sur GLM-5.3-Flash ?Afficher la réponse
Seulement l'id du modèle : cheaptokens('zai-. Le provider, la clé, le baseURL et le reste du script restent identiques.
Un schéma pratique consiste à garder l'id dans une variable d'environnement (process.) pour pouvoir comparer deux modèles sur le même prompt sans rebuild. La comparaison DeepSeek vs GLM vs MiniMax aide à choisir lesquels valent la peine d'être essayés.
Si ça ne fonctionne pas#
La plupart des échecs relèvent de trois choses : la clé, l'URL ou l'id du modèle.
- 401 signifie que la clé est absente ou erronée. Vérifiez que
CHEAPTOKENS_est défini dans le shell qui exécute le script (un serveur Next.js en a besoin dansAPI_ KEY .env.localet d'un redémarrage). - 404 signifie généralement que le baseURL a perdu son
/v1ou que l'id du modèle est le nom court. Utilisezhttps:/et l'id complet./ api. cheaptokens. dev/ v1 - La réponse s'arrête en milieu de phrase. Le modèle a atteint une limite de sortie ; le correctif finish_reason "length" l'explique.
Le tutoriel plus long des deux premiers cas se trouve dans API 401 or 404: wrong key, base URL or model id.
Liste de contrôle
Avant d'exécuter le script
Pour connecter d'autres outils et faire la première requête à la main, commencez par la documentation CheapTokens.


