API اور SDKگائیڈ
کسٹم بیس URL کے ساتھ Vercel AI SDK: TypeScript میں CheapTokens
Vercel AI SDK کو createOpenAICompatible کے ساتھ CheapTokens کی طرف اشارہ کریں: کام کرنے والا generateText اور streamText اسنیپٹ، ٹوکن usage اور عام غلطیوں کے حل۔
اس صفحہ پر
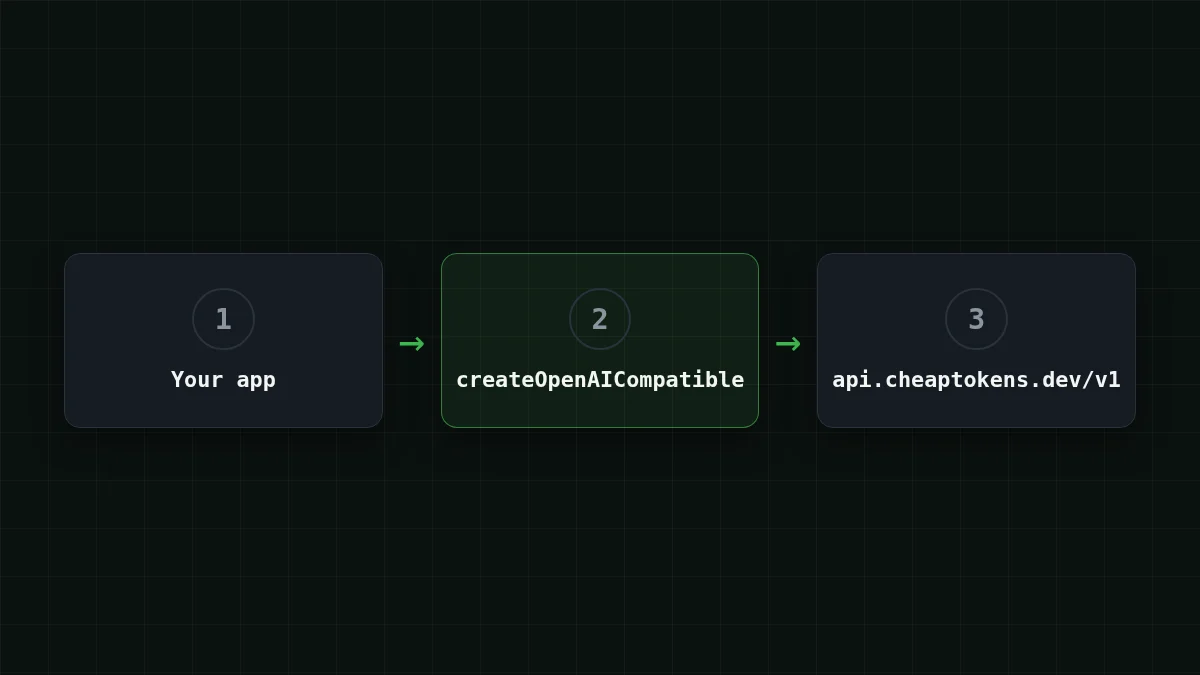
Vercel AI SDK کو CheapTokens پر چلانے کے لیے، @ai- انسٹال کریں، baseURL: 'https:/ اور اپنی کلید کے ساتھ ایک پرووائیڈر بنائیں، اور provider('deepseek- کو model کے طور پر پاس کریں۔ آپ کی ایپ میں باقی سب کچھ، generateText، streamText، آپ کے پرامپٹس، ویسے ہی رہتے ہیں۔
لہٰذا اگر آپ کے پاس پہلے سے کوئی Next.js روٹ یا Node اسکرپٹ ہے جو AI SDK کے ذریعے کسی ہوسٹڈ ماڈل سے بات کرتا ہے، تو آپ تین چیزیں بدلتے ہیں: بیس URL، کلید اور ماڈل آئی ڈی۔ یہ گائیڈ سیٹ اپ کو AI SDK کے OpenAI-compatible providers page (29 اکتوبر 2026) کے مطابق جانچتی ہے۔ یہ CheapTokens API کے Chat Completions انٹرفیس کا استعمال کرتی ہے، جو کہ وہی ہے جو وہ پرووائیڈر بولتا ہے۔
انسٹال کریں اور پرووائیڈر بنائیں#
دو پیکجز: کور ai پیکج اور OpenAI-compatible پرووائیڈر۔
npm install ai @ai-sdk/openai-compatible
export CHEAPTOKENS_API_KEY=ct_your_key_here
کام کی ترتیب مختصر ہے:
ترتیب دیں
سیٹ اپ کو ترتیب دیں
آئٹمز کو گھسیٹیں یا تیروں کا استعمال کریں
- بیلنس ٹاپ اپ کریں اور API کلید بنائیں
- کلید کو ایک ماحولیاتی متغیر میں رکھیں
- CheapTokens baseURL کے ساتھ پرووائیڈر بنائیں
- مکمل ماڈل آئی ڈی generateText کو پاس کریں
پرووائیڈر خود createOpenAICompatible کی ایک کال ہے:
import { createOpenAICompatible } from '@ai-sdk/openai-compatible';

export const cheaptokens = createOpenAICompatible({
  name: 'cheaptokens',
  apiKey: process.env.CHEAPTOKENS_API_KEY,
  baseURL: 'https://api.cheaptokens.dev/v1',
  includeUsage: true,
});
name صرف آپ کے اپنے لاگز کے لیے ایک لیبل ہے۔ includeUsage: true اسٹریمنگ جوابات میں بھی ٹوکن کی گنتی طلب کرتا ہے؛ اس کے بغیر ڈیفالٹ false کی طرح برتاؤ کرتا ہے۔ cheaptokens('model- کال کرنے سے آپ کو ایک چیٹ ماڈل ملتا ہے؛ cheaptokens. اور cheaptokens. بھی وہی کام کرتے ہیں۔
ماڈل آئی ڈی مکمل ہونی چاہیے: deepseek-۔ deepseek- جیسا مختصر نام وہ ہے جو آپ قیمت کے جدولوں میں دیکھتے ہیں، اور API اسے قبول نہیں کرے گا۔ اگر آپ کو یقین نہیں کہ کیا ٹائپ کرنا ہے، تو GET /v1/models کے ساتھ ماڈلز کی فہرست بنائیں اور وہاں سے آئی ڈی کاپی کریں۔
generateText: ایک جواب اور اس کی ٹوکن گنتی#
یہاں ایک مکمل اسکرپٹ ہے۔ یہ ایک مختصر جواب طلب کرتا ہے اور متن اور usage آبجیکٹ دونوں پرنٹ کرتا ہے۔
import { generateText } from 'ai';
import { cheaptokens } from './provider';

const result = await generateText({
  model: cheaptokens('deepseek-ai/DeepSeek-V4-Flash-0731'),
  prompt: 'Explain in two sentences what a base URL is.',
});

console.log(result.text);
console.log(result.usage);
اسے npx tsx index.ts کے ساتھ چلائیں۔ آپ کو جواب result.text میں بطور سٹرنگ ملتا ہے، اور result.usage اس کال کے لیے ان پٹ اور آؤٹ پٹ ٹوکن کی گنتی رکھتا ہے۔ ہم پورا آبجیکٹ پرنٹ کرتے ہیں تاکہ آپ اس میں سب کچھ دیکھ سکیں۔ streamText کے لیے AI SDK ریفرنس (29 اکتوبر 2026 کو چیک کیا گیا) میں usage کے پاس inputTokens، outputTokens اور totalTokens ہیں؛ انہیں ڈیش بورڈ میں وائر کرنے سے پہلے اپنے انسٹال شدہ ورژن کی اقسام چیک کریں۔
usage پڑھنے کی زحمت کیوں؟ کیونکہ یہی وہ نمبر ہے جس کی آپ ادائیگی کرتے ہیں۔ فرض کریں آپ کی ایپ 1,500 ٹوکن کا پرامپٹ بھیجتی ہے اور 600 ٹوکن کا جواب پاتی ہے۔ وہ درخواست موجودہ قیمتوں پر $0.000083 کی لاگت رکھتی ہے، اور ایسی ایک ہزار درخواستیں ایسی دکھتی ہیں:
| ماڈل | ان پٹ $/1M | آؤٹ پٹ $/1M | فی درخواست | 1,000 درخواستیں | OpenRouter، 1,000 درخواستیں |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000054 | $0.054 | $0.107 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000083 | $0.0825 | $0.165 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00017 | $0.165 | $1.17 |
فی درخواست 1,500 ان پٹ اور 600 آؤٹ پٹ ٹوکنز۔ فی 1M ٹوکنز کی قیمتیں موجودہ ہیں اور ہمارے ٹیرف کے ساتھ تبدیل ہوتی ہیں؛ OpenRouter کالم اسی ورک لوڈ کے لیے حوالہ جاتی قیمتیں دکھاتا ہے۔
CheapTokens کالم کل میں ہے، ان پٹ اور آؤٹ پٹ ملا کر، جدول میں ہر ماڈل کے لیے OpenRouter سے سستا۔ اگر آپ usage کو چلتا ہوا بجٹ بنانا چاہتے ہیں، تو tracking agent token cost خیال Python میں دکھاتا ہے؛ حساب TypeScript میں بھی وہی ہے۔
streamText: الفاظ آتے ہی پرنٹ کریں#
چیٹ UI کے لیے آپ چاہتے ہیں کہ متن ظاہر ہو جبکہ ماڈل ابھی لکھ رہا ہو۔ streamText آپ کو متن کے ٹکڑوں کا ایک async iterable دیتا ہے۔
import { streamText } from 'ai';
import { cheaptokens } from './provider';

const result = streamText({
  model: cheaptokens('deepseek-ai/DeepSeek-V4-Flash-0731'),
  prompt: 'Write a 100-word product description for a pocket notebook.',
});

for await (const chunk of result.textStream) {
  process.stdout.write(chunk);
}

console.log('\n', await result.usage);
غور کریں کہ streamText(...) کے آگے کوئی await نہیں ہے: یہ فوراً واپس آتا ہے اور آپ اسٹریم استعمال کرتے ہیں۔ usage ایک promise ہے جو اسٹریم ختم ہونے پر طے ہوتا ہے، لہٰذا آپ اسے لوپ کے بعد await کرتے ہیں۔ Next.js روٹ ہینڈلر میں آپ stdout پر لکھنے کے بجائے اسٹریم براؤزر کو واپس کریں گے؛ پرووائیڈر کا حصہ بالکل یکساں ہے۔ اگر آپ سادہ OpenAI SDK کے ساتھ یہی چاہتے ہیں، تو streaming chat responses in Node.js دیکھیں۔
یہاں طویل جوابات ٹھیک ہیں: CheapTokens پر DeepSeek-V4-Flash ایک جواب میں 32,768 ٹوکن تک لکھ سکتا ہے، اس کی 380K کانٹیکسٹ ونڈو ہے اور کسی بھی وقت ایک ہی قیمت ہے۔ ماڈل کا صفحہ /en/cheap-deepseek/ پر ہے، اور موجودہ قیمتیں the pricing page پر ہیں۔
باقی سب کچھ چھیڑے بغیر ماڈل تبدیل کریں#
چونکہ صرف ماڈل آئی ڈی بدلتی ہے، دوسرا ماڈل آزمانا ایک لائن کی ترمیم ہے۔ GLM-5.3-Flash کی 390K کانٹیکسٹ ونڈو ہے اور یہ 8,192 ٹوکن تک جواب دیتا ہے؛ موجودہ قیمتوں پر اس کی لاگت $0.02 فی 1M ان پٹ ٹوکن اور $0.04 فی 1M آؤٹ پٹ ٹوکن ہے۔
خود آزمائیںآزمائیں: GLM-5.3-Flash پر وہی اسکرپٹ چلانے کے لیے آپ کون سی لائن بدلتے ہیں؟جواب دکھائیں
صرف ماڈل آئی ڈی: cheaptokens('zai-۔ پرووائیڈر، کلید، baseURL اور اسکرپٹ کا باقی حصہ ویسے ہی رہتا ہے۔
ایک کارآمد پیٹرن یہ ہے کہ آئی ڈی کو ماحولیاتی متغیر (process.) میں رکھیں تاکہ آپ دوبارہ بلڈ کے بغیر ایک ہی پرامپٹ پر دو ماڈلز کا موازنہ کر سکیں۔ DeepSeek vs GLM vs MiniMax comparison یہ منتخب کرنے میں مدد کرتا ہے کہ کون سے آزمانے کے قابل ہیں۔
اگر یہ کام نہ کرے#
زیادہ تر ناکامیاں تین چیزوں میں سے ایک ہوتی ہیں: کلید، URL یا ماڈل آئی ڈی۔
- 401 کا مطلب ہے کلید غائب یا غلط ہے۔ چیک کریں کہ
CHEAPTOKENS_اس شیل میں سیٹ ہے جو اسکرپٹ چلاتا ہے (Next.js سرور کو یہAPI_ KEY .env.localمیں اور ری اسٹارٹ درکار ہے)۔ - 404 کا عام طور پر مطلب ہے کہ baseURL نے اپنا
/v1کھو دیا یا ماڈل آئی ڈی مختصر نام ہے۔https:/اور مکمل آئی ڈی استعمال کریں۔/ api. cheaptokens. dev/ v1 - جواب درمیان میں رک جاتا ہے۔ ماڈل آؤٹ پٹ حد پر پہنچ گیا؛ finish_reason "length" fix اس کی وضاحت کرتا ہے۔
پہلی دو کے بارے میں طویل واک تھرو API 401 or 404: wrong key, base URL or model id میں ہے۔
چیک لسٹ
اسکرپٹ چلانے سے پہلے
دوسرے ٹولز کو جوڑنے اور ہاتھ سے پہلی درخواست کے لیے، CheapTokens docs سے شروع کریں۔


