API & SDKAnleitung
Vercel AI SDK mit einer benutzerdefinierten Base-URL: CheapTokens in TypeScript
Richte das Vercel AI SDK mit createOpenAICompatible auf CheapTokens aus: ein funktionierendes generateText- und streamText-Snippet, Token-Usage und Lösungen für häufige Fehler.
Auf dieser Seite
Um das Vercel AI SDK auf CheapTokens auszuführen, installiere @ai-, erstelle einen Provider mit baseURL: 'https:/ und deinem Key und übergib provider('deepseek- als model. Alles andere in deiner App, generateText, streamText, deine Prompts, bleibt wie es ist.
Wenn du also bereits eine Next.js-Route oder ein Node-Skript hast, das über das AI SDK mit einem gehosteten Modell spricht, änderst du drei Dinge: die Base-URL, den Key und die Modell-ID. Diese Anleitung prüft das Setup gegen die OpenAI-kompatible Provider-Seite des AI SDK (29. Oktober 2026). Sie nutzt die Chat-Completions-Schnittstelle der CheapTokens API, die dieser Provider spricht.
Installieren und den Provider erstellen#
Zwei Pakete: das Kernpaket ai und der OpenAI-kompatible Provider.
npm install ai @ai-sdk/openai-compatible
export CHEAPTOKENS_API_KEY=ct_your_key_here
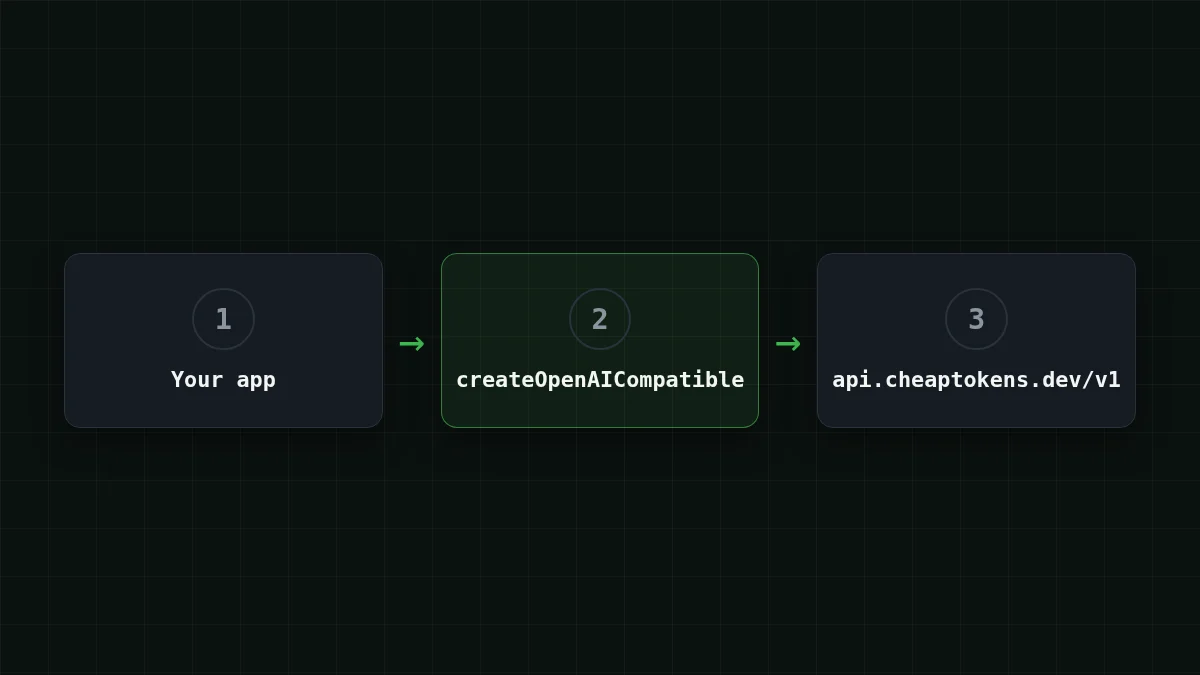
Die Reihenfolge ist kurz:
In die richtige Reihenfolge bringen
Bring das Setup in Ordnung
Ziehe die Elemente oder benutze die Pfeile
- Lade das Guthaben auf und erstelle einen API-Key
- Lege den Key in einer Umgebungsvariable ab
- Erstelle den Provider mit der CheapTokens baseURL
- Übergib die vollständige Modell-ID an generateText
Der Provider selbst ist ein Aufruf von createOpenAICompatible:
import { createOpenAICompatible } from '@ai-sdk/openai-compatible';

export const cheaptokens = createOpenAICompatible({
  name: 'cheaptokens',
  apiKey: process.env.CHEAPTOKENS_API_KEY,
  baseURL: 'https://api.cheaptokens.dev/v1',
  includeUsage: true,
});
name ist nur ein Label für deine eigenen Logs. includeUsage: true fordert Token-Zählungen auch in Streaming-Antworten an; ohne diese Option verhält sich der Standard wie false. Der Aufruf von cheaptokens('model- liefert dir ein Chat-Modell; cheaptokens. und cheaptokens. tun dasselbe.
Die Modell-ID muss die vollständige sein: deepseek-. Ein kurzer Name wie deepseek- ist das, was du in Preistabellen siehst, und die API akzeptiert ihn nicht. Wenn du nicht sicher bist, was du eingeben sollst, liste die Modelle mit GET /v1/models auf und kopiere die ID von dort.
generateText: eine Antwort und ihre Token-Zahl#
Hier ist ein vollständiges Skript. Es fragt nach einer kurzen Antwort und gibt sowohl den Text als auch das Usage-Objekt aus.
import { generateText } from 'ai';
import { cheaptokens } from './provider';

const result = await generateText({
  model: cheaptokens('deepseek-ai/DeepSeek-V4-Flash-0731'),
  prompt: 'Explain in two sentences what a base URL is.',
});

console.log(result.text);
console.log(result.usage);
Führe es mit npx tsx index.ts aus. Du erhältst die Antwort als String in result.text, und result.usage enthält die Input- und Output-Token-Zahlen für diesen Aufruf. Wir geben das ganze Objekt aus, damit du alles darin siehst. In der AI SDK-Referenz für streamText (geprüft am 29. Oktober 2026) hat usage die Felder inputTokens, outputTokens und totalTokens; prüfe die Typen deiner installierten Version, bevor du sie in ein Dashboard einbindest.
Warum überhaupt Usage lesen? Weil das die Zahl ist, die du bezahlst. Angenommen, deine App sendet einen Prompt mit 1.500 Tokens und erhält eine Antwort mit 600 Tokens. Diese Anfrage kostet $0.000083 zu aktuellen Preisen, und tausend davon sehen so aus:
| Modell | Input $/1M | Output $/1M | Pro Anfrage | 1.000 Anfragen | OpenRouter, 1.000 Anfragen |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000054 | $0.054 | $0.107 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000083 | $0.0825 | $0.165 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00017 | $0.165 | $1.17 |
1.500 Input- und 600 Output-Tokens pro Anfrage. Die Preise pro 1 Mio. Tokens sind aktuell und ändern sich zusammen mit unseren Tarifen; die OpenRouter-Spalte zeigt Referenzpreise für dieselbe Arbeitslast.
Die CheapTokens-Spalte ist insgesamt, Input und Output zusammen, für jedes Modell in der Tabelle günstiger als OpenRouter. Wenn du usage in ein laufendes Budget umwandeln willst, zeigt tracking agent token cost die Idee in Python; die Arithmetik ist in TypeScript dieselbe.
streamText: Wörter ausgeben, während sie eintreffen#
Für eine Chat-UI willst du, dass Text erscheint, während das Modell noch schreibt. streamText liefert dir einen asynchronen Iterator über Text-Chunks.
import { streamText } from 'ai';
import { cheaptokens } from './provider';

const result = streamText({
  model: cheaptokens('deepseek-ai/DeepSeek-V4-Flash-0731'),
  prompt: 'Write a 100-word product description for a pocket notebook.',
});

for await (const chunk of result.textStream) {
  process.stdout.write(chunk);
}

console.log('\n', await result.usage);
Beachte, dass vor streamText(...) kein await steht: Der Aufruf kehrt sofort zurück, und du konsumierst den Stream. usage ist ein Promise, das sich auflöst, wenn der Stream endet, also awaitest du es nach der Schleife. In einem Next.js-Route-Handler würdest du den Stream an den Browser zurückgeben, statt nach stdout zu schreiben; der Provider-Teil ist identisch. Wenn du dasselbe mit dem reinen OpenAI SDK willst, siehe streaming chat responses in Node.js.
Lange Antworten sind hier kein Problem: DeepSeek-V4-Flash auf CheapTokens kann bis zu 32.768 Tokens in einer Antwort schreiben, hat ein Kontextfenster von 380K und einen Preis zu jeder Stunde. Die Modellseite ist unter /en/cheap-deepseek/, und die aktuellen Preise stehen auf der Preisseite.
Das Modell wechseln, ohne den Rest anzufassen#
Da sich nur die Modell-ID ändert, ist das Ausprobieren eines anderen Modells eine Ein-Zeilen-Änderung. GLM-5.3-Flash hat ein Kontextfenster von 390K und antwortet mit bis zu 8.192 Tokens; zu aktuellen Preisen kostet es $0.02 pro 1M Input-Tokens und $0.04 pro 1M Output-Tokens.
Probier es selbstProbier es aus: Welche Zeile änderst du, um dasselbe Skript auf GLM-5.3-Flash laufen zu lassen?Antwort anzeigen
Nur die Modell-ID: cheaptokens('zai-. Der Provider, der Key, die baseURL und der Rest des Skripts bleiben gleich.
Ein praktisches Muster ist, die ID in einer Umgebungsvariable zu halten (process.), damit du zwei Modelle mit demselben Prompt ohne Rebuild vergleichen kannst. Der DeepSeek vs GLM vs MiniMax comparison hilft dir bei der Auswahl, welche es wert sind, ausprobiert zu werden.
Wenn es nicht funktioniert#
Die meisten Fehler sind eines von drei Dingen: der Key, die URL oder die Modell-ID.
- 401 bedeutet, dass der Key fehlt oder falsch ist. Prüfe, ob
CHEAPTOKENS_in der Shell gesetzt ist, die das Skript ausführt (ein Next.js-Server braucht ihn inAPI_ KEY .env.localund einen Neustart). - 404 bedeutet meistens, dass die baseURL ihr
/v1verloren hat oder die Modell-ID der kurze Name ist. Verwendehttps:/und die vollständige ID./ api. cheaptokens. dev/ v1 - Die Antwort bricht mitten im Satz ab. Das Modell hat ein Output-Limit erreicht; die finish_reason "length" fix erklärt das.
Die längere Erklärung der ersten beiden findest du in API 401 or 404: wrong key, base URL or model id.
Checkliste
Bevor du das Skript ausführst
Für das Anbinden anderer Tools und die erste Anfrage von Hand beginne mit der CheapTokens docs.


