API at SDKGabay
Vercel AI SDK na may custom base URL: CheapTokens sa TypeScript
Itutok ang Vercel AI SDK sa CheapTokens gamit ang createOpenAICompatible: gumaganang generateText at streamText snippet, token usage at mga fix para sa karaniwang error.
Sa pahinang ito
Para patakbuhin ang Vercel AI SDK sa CheapTokens, i-install ang @ai-, gumawa ng provider gamit ang baseURL: 'https:/ at ang iyong key, at ipasa ang provider('deepseek- bilang ang model. Ang lahat ng iba pa sa iyong app, generateText, streamText, ang iyong mga prompt, ay mananatiling gaya ng dati.
Kaya kung mayroon ka nang Next.js route o Node script na nakikipag-usap sa isang hosted model sa pamamagitan ng AI SDK, tatlong bagay ang babaguhin mo: ang base URL, ang key at ang model id. Sinusuri ng gabay na ito ang setup laban sa OpenAI-compatible providers page ng AI SDK (29 Oktubre 2026). Ginagamit nito ang Chat Completions interface ng CheapTokens API, na siyang sinasalita ng provider na iyon.
I-install at gumawa ng provider#
Dalawang package: ang core na ai package at ang OpenAI-compatible provider.
npm install ai @ai-sdk/openai-compatible
export CHEAPTOKENS_API_KEY=ct_your_key_here
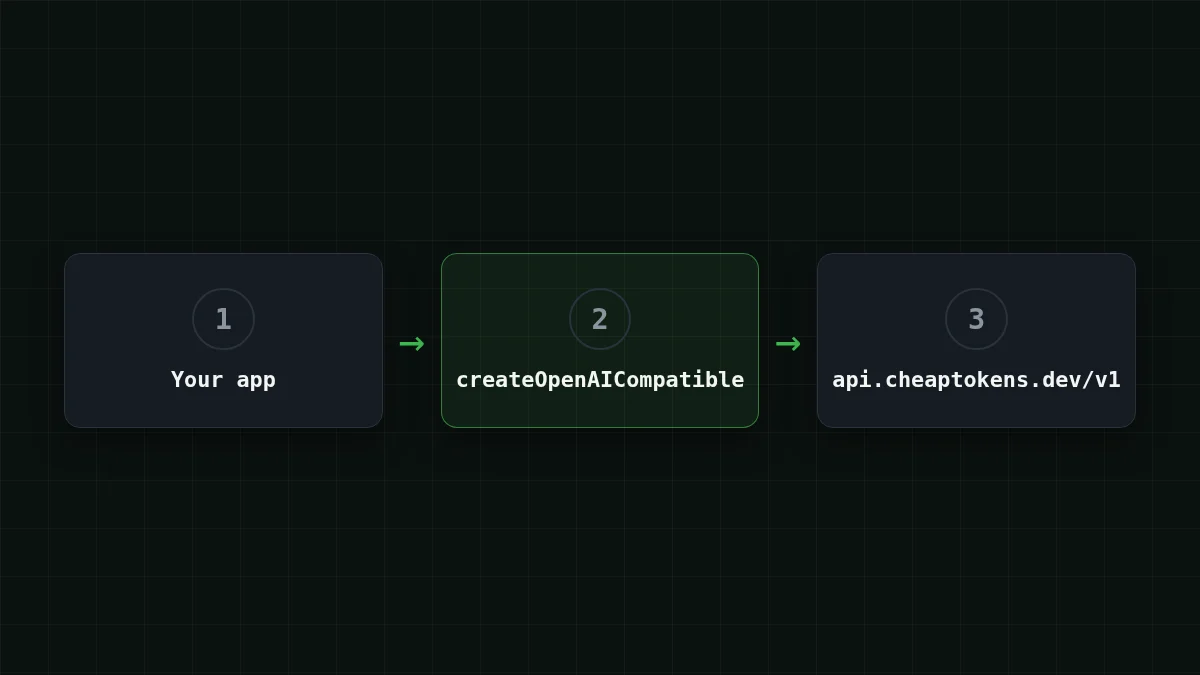
Maikli lang ang pagkakasunod-sunod ng trabaho:
Ilagay sa tamang pagkakasunod-sunod
Ayusin ang setup
I-drag ang mga item o gamitin ang mga arrow
- Mag-top up ng balanse at gumawa ng API key
- Ilagay ang key sa isang environment variable
- Gumawa ng provider gamit ang CheapTokens baseURL
- Ipasa ang buong model id sa generateText
Ang provider mismo ay isang tawag sa createOpenAICompatible:
import { createOpenAICompatible } from '@ai-sdk/openai-compatible';

export const cheaptokens = createOpenAICompatible({
  name: 'cheaptokens',
  apiKey: process.env.CHEAPTOKENS_API_KEY,
  baseURL: 'https://api.cheaptokens.dev/v1',
  includeUsage: true,
});
Ang name ay label lang para sa iyong sariling mga log. Hinihiling ng includeUsage: true ang token counts sa streaming responses din; kung wala ito, ang default ay kumikilos tulad ng false. Ang pagtawag sa cheaptokens('model- ay nagbibigay sa iyo ng chat model; ang cheaptokens. at cheaptokens. ay ganoon din ang ginagawa.
Kailangang buo ang model id: deepseek-. Ang maikling pangalan tulad ng deepseek- ang nakikita mo sa mga price table, at hindi ito tatanggapin ng API. Kung hindi ka sigurado kung ano ang ita-type, ilista ang mga model gamit ang GET /v1/models at kopyahin ang id mula doon.
generateText: isang sagot at ang token count nito#
Narito ang isang kumpletong script. Humihingi ito ng maikling sagot at ipinapakita ang parehong text at ang usage object.
import { generateText } from 'ai';
import { cheaptokens } from './provider';

const result = await generateText({
  model: cheaptokens('deepseek-ai/DeepSeek-V4-Flash-0731'),
  prompt: 'Explain in two sentences what a base URL is.',
});

console.log(result.text);
console.log(result.usage);
Patakbuhin ito gamit ang npx tsx index.ts. Makukuha mo ang sagot bilang string sa result.text, at ang result.usage ay naglalaman ng input at output token counts para sa tawag na iyon. Ipinapakita namin ang buong object para makita mo ang lahat ng laman nito. Sa AI SDK reference para sa streamText (sinuri 29 Oktubre 2026) ang usage ay may inputTokens, outputTokens at totalTokens; suriin ang mga type ng naka-install na bersyon bago ikabit ang mga ito sa isang dashboard.
Bakit pa babasahin ang usage? Dahil iyon ang bilang na binabayaran mo. Sabihin nating nagpapadala ang app mo ng 1,500-token prompt at nakakakuha ng 600-token na sagot. Ang request na iyon ay nagkakahalaga ng $0.000083 sa kasalukuyang presyo, at ganito ang hitsura ng isang libo nito:
| Modelo | Input $/1M | Output $/1M | Bawat kahilingan | 1,000 mga kahilingan | OpenRouter, 1,000 mga kahilingan |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000054 | $0.054 | $0.107 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000083 | $0.0825 | $0.165 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00017 | $0.165 | $1.17 |
1,500 input at 600 output na token bawat kahilingan. Ang mga presyo kada 1M token ay kasalukuyan at nagbabago kasabay ng aming mga taripa; ang column ng OpenRouter ay nagpapakita ng reference na presyo para sa parehong workload.
Ang column ng CheapTokens ay kabuuan, input at output na pinagsama, mas mura kaysa OpenRouter para sa bawat model sa table. Kung gusto mong gawing running budget ang usage, ipinapakita ng tracking agent token cost ang ideya sa Python; pareho ang aritmetika sa TypeScript.
streamText: i-print ang mga salita habang dumarating#
Para sa chat UI gusto mong lumitaw ang text habang nagsusulat pa ang model. Ang streamText ay nagbibigay sa iyo ng async iterable ng mga text chunk.
import { streamText } from 'ai';
import { cheaptokens } from './provider';

const result = streamText({
  model: cheaptokens('deepseek-ai/DeepSeek-V4-Flash-0731'),
  prompt: 'Write a 100-word product description for a pocket notebook.',
});

for await (const chunk of result.textStream) {
  process.stdout.write(chunk);
}

console.log('\n', await result.usage);
Pansinin na walang await sa harap ng streamText(...): agad itong bumabalik at ikaw ang kumokonsumo ng stream. Ang usage ay isang promise na nagtatapos kapag natapos ang stream, kaya i-await ito pagkatapos ng loop. Sa isang Next.js route handler, ibabalik mo ang stream sa browser sa halip na magsulat sa stdout; pareho lang ang bahagi ng provider. Kung gusto mo ang parehong bagay gamit ang plain OpenAI SDK, tingnan ang streaming chat responses sa Node.js.
Ayos lang ang mahahabang sagot dito: ang DeepSeek-V4-Flash sa CheapTokens ay makakasulat ng hanggang 32,768 token sa isang sagot, may 380K context window at isang presyo sa kahit anong oras. Ang model page ay nasa /en/cheap-deepseek/, at ang kasalukuyang presyo ay nasa pricing page.
Palitan ang model nang hindi hinahawakan ang iba#
Dahil model id lang ang nagbabago, isang linyang edit lang ang pagsubok ng ibang model. Ang GLM-5.3-Flash ay may 390K context window at sumasagot ng hanggang 8,192 token; sa kasalukuyang presyo, nagkakahalaga ito ng $0.02 kada 1M input token at $0.04 kada 1M output token.
Subukan mo mismoSubukan: aling linya ang babaguhin mo para patakbuhin ang parehong script sa GLM-5.3-Flash?Ipakita ang sagot
Ang model id lang: cheaptokens('zai-. Ang provider, ang key, ang baseURL at ang iba pang bahagi ng script ay mananatiling pareho.
Isang madaling pattern ay itago ang id sa isang environment variable (process.) para makapagkumpara ka ng dalawang model sa parehong prompt nang walang rebuild. Nakakatulong ang DeepSeek vs GLM vs MiniMax comparison sa pagpili kung alin ang sulit subukan.
Kung hindi gumana#
Karamihan ng pagkabigo ay isa sa tatlo: ang key, ang URL o ang model id.
- 401 ay nangangahulugang kulang o mali ang key. Tiyakin na naka-set ang
CHEAPTOKENS_sa shell na nagpapatakbo ng script (kailangan ito ng Next.js server saAPI_ KEY .env.localat kailangan ng restart). - 404 ay karaniwang nangangahulugang nawala ang
/v1sa baseURL o ang model id ay ang maikling pangalan. Gamitin anghttps:/at ang buong id./ api. cheaptokens. dev/ v1 - Huminto ang sagot sa gitna ng pangungusap. Naabot ng model ang output limit; ipinapaliwanag ito ng finish_reason "length" fix.
Ang mas mahabang walkthrough ng unang dalawa ay nasa API 401 o 404: maling key, base URL o model id.
Listahan ng dapat gawin
Bago patakbuhin ang script
Para sa pagkonekta ng iba pang tool at sa unang request nang manu-mano, magsimula sa CheapTokens docs.


