使用自定义 base URL 的 Vercel AI SDK:TypeScript 中的 CheapTokens
使用 createOpenAICompatible 将 Vercel AI SDK 指向 CheapTokens:可用的 generateText 和 streamText 代码片段、token 用量以及常见错误的修复方法。
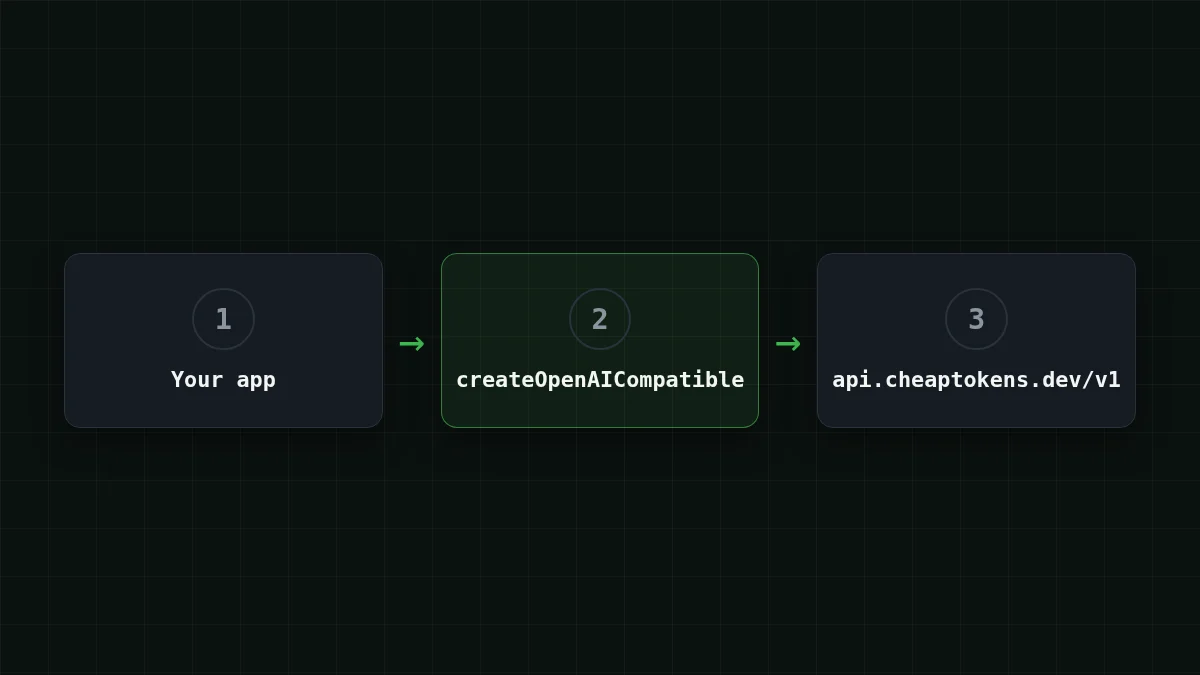
要在 CheapTokens 上运行 Vercel AI SDK,请安装 @ai-,使用 baseURL: 'https:/ 和你的密钥创建 provider,并将 provider('deepseek- 作为 model 传入。应用中的其他内容,包括 generateText、streamText 和你的提示词,都保持不变。
因此,如果你已经有一个 Next.js 路由或 Node 脚本,通过 AI SDK 与托管模型通信,你只需更改三处:base URL、密钥和模型 id。本指南依据 AI SDK 的 OpenAI 兼容 provider 页面(2026 年 10 月 29 日)核对了该配置。它使用 CheapTokens API 的 Chat Completions 接口,这正是该 provider 所使用的接口。
安装并创建 provider#
两个包:核心 ai 包和 OpenAI 兼容 provider。
npm install ai @ai-sdk/openai-compatible
export CHEAPTOKENS_API_KEY=ct_your_key_here
操作顺序很短:
排序
按顺序完成设置
拖动项目或使用箭头
- 充值余额并创建 API 密钥
- 将密钥放入环境变量
- 使用 CheapTokens baseURL 创建 provider
- 将完整模型 id 传给 generateText
provider 本身只需调用一次 createOpenAICompatible:
import { createOpenAICompatible } from '@ai-sdk/openai-compatible';

export const cheaptokens = createOpenAICompatible({
  name: 'cheaptokens',
  apiKey: process.env.CHEAPTOKENS_API_KEY,
  baseURL: 'https://api.cheaptokens.dev/v1',
  includeUsage: true,
});
name 只是你自己日志的标签。includeUsage: true 还会在流式响应中请求 token 计数;没有它时,默认行为等同于 false。调用 cheaptokens('model- 会得到一个聊天模型;cheaptokens. 和 cheaptokens. 的作用相同。
模型 id 必须是完整的:deepseek-。像 deepseek- 这样的短名称是你在价格表中看到的,API 不会接受它。如果不确定该输入什么,请使用 GET /v1/models 列出模型并从中复制 id。
generateText:一个回答及其 token 计数#
这是一个完整脚本。它请求一个简短回答,并打印文本和 usage 对象。
import { generateText } from 'ai';
import { cheaptokens } from './provider';

const result = await generateText({
  model: cheaptokens('deepseek-ai/DeepSeek-V4-Flash-0731'),
  prompt: 'Explain in two sentences what a base URL is.',
});

console.log(result.text);
console.log(result.usage);
使用 npx tsx index.ts 运行它。你会得到字符串形式的回答,位于 result.text 中,而 result.usage 保存该次调用的输入和输出 token 计数。我们打印整个对象,以便你看到其中的所有内容。在 streamText 的 AI SDK 参考文档(2026 年 10 月 29 日核对)中,usage 包含 inputTokens、outputTokens 和 totalTokens;在将它们接入仪表盘之前,请检查你所安装版本的类型。
为什么要读取 usage?因为这就是你付费所依据的数字。假设你的应用发送一个 1,500 token 的提示词,并得到 600 token 的回答。按当前价格,该请求花费 $0.000083,一千个这样的请求如下所示:
| 模型 | 输入 $/1M | 输出 $/1M | 每次请求 | 1,000 次请求 | OpenRouter,1,000 次请求 |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000054 | $0.054 | $0.107 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000083 | $0.0825 | $0.165 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00017 | $0.165 | $1.17 |
每次请求 1,500 个输入 token 和 600 个输出 token。每 100 万 token 的价格为当前价格,会随我们的资费一同变动;OpenRouter 列显示相同工作负载的参考价格。
CheapTokens 列是总计,即输入和输出合计,表中每个模型都比 OpenRouter 便宜。如果你想将 usage 变成运行中的预算,跟踪 agent token 成本用 Python 展示了这一思路;在 TypeScript 中算法相同。
streamText:在文字到达时打印#
对于聊天 UI,你希望模型仍在写作时文本就出现。streamText 会给你一个文本块的异步可迭代对象。
import { streamText } from 'ai';
import { cheaptokens } from './provider';

const result = streamText({
  model: cheaptokens('deepseek-ai/DeepSeek-V4-Flash-0731'),
  prompt: 'Write a 100-word product description for a pocket notebook.',
});

for await (const chunk of result.textStream) {
  process.stdout.write(chunk);
}

console.log('\n', await result.usage);
注意 streamText(...) 前面没有 await:它会立即返回,由你消费流。usage 是一个在流结束时完成的 promise,因此你在循环之后 await 它。在 Next.js 路由处理器中,你会将流返回给浏览器,而不是写入 stdout;provider 部分完全相同。如果你想用普通 OpenAI SDK 实现同样的事情,请参阅 Node.js 中的流式聊天响应。
长回答在这里没问题:CheapTokens 上的 DeepSeek-V4-Flash 一次回答最多可写 32,768 token,拥有 380K 上下文窗口,且任何时段价格相同。模型页面位于 /en/cheap-deepseek/,当前价格在价格页面上。
切换模型而不改动其余部分#
因为只有模型 id 变化,尝试另一个模型只需改一行。GLM-5.3-Flash 拥有 390K 上下文窗口,最多回答 8,192 token;按当前价格,每 1M 输入 token 花费 $0.02,每 1M 输出 token 花费 $0.04。
自己试试试一试:要使用同一脚本在 GLM-5.3-Flash 上运行,你需要更改哪一行?显示答案
只需更改模型 id:cheaptokens('zai-。provider、密钥、baseURL 和脚本其余部分保持不变。
一个方便的模式是将 id 放在环境变量中(process.),这样你无需重新构建即可在同一提示词上比较两个模型。DeepSeek vs GLM vs MiniMax 对比有助于挑选哪些值得尝试。
如果无法运行#
大多数失败是以下三种情况之一:密钥、URL 或模型 id。
- 401 表示密钥缺失或错误。检查运行脚本的 shell 中是否设置了
CHEAPTOKENS_(Next.js 服务器需要它在API_ KEY .env.local中并重启)。 - 404 通常表示 baseURL 丢失了
/v1,或者模型 id 是短名称。请使用https:/和完整 id。/ api. cheaptokens. dev/ v1 - 回答在句子中间停止。 模型触发了输出限制;finish_reason "length" 修复对此进行了解释。
关于前两种情况的更详细说明,请参阅 API 401 或 404:密钥、base URL 或模型 id 错误。
清单
运行脚本之前
要连接其他工具并手动发出第一个请求,请从 CheapTokens 文档开始。


