API та SDKПосібник
Vercel AI SDK із власним базовим URL: CheapTokens у TypeScript
Спрямуйте Vercel AI SDK на CheapTokens за допомогою createOpenAICompatible: робочі фрагменти generateText і streamText, використання токенів і виправлення типових помилок.
На цій сторінці
Щоб запустити Vercel AI SDK на CheapTokens, встановіть @ai-, створіть провайдер за допомогою baseURL: 'https:/ та вашого ключа і передайте provider('deepseek- як model. Усе інше у вашому застосунку, generateText, streamText, ваші промпти, залишається без змін.
Тож якщо у вас уже є маршрут Next.js або скрипт Node, який звертається до розміщеної моделі через AI SDK, ви змінюєте три речі: базовий URL, ключ і ідентифікатор моделі. Цей посібник звіряє налаштування зі сторінкою OpenAI-сумісних провайдерів AI SDK (29 жовтня 2026). Він використовує інтерфейс Chat Completions API CheapTokens, яким і спілкується цей провайдер.
Встановлення та створення провайдера#
Два пакети: основний пакет ai і OpenAI-сумісний провайдер.
npm install ai @ai-sdk/openai-compatible
export CHEAPTOKENS_API_KEY=ct_your_key_here
Порядок роботи короткий:
Розставте по порядку
Упорядкуйте налаштування
Перетягніть елементи або скористайтеся стрілками
- Поповніть баланс і створіть API-ключ
- Помістіть ключ у змінну середовища
- Створіть провайдер із baseURL CheapTokens
- Передайте повний ідентифікатор моделі в generateText
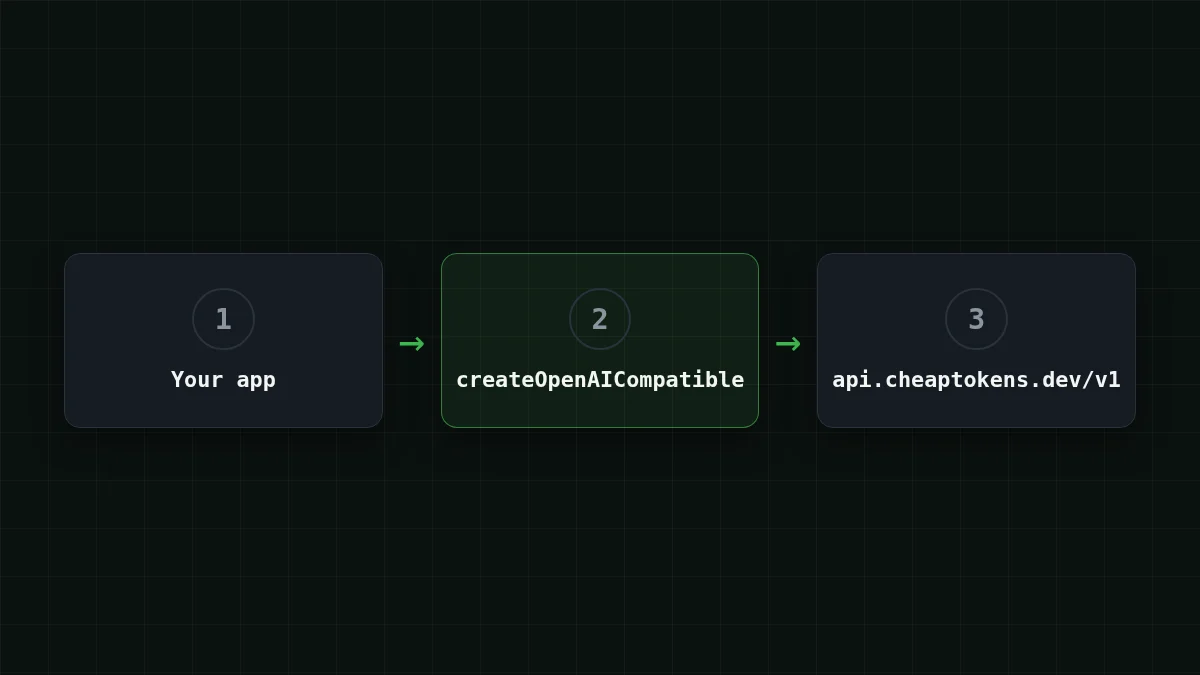
Сам провайдер — це один виклик createOpenAICompatible:
import { createOpenAICompatible } from '@ai-sdk/openai-compatible';

export const cheaptokens = createOpenAICompatible({
  name: 'cheaptokens',
  apiKey: process.env.CHEAPTOKENS_API_KEY,
  baseURL: 'https://api.cheaptokens.dev/v1',
  includeUsage: true,
});
name — це лише мітка для ваших власних логів. includeUsage: true також запитує кількість токенів у потокових відповідях; без нього типова поведінка еквівалентна false. Виклик cheaptokens('model- повертає чат-модель; cheaptokens. і cheaptokens. роблять те саме.
Ідентифікатор моделі має бути повним: deepseek-. Коротка назва на кшталт deepseek- — це те, що ви бачите в таблицях цін, і API її не прийме. Якщо ви не впевнені, що вводити, перелічіть моделі через GET /v1/models і скопіюйте ідентифікатор звідти.
generateText: одна відповідь і кількість її токенів#
Ось повний скрипт. Він просить коротку відповідь і виводить як текст, так і об'єкт usage.
import { generateText } from 'ai';
import { cheaptokens } from './provider';

const result = await generateText({
  model: cheaptokens('deepseek-ai/DeepSeek-V4-Flash-0731'),
  prompt: 'Explain in two sentences what a base URL is.',
});

console.log(result.text);
console.log(result.usage);
Запустіть його командою npx tsx index.ts. Ви отримаєте відповідь як рядок у result.text, а result.usage містить кількість вхідних і вихідних токенів для цього виклику. Ми виводимо весь об'єкт, щоб ви побачили все, що в ньому є. У довідці AI SDK для streamText (перевірено 29 жовтня 2026) usage має inputTokens, outputTokens і totalTokens; перевірте типи вашої встановленої версії, перш ніж підключати їх до дашборда.
Навіщо взагалі читати usage? Бо саме за це число ви платите. Скажімо, ваш застосунок надсилає промпт на 1 500 токенів і отримує відповідь на 600 токенів. Цей запит коштує $0.000083 за поточними цінами, а тисяча таких виглядає так:
| Модель | Вхід $/1М | Вихід $/1М | За запит | 1 000 запитів | OpenRouter, 1 000 запитів |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000054 | $0.054 | $0.107 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000083 | $0.0825 | $0.165 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00017 | $0.165 | $1.17 |
1 500 вхідних і 600 вихідних токенів на запит. Ціни за 1 млн токенів актуальні та змінюються разом із нашими тарифами; стовпець OpenRouter показує довідкові ціни для того самого навантаження.
Стовпець CheapTokens — це загальна сума, вхідні й вихідні разом, дешевше за OpenRouter для кожної моделі в таблиці. Якщо ви хочете перетворити usage на поточний бюджет, відстеження вартості токенів агента показує ідею на Python; арифметика та сама й у TypeScript.
streamText: друкуйте слова в міру їх надходження#
Для чат-інтерфейсу ви хочете, щоб текст з'являвся, поки модель ще пише. streamText повертає асинхронний ітерований об'єкт із фрагментами тексту.
import { streamText } from 'ai';
import { cheaptokens } from './provider';

const result = streamText({
  model: cheaptokens('deepseek-ai/DeepSeek-V4-Flash-0731'),
  prompt: 'Write a 100-word product description for a pocket notebook.',
});

for await (const chunk of result.textStream) {
  process.stdout.write(chunk);
}

console.log('\n', await result.usage);
Зверніть увагу, що перед streamText(...) немає await: він повертається одразу, і ви споживаєте потік. usage — це проміс, який завершується, коли потік закінчується, тож ви робите await для нього після циклу. В обробнику маршруту Next.js ви повернули б потік у браузер замість запису в stdout; частина з провайдером ідентична. Якщо ви хочете те саме зі звичайним OpenAI SDK, дивіться потокові відповіді чату в Node.js.
Довгі відповіді тут не проблема: DeepSeek-V4-Flash на CheapTokens може писати до 32 768 токенів в одній відповіді, має контекстне вікно 380K і одну ціну в будь-яку годину. Сторінка моделі — /en/cheap-deepseek/, а поточні ціни — на сторінці цін.
Змініть модель, не чіпаючи решту#
Оскільки змінюється лише ідентифікатор моделі, спроба іншої моделі — це редагування одного рядка. GLM-5.3-Flash має контекстне вікно 390K і відповідає до 8 192 токенів; за поточними цінами він коштує $0.02 за 1M вхідних токенів і $0.04 за 1M вихідних токенів.
Спробуйте саміСпробуйте: який рядок ви зміните, щоб запустити той самий скрипт на GLM-5.3-Flash?Показати відповідь
Лише ідентифікатор моделі: cheaptokens('zai-. Провайдер, ключ, baseURL і решта скрипта залишаються тими самими.
Зручний підхід — тримати ідентифікатор у змінній середовища (process.), щоб порівнювати дві моделі на одному промпті без перезбирання. Порівняння DeepSeek vs GLM vs MiniMax допомагає вибрати, які варто спробувати.
Якщо не працює#
Більшість збоїв — це одне з трьох: ключ, URL або ідентифікатор моделі.
- 401 означає, що ключ відсутній або неправильний. Перевірте, що
CHEAPTOKENS_встановлено в оболонці, яка запускає скрипт (серверу Next.js він потрібен уAPI_ KEY .env.localі перезапуск). - 404 зазвичай означає, що baseURL втратив
/v1або ідентифікатор моделі — це коротка назва. Використовуйтеhttps:/і повний ідентифікатор./ api. cheaptokens. dev/ v1 - Відповідь обривається на півслові. Модель досягла ліміту виводу; виправлення finish_reason "length" це пояснює.
Довший розбір перших двох — у API 401 або 404: неправильний ключ, базовий URL або ідентифікатор моделі.
Чек-лист
Перш ніж запускати скрипт
Щоб підключити інші інструменти й зробити перший запит вручну, почніть із документації CheapTokens.


