API e SDKGuida
Vercel AI SDK con una base URL personalizzata: CheapTokens in TypeScript
Punta il Vercel AI SDK su CheapTokens con createOpenAICompatible: uno snippet funzionante di generateText e streamText, l'uso dei token e le correzioni per gli errori comuni.
In questa pagina
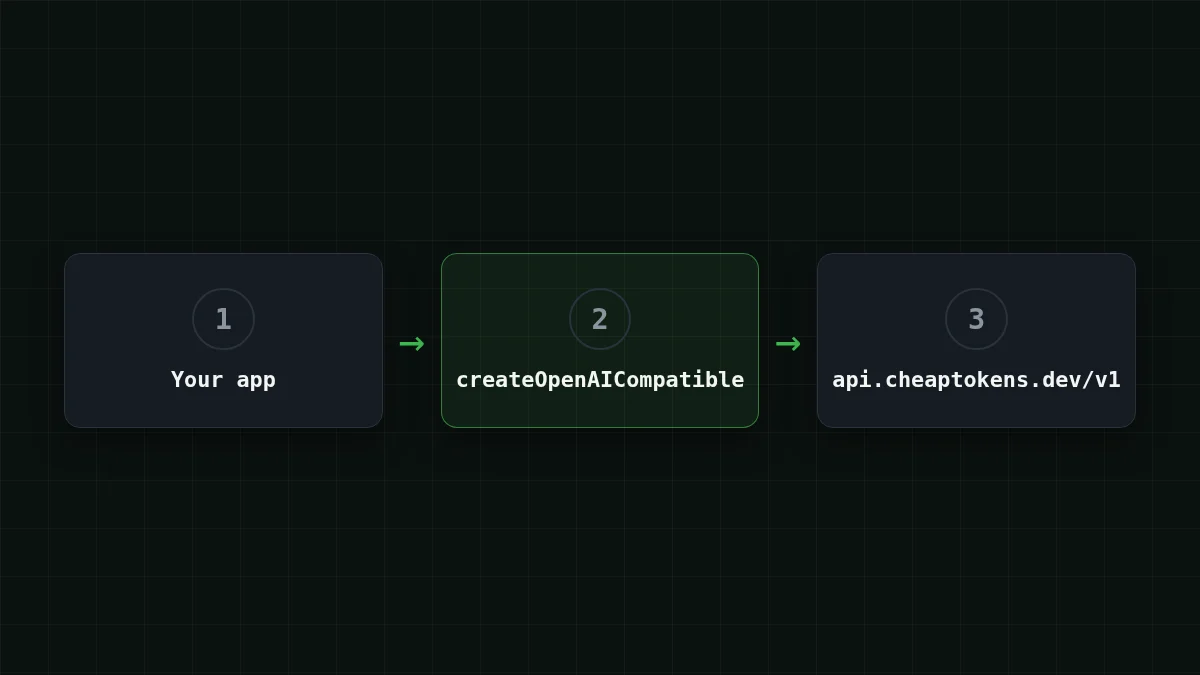
Per eseguire il Vercel AI SDK su CheapTokens, installa @ai-, crea un provider con baseURL: 'https:/ e la tua chiave, e passa provider('deepseek- come model. Tutto il resto della tua app, generateText, streamText, i tuoi prompt, resta com'è.
Quindi se hai già una route Next.js o uno script Node che parla con un modello ospitato tramite l'AI SDK, cambi tre cose: la base URL, la chiave e l'id del modello. Questa guida verifica la configurazione rispetto alla pagina dei provider compatibili con OpenAI dell'AI SDK (29 ottobre 2026). Usa l'interfaccia Chat Completions dell'API CheapTokens, che è quella che parla quel provider.
Installa e crea il provider#
Due pacchetti: il pacchetto core ai e il provider compatibile con OpenAI.
npm install ai @ai-sdk/openai-compatible
export CHEAPTOKENS_API_KEY=ct_your_key_here
L'ordine del lavoro è breve:
Metti in ordine
Metti in ordine la configurazione
Trascina gli elementi o usa le frecce
- Ricarica il saldo e crea una chiave API
- Metti la chiave in una variabile d'ambiente
- Crea il provider con la baseURL di CheapTokens
- Passa l'id completo del modello a generateText
Il provider stesso è una singola chiamata a createOpenAICompatible:
import { createOpenAICompatible } from '@ai-sdk/openai-compatible';

export const cheaptokens = createOpenAICompatible({
  name: 'cheaptokens',
  apiKey: process.env.CHEAPTOKENS_API_KEY,
  baseURL: 'https://api.cheaptokens.dev/v1',
  includeUsage: true,
});
name è solo un'etichetta per i tuoi log. includeUsage: true richiede i conteggi dei token anche nelle risposte in streaming; senza di esso il comportamento predefinito è come false. Chiamare cheaptokens('model- ti dà un modello chat; cheaptokens. e cheaptokens. fanno la stessa cosa.
L'id del modello deve essere quello completo: deepseek-. Un nome breve come deepseek- è quello che vedi nelle tabelle dei prezzi, e l'API non lo accetterà. Se non sei sicuro di cosa digitare, elenca i modelli con GET /v1/models e copia l'id da lì.
generateText: una risposta e il suo conteggio dei token#
Ecco uno script completo. Chiede una risposta breve e stampa sia il testo sia l'oggetto usage.
import { generateText } from 'ai';
import { cheaptokens } from './provider';

const result = await generateText({
  model: cheaptokens('deepseek-ai/DeepSeek-V4-Flash-0731'),
  prompt: 'Explain in two sentences what a base URL is.',
});

console.log(result.text);
console.log(result.usage);
Eseguilo con npx tsx index.ts. Ottieni la risposta come stringa in result.text, e result.usage contiene i conteggi dei token di input e output per quella chiamata. Stampiamo l'intero oggetto così vedi tutto ciò che contiene. Nel riferimento dell'AI SDK per streamText (verificato il 29 ottobre 2026) usage ha inputTokens, outputTokens e totalTokens; controlla i tipi della tua versione installata prima di collegarli a una dashboard.
Perché preoccuparsi di leggere usage? Perché è il numero che paghi. Supponi che la tua app invii un prompt da 1.500 token e riceva una risposta da 600 token. Quella richiesta costa $0.000083 ai prezzi attuali, e mille di queste sono così:
| Modello | Input $/1M | Output $/1M | Per richiesta | 1000 richieste | OpenRouter, 1000 richieste |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000054 | $0.054 | $0.107 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000083 | $0.0825 | $0.165 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00017 | $0.165 | $1.17 |
1500 token di input e 600 token di output per richiesta. I prezzi per 1M di token sono attuali e cambiano insieme alle nostre tariffe; la colonna OpenRouter mostra i prezzi di riferimento per lo stesso carico di lavoro.
La colonna CheapTokens è in totale, input e output insieme, più economica di OpenRouter per ogni modello della tabella. Se vuoi trasformare usage in un budget in corso, tracking agent token cost mostra l'idea in Python; l'aritmetica è la stessa in TypeScript.
streamText: stampa le parole mentre arrivano#
Per una UI di chat vuoi che il testo appaia mentre il modello sta ancora scrivendo. streamText ti dà un iterabile asincrono di chunk di testo.
import { streamText } from 'ai';
import { cheaptokens } from './provider';

const result = streamText({
  model: cheaptokens('deepseek-ai/DeepSeek-V4-Flash-0731'),
  prompt: 'Write a 100-word product description for a pocket notebook.',
});

for await (const chunk of result.textStream) {
  process.stdout.write(chunk);
}

console.log('\n', await result.usage);
Nota che non c'è await davanti a streamText(...): restituisce subito e consumi lo stream. usage è una promise che si risolve quando lo stream termina, quindi la attendi dopo il loop. In un route handler Next.js restituiresti lo stream al browser invece di scrivere su stdout; la parte del provider è identica. Se vuoi la stessa cosa con il semplice SDK OpenAI, vedi streaming chat responses in Node.js.
Le risposte lunghe vanno bene qui: DeepSeek-V4-Flash su CheapTokens può scrivere fino a 32.768 token in una risposta, ha una finestra di contesto di 380K e un unico prezzo a qualsiasi ora. La pagina del modello è su /en/cheap-deepseek/, e i prezzi attuali sono sulla pagina dei prezzi.
Cambia il modello senza toccare il resto#
Poiché cambia solo l'id del modello, provare un altro modello è una modifica di una riga. GLM-5.3-Flash ha una finestra di contesto di 390K e risponde fino a 8.192 token; ai prezzi attuali costa $0.02 per 1M token di input e $0.04 per 1M token di output.
Provalo tu stessoProva: quale riga cambi per eseguire lo stesso script su GLM-5.3-Flash?Mostra risposta
Solo l'id del modello: cheaptokens('zai-. Il provider, la chiave, la baseURL e il resto dello script restano uguali.
Un pattern utile è tenere l'id in una variabile d'ambiente (process.) così puoi confrontare due modelli sullo stesso prompt senza un rebuild. Il confronto DeepSeek vs GLM vs MiniMax aiuta a scegliere quali vale la pena provare.
Se non funziona#
La maggior parte dei fallimenti è una di tre cose: la chiave, l'URL o l'id del modello.
- 401 significa che la chiave manca o è sbagliata. Controlla che
CHEAPTOKENS_sia impostata nella shell che esegue lo script (un server Next.js la richiede inAPI_ KEY .env.locale un riavvio). - 404 di solito significa che la baseURL ha perso il suo
/v1o che l'id del modello è il nome breve. Usahttps:/e l'id completo./ api. cheaptokens. dev/ v1 - La risposta si interrompe a metà frase. Il modello ha raggiunto un limite di output; la correzione di finish_reason "length" lo spiega.
La spiegazione più lunga delle prime due è in API 401 o 404: chiave, base URL o id del modello sbagliati.
Lista di controllo
Prima di eseguire lo script
Per collegare altri strumenti e la prima richiesta a mano, parti dalla documentazione di CheapTokens.


