API & SDKHướng dẫn
Vercel AI SDK với base URL tùy chỉnh: CheapTokens trong TypeScript
Trỏ Vercel AI SDK vào CheapTokens với createOpenAICompatible: đoạn mã generateText và streamText hoạt động, cách đọc token usage và cách sửa các lỗi thường gặp.
Trên trang này
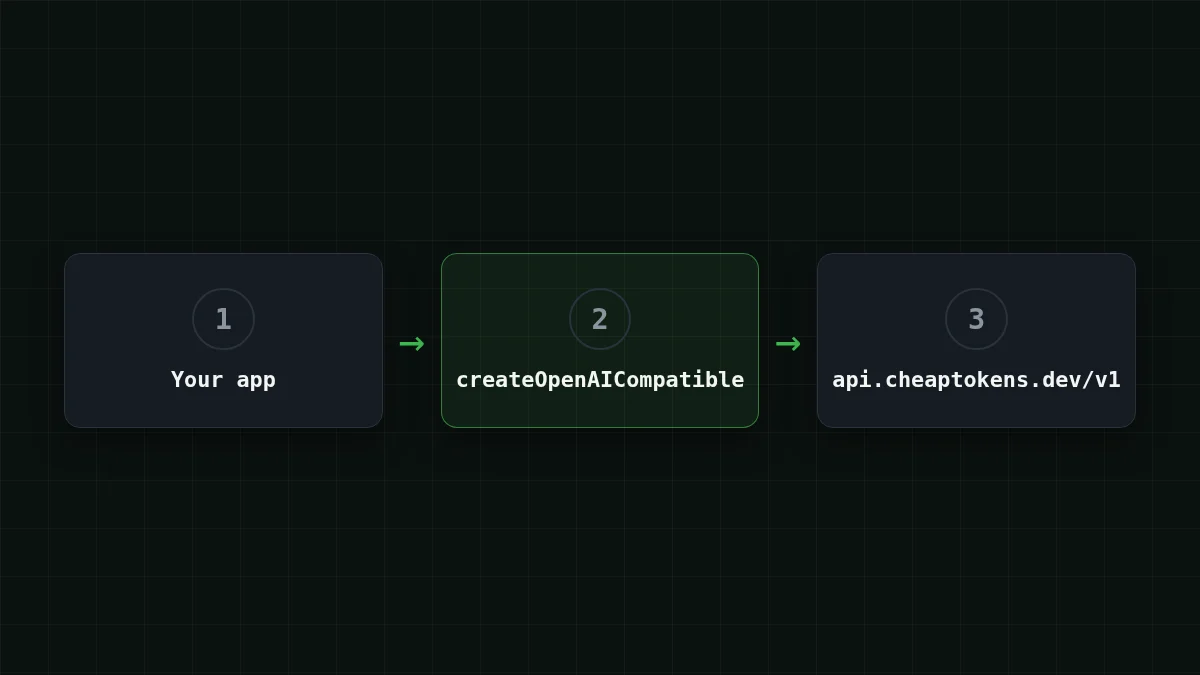
Để chạy Vercel AI SDK trên CheapTokens, hãy cài @ai-, tạo một provider với baseURL: 'https:/ và key của bạn, rồi truyền provider('deepseek- làm model. Mọi thứ khác trong ứng dụng của bạn, generateText, streamText, các prompt của bạn, vẫn giữ nguyên.
Vì vậy nếu bạn đã có một route Next.js hoặc một script Node nói chuyện với một model được host qua AI SDK, bạn chỉ cần thay đổi ba thứ: base URL, key và model id. Hướng dẫn này kiểm tra thiết lập dựa trên trang các provider tương thích OpenAI của AI SDK (29 tháng 10 năm 2026). Nó dùng giao diện Chat Completions của API CheapTokens, đúng thứ mà provider đó sử dụng.
Cài đặt và tạo provider#
Hai package: package lõi ai và provider tương thích OpenAI.
npm install ai @ai-sdk/openai-compatible
export CHEAPTOKENS_API_KEY=ct_your_key_here
Thứ tự công việc rất ngắn:
Sắp xếp thứ tự
Sắp xếp thiết lập theo thứ tự
Kéo các mục hoặc dùng mũi tên
- Nạp tiền vào số dư và tạo một API key
- Đặt key vào một biến môi trường
- Tạo provider với baseURL của CheapTokens
- Truyền model id đầy đủ vào generateText
Bản thân provider chỉ là một lời gọi createOpenAICompatible:
import { createOpenAICompatible } from '@ai-sdk/openai-compatible';

export const cheaptokens = createOpenAICompatible({
  name: 'cheaptokens',
  apiKey: process.env.CHEAPTOKENS_API_KEY,
  baseURL: 'https://api.cheaptokens.dev/v1',
  includeUsage: true,
});
name chỉ là một nhãn cho log của riêng bạn. includeUsage: true yêu cầu số lượng token cả trong phản hồi streaming; nếu không có nó, mặc định sẽ hoạt động như false. Gọi cheaptokens('model- cho bạn một chat model; cheaptokens. và cheaptokens. làm điều tương tự.
Model id phải là id đầy đủ: deepseek-. Một tên ngắn như deepseek- là thứ bạn thấy trong bảng giá, và API sẽ không chấp nhận nó. Nếu bạn không chắc nên gõ gì, hãy liệt kê các model bằng GET /v1/models và sao chép id từ đó.
generateText: một câu trả lời và số token của nó#
Đây là một script hoàn chỉnh. Nó yêu cầu một câu trả lời ngắn và in cả văn bản lẫn đối tượng usage.
import { generateText } from 'ai';
import { cheaptokens } from './provider';

const result = await generateText({
  model: cheaptokens('deepseek-ai/DeepSeek-V4-Flash-0731'),
  prompt: 'Explain in two sentences what a base URL is.',
});

console.log(result.text);
console.log(result.usage);
Chạy nó bằng npx tsx index.ts. Bạn nhận được câu trả lời dưới dạng chuỗi trong result.text, và result.usage chứa số lượng token đầu vào và đầu ra cho lời gọi đó. Chúng tôi in toàn bộ đối tượng để bạn thấy mọi thứ trong đó. Trong tài liệu tham khảo AI SDK cho streamText (kiểm tra ngày 29 tháng 10 năm 2026) usage có inputTokens, outputTokens và totalTokens; hãy kiểm tra kiểu của phiên bản bạn đã cài trước khi đưa chúng vào dashboard.
Tại sao phải bận tâm đọc usage? Vì đó là con số bạn phải trả tiền. Giả sử ứng dụng của bạn gửi một prompt 1.500 token và nhận được câu trả lời 600 token. Request đó tốn $0.000083 theo giá hiện tại, và một nghìn request như vậy trông như thế này:
| Mô hình | Đầu vào $/1M | Đầu ra $/1M | Mỗi yêu cầu | 1.000 yêu cầu | OpenRouter, 1.000 yêu cầu |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000054 | $0.054 | $0.107 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000083 | $0.0825 | $0.165 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00017 | $0.165 | $1.17 |
1.500 token đầu vào và 600 token đầu ra mỗi yêu cầu. Giá trên 1 triệu token là giá hiện hành và thay đổi cùng với biểu phí của chúng tôi; cột OpenRouter hiển thị giá tham chiếu cho cùng khối lượng công việc.
Cột CheapTokens là tổng cộng, đầu vào và đầu ra gộp lại, rẻ hơn OpenRouter cho mọi model trong bảng. Nếu bạn muốn biến usage thành một ngân sách đang chạy, theo dõi chi phí token của agent trình bày ý tưởng bằng Python; phép tính tương tự trong TypeScript.
streamText: in từng chữ khi chúng đến#
Với một giao diện chat, bạn muốn văn bản xuất hiện trong khi model vẫn đang viết. streamText cho bạn một async iterable các đoạn văn bản.
import { streamText } from 'ai';
import { cheaptokens } from './provider';

const result = streamText({
  model: cheaptokens('deepseek-ai/DeepSeek-V4-Flash-0731'),
  prompt: 'Write a 100-word product description for a pocket notebook.',
});

for await (const chunk of result.textStream) {
  process.stdout.write(chunk);
}

console.log('\n', await result.usage);
Lưu ý không có await trước streamText(...): nó trả về ngay lập tức và bạn tiêu thụ stream. usage là một promise hoàn tất khi stream kết thúc, nên bạn await nó sau vòng lặp. Trong một route handler Next.js, bạn sẽ trả stream về trình duyệt thay vì ghi ra stdout; phần provider hoàn toàn giống nhau. Nếu bạn muốn điều tương tự với OpenAI SDK thuần, xem streaming phản hồi chat trong Node.js.
Câu trả lời dài không thành vấn đề ở đây: DeepSeek-V4-Flash trên CheapTokens có thể viết tới 32.768 token trong một câu trả lời, có cửa sổ ngữ cảnh 380K và một mức giá bất kể giờ nào. Trang model ở /en/cheap-deepseek/, và giá hiện tại ở trang giá.
Đổi model mà không động đến phần còn lại#
Vì chỉ có model id thay đổi, thử một model khác chỉ là sửa một dòng. GLM-5.3-Flash có cửa sổ ngữ cảnh 390K và trả lời tối đa 8.192 token; theo giá hiện tại nó tốn $0.02 cho mỗi 1M token đầu vào và $0.04 cho mỗi 1M token đầu ra.
Tự mình thử xemThử xem: bạn đổi dòng nào để chạy cùng script đó trên GLM-5.3-Flash?Hiện đáp án
Chỉ model id: cheaptokens('zai-. Provider, key, baseURL và phần còn lại của script giữ nguyên.
Một mẫu hữu ích là giữ id trong một biến môi trường (process.) để bạn có thể so sánh hai model trên cùng một prompt mà không cần build lại. So sánh DeepSeek vs GLM vs MiniMax giúp chọn những model đáng thử.
Nếu nó không hoạt động#
Hầu hết lỗi là một trong ba thứ: key, URL hoặc model id.
- 401 nghĩa là key bị thiếu hoặc sai. Kiểm tra rằng
CHEAPTOKENS_được đặt trong shell chạy script (một server Next.js cần nó trongAPI_ KEY .env.localvà cần khởi động lại). - 404 thường nghĩa là baseURL bị mất
/v1hoặc model id là tên ngắn. Dùnghttps:/và id đầy đủ./ api. cheaptokens. dev/ v1 - Câu trả lời dừng giữa câu. Model đã chạm giới hạn đầu ra; cách sửa finish_reason "length" giải thích điều đó.
Hướng dẫn dài hơn về hai lỗi đầu nằm trong API 401 hoặc 404: sai key, base URL hoặc model id.
Danh sách kiểm tra
Trước khi chạy script
Để kết nối các công cụ khác và thực hiện request đầu tiên bằng tay, hãy bắt đầu từ tài liệu CheapTokens.


