API & SDK가이드
커스텀 base URL과 함께 Vercel AI SDK 사용하기: TypeScript에서 CheapTokens
createOpenAICompatible로 Vercel AI SDK를 CheapTokens에 연결하세요: 작동하는 generateText 및 streamText 스니펫, 토큰 사용량, 일반적인 오류 해결 방법.
이 페이지의 내용
Vercel AI SDK를 CheapTokens에서 실행하려면 @ai-를 설치하고, baseURL: 'https:/과 키로 프로바이더를 생성한 뒤 provider('deepseek-를 model로 전달하세요. 앱의 나머지 부분, generateText, streamText, 프롬프트는 그대로 유지됩니다.
AI SDK를 통해 호스팅 모델과 통신하는 Next.js 라우트나 Node 스크립트가 이미 있다면, 세 가지만 바꾸면 됩니다: base URL, 키, 모델 id입니다. 이 가이드는 AI SDK의 OpenAI 호환 프로바이더 페이지(2026년 10월 29일)를 기준으로 설정을 확인합니다. 해당 프로바이더가 사용하는 CheapTokens API의 Chat Completions 인터페이스를 사용합니다.
설치 및 프로바이더 생성#
두 개의 패키지가 필요합니다: 코어 ai 패키지와 OpenAI 호환 프로바이더입니다.
npm install ai @ai-sdk/openai-compatible
export CHEAPTOKENS_API_KEY=ct_your_key_here
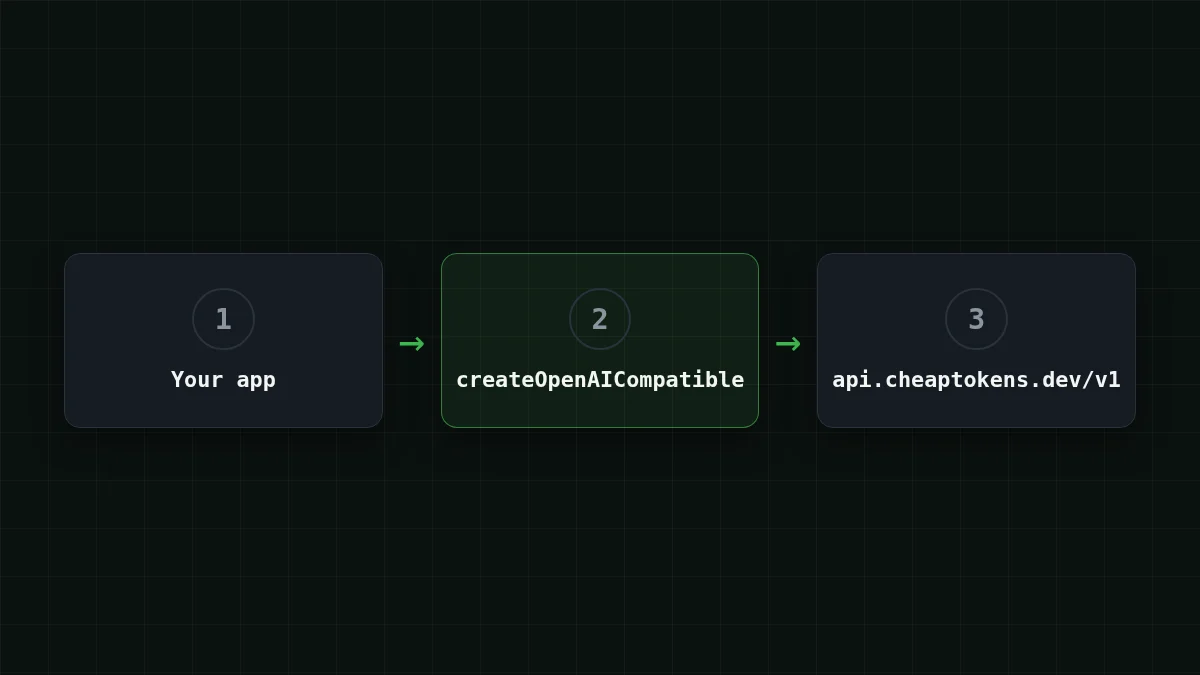
작업 순서는 짧습니다:
순서대로 배열하기
설정 순서 정리
항목을 드래그하거나 화살표를 사용하세요
- 잔액을 충전하고 API 키 생성
- 키를 환경 변수에 저장
- CheapTokens baseURL로 프로바이더 생성
- generateText에 전체 모델 id 전달
프로바이더 자체는 createOpenAICompatible에 대한 한 번의 호출입니다:
import { createOpenAICompatible } from '@ai-sdk/openai-compatible';

export const cheaptokens = createOpenAICompatible({
  name: 'cheaptokens',
  apiKey: process.env.CHEAPTOKENS_API_KEY,
  baseURL: 'https://api.cheaptokens.dev/v1',
  includeUsage: true,
});name은 자신의 로그를 위한 라벨일 뿐입니다. includeUsage: true는 스트리밍 응답에서도 토큰 수를 요청합니다. 이것이 없으면 기본 동작은 false처럼 동작합니다. cheaptokens('model-을 호출하면 채팅 모델을 얻습니다. cheaptokens.과 cheaptokens.도 같은 역할을 합니다.
모델 id는 전체 id여야 합니다: deepseek-. deepseek- 같은 짧은 이름은 가격표에서 보이는 것이며 API는 이를 허용하지 않습니다. 무엇을 입력해야 할지 모르겠다면 GET /v1/models로 모델 목록을 조회하고 거기서 id를 복사하세요.
generateText: 하나의 답변과 토큰 수#
다음은 완전한 스크립트입니다. 짧은 답변을 요청하고 텍스트와 usage 객체를 모두 출력합니다.
import { generateText } from 'ai';
import { cheaptokens } from './provider';

const result = await generateText({
  model: cheaptokens('deepseek-ai/DeepSeek-V4-Flash-0731'),
  prompt: 'Explain in two sentences what a base URL is.',
});

console.log(result.text);
console.log(result.usage);
npx tsx index.ts로 실행하세요. 답변은 result.text에 문자열로 들어오고, result.usage에는 해당 호출의 입력 및 출력 토큰 수가 담깁니다. 객체 전체를 출력하므로 모든 내용을 볼 수 있습니다. streamText에 대한 AI SDK 레퍼런스(2026년 10월 29일 확인)에서 usage에는 inputTokens, outputTokens, totalTokens이 있습니다. 대시보드에 연결하기 전에 설치된 버전의 타입을 확인하세요.
왜 usage를 읽어야 할까요? 그것이 바로 지불하는 숫자이기 때문입니다. 앱이 1,500토큰 프롬프트를 보내고 600토큰 답변을 받는다고 가정해 봅시다. 해당 요청은 현재 가격으로 $0.000083이며, 1,000번이면 다음과 같습니다:
| 모델 | 입력 $/1M | 출력 $/1M | 요청당 | 1,000회 요청 | OpenRouter, 1,000회 요청 |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000054 | $0.054 | $0.107 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000083 | $0.0825 | $0.165 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00017 | $0.165 | $1.17 |
요청당 입력 1,500개 및 출력 600개 토큰입니다. 100만 토큰당 가격은 현재 기준이며 당사 요금제에 따라 함께 변경됩니다. OpenRouter 열은 동일한 작업량에 대한 참고 가격을 보여줍니다.
CheapTokens 열은 입력과 출력을 합한 총액이며, 표의 모든 모델에서 OpenRouter보다 저렴합니다. usage를 실행 예산으로 바꾸고 싶다면 에이전트 토큰 비용 추적에서 Python으로 아이디어를 보여줍니다. 계산 방식은 TypeScript에서도 동일합니다.
streamText: 도착하는 대로 단어 출력#
채팅 UI에서는 모델이 아직 작성 중일 때 텍스트가 나타나길 원합니다. streamText은 텍스트 청크의 비동기 이터러블을 제공합니다.
import { streamText } from 'ai';
import { cheaptokens } from './provider';

const result = streamText({
  model: cheaptokens('deepseek-ai/DeepSeek-V4-Flash-0731'),
  prompt: 'Write a 100-word product description for a pocket notebook.',
});

for await (const chunk of result.textStream) {
  process.stdout.write(chunk);
}

console.log('\n', await result.usage);
streamText(...) 앞에 await가 없다는 점에 주목하세요. 즉시 반환되고 스트림을 소비합니다. usage은 스트림이 끝날 때 완료되는 프로미스이므로 루프 후에 await합니다. Next.js 라우트 핸들러에서는 stdout에 쓰는 대신 스트림을 브라우저로 반환합니다. 프로바이더 부분은 동일합니다. 일반 OpenAI SDK로 같은 작업을 하려면 Node.js에서 채팅 응답 스트리밍을 참고하세요.
긴 답변도 여기서는 문제없습니다. CheapTokens의 DeepSeek-V4-Flash는 한 답변에서 최대 32,768토큰을 작성할 수 있고, 380K 컨텍스트 윈도우를 가지며 시간대와 관계없이 단일 가격입니다. 모델 페이지는 /en/cheap-deepseek/에 있고, 현재 가격은 가격 페이지에 있습니다.
나머지는 건드리지 않고 모델 전환#
모델 id만 바뀌므로 다른 모델을 시도하는 것은 한 줄 수정입니다. GLM-5.3-Flash는 390K 컨텍스트 윈도우를 가지고 최대 8,192토큰까지 답변합니다. 현재 가격으로 1M 입력 토큰당 $0.02, 1M 출력 토큰당 $0.04입니다.
직접 해보기시도해 보세요: 같은 스크립트를 GLM-5.3-Flash에서 실행하려면 어느 줄을 바꿔야 할까요?정답 보기
모델 id만 바꾸면 됩니다: cheaptokens('zai-. 프로바이더, 키, baseURL 및 스크립트의 나머지는 그대로 유지됩니다.
유용한 패턴은 id를 환경 변수(process.)에 두어 재빌드 없이 같은 프롬프트에서 두 모델을 비교하는 것입니다. DeepSeek vs GLM vs MiniMax 비교는 어떤 모델을 시도해 볼 가치가 있는지 선택하는 데 도움이 됩니다.
작동하지 않을 때#
대부분의 실패는 세 가지 중 하나입니다: 키, URL 또는 모델 id입니다.
- 401은 키가 없거나 잘못되었음을 의미합니다. 스크립트를 실행하는 셸에
CHEAPTOKENS_가 설정되어 있는지 확인하세요(Next.js 서버는API_ KEY .env.local에 있어야 하며 재시작이 필요합니다). - 404는 보통 baseURL에서
/v1가 빠졌거나 모델 id가 짧은 이름임을 의미합니다.https:/와 전체 id를 사용하세요./ api. cheaptokens. dev/ v1 - 답변이 문장 중간에 멈춤. 모델이 출력 한도에 도달했습니다. finish_reason "length" 수정에서 설명합니다.
처음 두 가지에 대한 더 긴 설명은 API 401 또는 404: 잘못된 키, base URL 또는 모델 id에 있습니다.
체크리스트
스크립트를 실행하기 전에
다른 도구 연결과 첫 요청을 직접 수행하려면 CheapTokens 문서에서 시작하세요.


