API e SDKGuia
Vercel AI SDK com uma base URL personalizada: CheapTokens em TypeScript
Aponte o Vercel AI SDK para o CheapTokens com createOpenAICompatible: um snippet funcional de generateText e streamText, uso de tokens e correções para erros comuns.
Nesta página
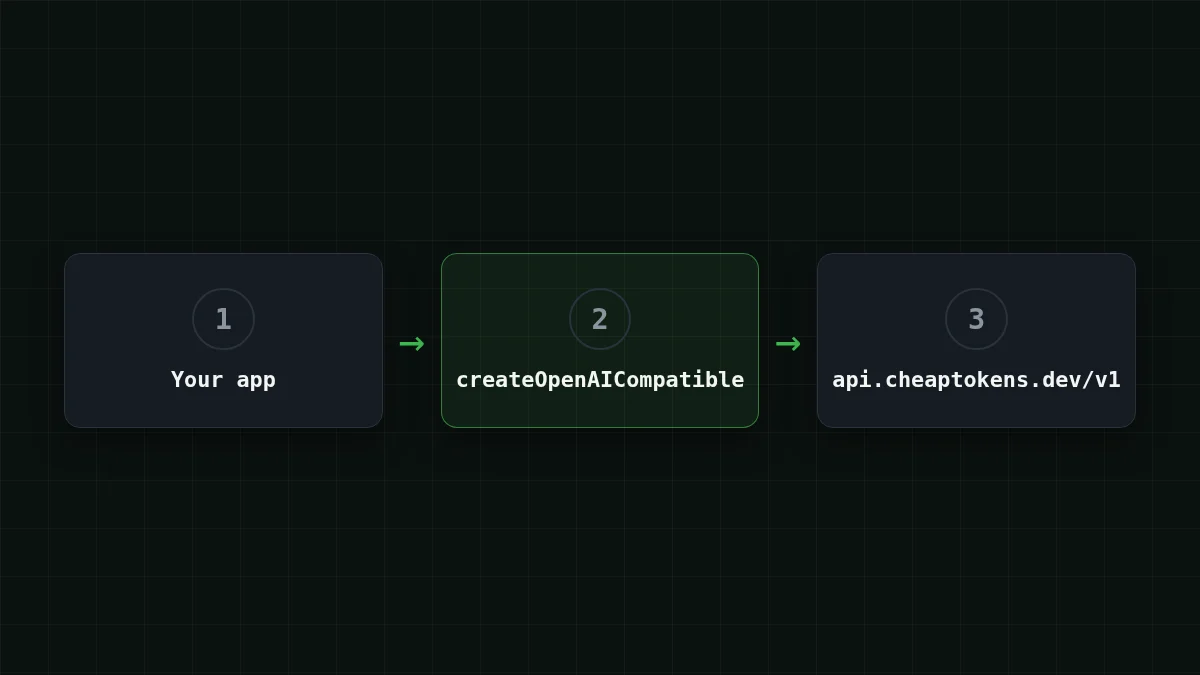
Para executar o Vercel AI SDK no CheapTokens, instale @ai-, crie um provider com baseURL: 'https:/ e sua chave, e passe provider('deepseek- como o model. Todo o resto no seu app, generateText, streamText, seus prompts, permanece como está.
Então, se você já tem uma rota Next.js ou um script Node que conversa com um modelo hospedado através do AI SDK, você muda três coisas: a base URL, a chave e o id do modelo. Este guia verifica a configuração contra a página de providers compatíveis com OpenAI do AI SDK (29 de outubro de 2026). Ele usa a interface Chat Completions da API do CheapTokens, que é o que esse provider fala.
Instale e crie o provider#
Dois pacotes: o pacote principal ai e o provider compatível com OpenAI.
npm install ai @ai-sdk/openai-compatible
export CHEAPTOKENS_API_KEY=ct_your_key_here
A ordem do trabalho é curta:
Colocar em ordem
Coloque a configuração em ordem
Arraste os itens ou use as setas
- Recarregue o saldo e crie uma chave de API
- Coloque a chave em uma variável de ambiente
- Crie o provider com a baseURL do CheapTokens
- Passe o id completo do modelo para generateText
O provider em si é uma chamada a createOpenAICompatible:
import { createOpenAICompatible } from '@ai-sdk/openai-compatible';

export const cheaptokens = createOpenAICompatible({
  name: 'cheaptokens',
  apiKey: process.env.CHEAPTOKENS_API_KEY,
  baseURL: 'https://api.cheaptokens.dev/v1',
  includeUsage: true,
});
name é apenas um rótulo para seus próprios logs. includeUsage: true pede contagens de tokens também em respostas de streaming; sem ele, o padrão se comporta como false. Chamar cheaptokens('model- retorna um modelo de chat; cheaptokens. e cheaptokens. fazem a mesma coisa.
O id do modelo precisa ser o completo: deepseek-. Um nome curto como deepseek- é o que você vê nas tabelas de preços, e a API não vai aceitá-lo. Se você não tem certeza do que digitar, liste os modelos com GET /v1/models e copie o id de lá.
generateText: uma resposta e sua contagem de tokens#
Aqui está um script completo. Ele pede uma resposta curta e imprime tanto o texto quanto o objeto usage.
import { generateText } from 'ai';
import { cheaptokens } from './provider';

const result = await generateText({
  model: cheaptokens('deepseek-ai/DeepSeek-V4-Flash-0731'),
  prompt: 'Explain in two sentences what a base URL is.',
});

console.log(result.text);
console.log(result.usage);
Execute com npx tsx index.ts. Você recebe a resposta como string em result.text, e result.usage contém as contagens de tokens de entrada e saída daquela chamada. Imprimimos o objeto inteiro para que você veja tudo nele. Na referência do AI SDK para streamText (verificada em 29 de outubro de 2026) usage tem inputTokens, outputTokens e totalTokens; verifique os tipos da sua versão instalada antes de conectá-los a um dashboard.
Por que se dar ao trabalho de ler o usage? Porque esse é o número pelo qual você paga. Digamos que seu app envie um prompt de 1.500 tokens e receba uma resposta de 600 tokens. Essa requisição custa $0.000083 nos preços atuais, e mil delas ficam assim:
| Modelo | Entrada $/1M | Saída $/1M | Por solicitação | 1.000 solicitações | OpenRouter, 1.000 solicitações |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000054 | $0.054 | $0.107 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000083 | $0.0825 | $0.165 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00017 | $0.165 | $1.17 |
1.500 tokens de entrada e 600 tokens de saída por solicitação. Os preços por 1M de tokens são atuais e mudam junto com nossas tarifas; a coluna OpenRouter mostra preços de referência para a mesma carga de trabalho.
A coluna do CheapTokens é no total, entrada e saída juntas, mais barata que a OpenRouter para todos os modelos da tabela. Se você quiser transformar usage em um orçamento contínuo, tracking agent token cost mostra a ideia em Python; a aritmética é a mesma em TypeScript.
streamText: imprima palavras conforme chegam#
Para uma UI de chat você quer que o texto apareça enquanto o modelo ainda está escrevendo. streamText retorna um iterável assíncrono de chunks de texto.
import { streamText } from 'ai';
import { cheaptokens } from './provider';

const result = streamText({
  model: cheaptokens('deepseek-ai/DeepSeek-V4-Flash-0731'),
  prompt: 'Write a 100-word product description for a pocket notebook.',
});

for await (const chunk of result.textStream) {
  process.stdout.write(chunk);
}

console.log('\n', await result.usage);
Observe que não há await na frente de streamText(...): ele retorna imediatamente e você consome o stream. usage é uma promise que se resolve quando o stream termina, então você a aguarda após o loop. Em um route handler do Next.js você retornaria o stream para o navegador em vez de escrever no stdout; a parte do provider é idêntica. Se você quiser a mesma coisa com o SDK da OpenAI puro, veja streaming chat responses in Node.js.
Respostas longas funcionam bem aqui: o DeepSeek-V4-Flash no CheapTokens pode escrever até 32.768 tokens em uma resposta, tem uma janela de contexto de 380K e um único preço a qualquer hora. A página do modelo está em /en/cheap-deepseek/, e os preços atuais estão na página de preços.
Troque o modelo sem tocar no resto#
Como apenas o id do modelo muda, testar outro modelo é uma edição de uma linha. O GLM-5.3-Flash tem uma janela de contexto de 390K e responde até 8.192 tokens; nos preços atuais custa $0.02 por 1M tokens de entrada e $0.04 por 1M tokens de saída.
Experimente você mesmoExperimente: qual linha você muda para rodar o mesmo script no GLM-5.3-Flash?Mostrar resposta
Apenas o id do modelo: cheaptokens('zai-. O provider, a chave, a baseURL e o resto do script permanecem os mesmos.
Um padrão útil é manter o id em uma variável de ambiente (process.) para que você possa comparar dois modelos no mesmo prompt sem um rebuild. A comparação DeepSeek vs GLM vs MiniMax ajuda a escolher quais valem a pena testar.
Se não funcionar#
A maioria das falhas é uma de três coisas: a chave, a URL ou o id do modelo.
- 401 significa que a chave está ausente ou errada. Verifique se
CHEAPTOKENS_está definida no shell que executa o script (um servidor Next.js precisa dela emAPI_ KEY .env.locale de um restart). - 404 geralmente significa que a baseURL perdeu seu
/v1ou que o id do modelo é o nome curto. Usehttps:/e o id completo./ api. cheaptokens. dev/ v1 - A resposta para no meio da frase. O modelo atingiu um limite de saída; a correção do finish_reason "length" explica isso.
O passo a passo mais longo dos dois primeiros está em API 401 ou 404: chave, base URL ou id de modelo errados.
Lista de verificação
Antes de executar o script
Para conectar outras ferramentas e fazer a primeira requisição manualmente, comece pela documentação do CheapTokens.


