API и SDKИнструкция
Vercel AI SDK с другим baseURL: CheapTokens в TypeScript
Подключите Vercel AI SDK к CheapTokens через createOpenAICompatible: рабочий код generateText и streamText, расход токенов и разбор частых ошибок.
Содержание
Чтобы запустить Vercel AI SDK на CheapTokens, поставьте @ai-, создайте провайдера с baseURL: 'https:/ и своим ключом и передайте provider('deepseek- в поле model. Остальной код — generateText, streamText, ваши промпты — остаётся как был.
Если у вас уже есть роут на Next.js или Node-скрипт, который говорит с моделью через AI SDK, менять нужно три вещи: base URL, ключ и id модели. Настройку мы сверили со страницей AI SDK про OpenAI-compatible провайдеры (29 октября 2026). Берём интерфейс Chat Completions в API CheapTokens — именно на нём работает этот провайдер.
Установка и создание провайдера#
Нужны два пакета: основной ai и провайдер для OpenAI-совместимых API.
npm install ai @ai-sdk/openai-compatible
export CHEAPTOKENS_API_KEY=ct_your_key_here
Порядок действий короткий:
Расставьте по порядку
Расставьте шаги настройки по порядку
Перетащите элементы или используйте стрелки
- Пополнить баланс и создать API-ключ
- Положить ключ в переменную окружения
- Создать провайдера с baseURL CheapTokens
- Передать полный id модели в generateText
Сам провайдер — один вызов createOpenAICompatible:
import { createOpenAICompatible } from '@ai-sdk/openai-compatible';

export const cheaptokens = createOpenAICompatible({
  name: 'cheaptokens',
  apiKey: process.env.CHEAPTOKENS_API_KEY,
  baseURL: 'https://api.cheaptokens.dev/v1',
  includeUsage: true,
});
name — просто подпись для ваших логов. includeUsage: true просит счётчики токенов и в потоковых ответах; без него по умолчанию ведёт себя как false. Вызов cheaptokens('model- даёт чат-модель; cheaptokens. и cheaptokens. делают то же самое.
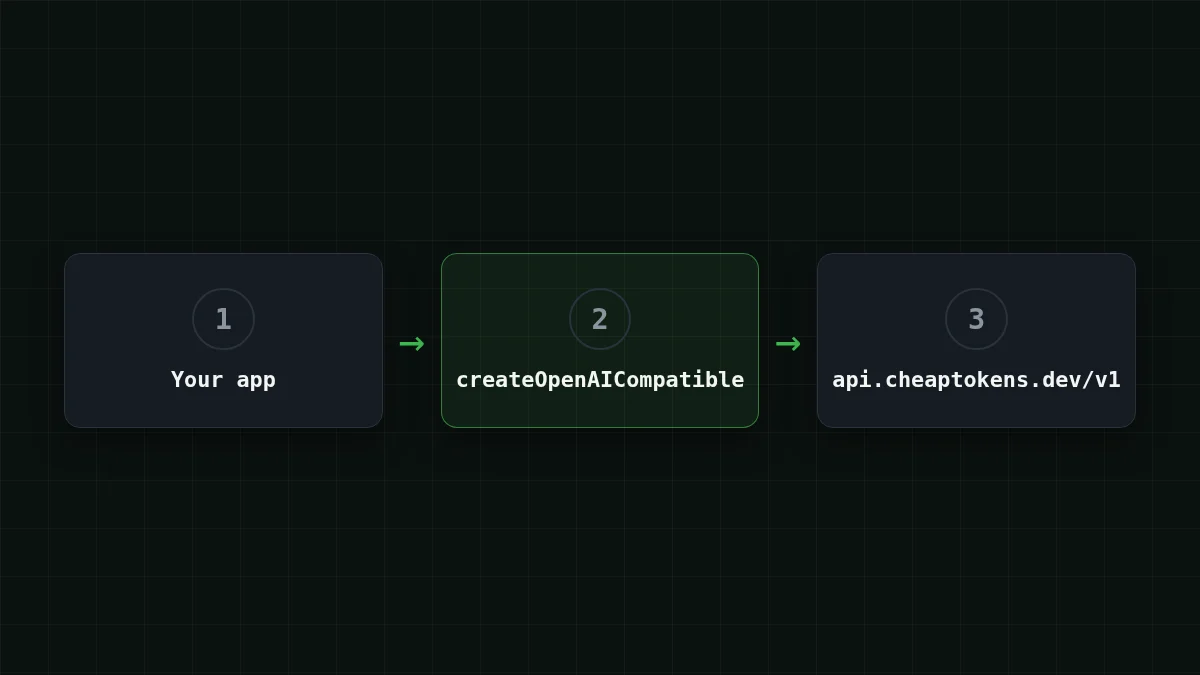
Id модели нужен полный: deepseek-. Короткое имя вроде deepseek- встречается в таблицах цен, а API его не примет. Если не уверены, что вписать, выведите список моделей через GET /v1/models и скопируйте id оттуда.
generateText: один ответ и его токены#
Вот полный скрипт. Он просит короткий ответ и печатает и текст, и объект usage.
import { generateText } from 'ai';
import { cheaptokens } from './provider';

const result = await generateText({
  model: cheaptokens('deepseek-ai/DeepSeek-V4-Flash-0731'),
  prompt: 'Explain in two sentences what a base URL is.',
});

console.log(result.text);
console.log(result.usage);
Запустите его командой npx tsx index.ts. Ответ придёт строкой в result.text, а в result.usage лежат счётчики входных и выходных токенов этого вызова. Объект мы печатаем целиком, чтобы вы увидели всё его содержимое. В справочнике AI SDK по streamText на 29 октября 2026 у usage поля inputTokens, outputTokens и totalTokens; перед выводом на дашборд сверьте типы установленной версии.
Зачем вообще читать usage? Потому что именно эти токены вы оплачиваете. Допустим, приложение отправляет промпт в 1 500 токенов и получает ответ в 600. По текущим ценам такой запрос стоит $0.000083, а тысяча таких запросов выглядит так:
| Модель | Вход $/1M | Выход $/1M | За запрос | 1 000 запросов | OpenRouter, 1 000 запросов |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000054 | $0.054 | $0.107 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000083 | $0.0825 | $0.165 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00017 | $0.165 | $1.17 |
1 500 входных и 600 выходных токенов на запрос. Цены за 1M токенов актуальны и меняются вместе с нашими тарифами; столбец OpenRouter показывает справочные цены для той же нагрузки.
Колонка CheapTokens — это итог, вход и выход вместе, и по каждой модели в таблице он дешевле OpenRouter. Если хочется превратить usage в бюджет, учёт стоимости токенов агента показывает идею на Python; арифметика в TypeScript та же.
streamText: слова по мере появления#
В чате текст должен появляться, пока модель ещё пишет. streamText отдаёт асинхронный итератор кусков текста.
import { streamText } from 'ai';
import { cheaptokens } from './provider';

const result = streamText({
  model: cheaptokens('deepseek-ai/DeepSeek-V4-Flash-0731'),
  prompt: 'Write a 100-word product description for a pocket notebook.',
});

for await (const chunk of result.textStream) {
  process.stdout.write(chunk);
}

console.log('\n', await result.usage);
Обратите внимание: перед streamText(...) нет await — функция возвращается сразу, а поток вы читаете сами. usage — это promise, он выполняется, когда поток закончился, поэтому его ждут после цикла. В роуте Next.js вы бы вернули поток в браузер вместо записи в stdout; часть с провайдером та же. Если нужен тот же приём на обычном OpenAI SDK, смотрите потоковые ответы в Node.js.
Длинные ответы тут не проблема: DeepSeek-V4-Flash в CheapTokens пишет до 32 768 токенов за один ответ, держит контекст 380K и стоит одинаково в любое время суток. Страница модели — /ru/models/, актуальные цены — на странице тарифов.
Другая модель без правок остального кода#
Меняется только id модели, поэтому попробовать другую — правка в одну строку. У GLM-5.3-Flash контекст 390K и ответ до 8 192 токенов; по текущим ценам это $0.02 за 1M входных токенов и $0.04 за 1M выходных.
Попробуйте самиПопробуйте сами: какую строку менять, чтобы запустить тот же скрипт на GLM-5.3-Flash?Показать ответ
Только id модели: cheaptokens('zai-. Провайдер, ключ, baseURL и остальной скрипт остаются прежними.
Удобно хранить id в переменной окружения (process.): тогда две модели можно сравнить на одном промпте без пересборки. Какие стоит пробовать, подскажет сравнение GLM, DeepSeek и MiniMax.
Если не работает#
Почти всегда виноваты ключ, адрес или id модели.
- 401 — ключ не передан или неверный. Проверьте, что
CHEAPTOKENS_задан в том же терминале, где запускаете скрипт (серверу Next.js нужна запись вAPI_ KEY .env.localи перезапуск). - 404 обычно значит, что в baseURL пропал
/v1или указано короткое имя модели. Нужныhttps:/и полный id./ api. cheaptokens. dev/ v1 - Ответ обрывается на полуслове. Модель упёрлась в лимит ответа; причину разбирает статья про finish_reason "length".
Подробнее про первые две ошибки — в статье API 401 или 404: ключ, base URL или id модели.
Чек-лист
Перед запуском скрипта
Чтобы подключить другие инструменты и отправить первый запрос вручную, начните с документации CheapTokens.


