API ও SDKগাইড
একটি কাস্টম বেস URL সহ Vercel AI SDK: TypeScript-এ CheapTokens
createOpenAICompatible দিয়ে Vercel AI SDK-কে CheapTokens-এ নির্দেশ করুন: একটি কার্যকর generateText এবং streamText স্নিপেট, টোকেন usage এবং সাধারণ ত্রুটির সমাধান।
এই পৃষ্ঠায়
Vercel AI SDK-কে CheapTokens-এ চালাতে @ai- ইনস্টল করুন, baseURL: 'https:/ এবং আপনার কী দিয়ে একটি প্রোভাইডার তৈরি করুন, এবং model হিসেবে provider('deepseek- পাস করুন। আপনার অ্যাপের বাকি সবকিছু, generateText, streamText, আপনার প্রম্পট, যেমন আছে তেমনই থাকে।
তাই যদি আপনার ইতিমধ্যে একটি Next.js রুট বা একটি Node স্ক্রিপ্ট থাকে যা AI SDK-এর মাধ্যমে একটি হোস্টেড মডেলের সাথে কথা বলে, আপনি তিনটি জিনিস পরিবর্তন করবেন: বেস URL, কী এবং মডেল আইডি। এই গাইডটি AI SDK-এর OpenAI-সামঞ্জস্যপূর্ণ প্রোভাইডার পৃষ্ঠা (২৯ অক্টোবর ২০২৬) এর বিপরীতে সেটআপ যাচাই করে। এটি CheapTokens API-এর Chat Completions ইন্টারফেস ব্যবহার করে, যা সেই প্রোভাইডার ব্যবহার করে।
ইনস্টল করুন এবং প্রোভাইডার তৈরি করুন#
দুটি প্যাকেজ: কোর ai প্যাকেজ এবং OpenAI-সামঞ্জস্যপূর্ণ প্রোভাইডার।
npm install ai @ai-sdk/openai-compatible
export CHEAPTOKENS_API_KEY=ct_your_key_here
কাজের ক্রম সংক্ষিপ্ত:
ক্রমে সাজান
সেটআপ সাজান
আইটেমগুলো ড্র্যাগ করুন বা তীর ব্যবহার করুন
- ব্যালেন্স টপ আপ করুন এবং একটি API কী তৈরি করুন
- কীটি একটি এনভায়রনমেন্ট ভেরিয়েবলে রাখুন
- CheapTokens baseURL দিয়ে প্রোভাইডার তৈরি করুন
- generateText-এ সম্পূর্ণ মডেল আইডি পাস করুন
প্রোভাইডার নিজেই createOpenAICompatible-এ একটি কল:
import { createOpenAICompatible } from '@ai-sdk/openai-compatible';

export const cheaptokens = createOpenAICompatible({
  name: 'cheaptokens',
  apiKey: process.env.CHEAPTOKENS_API_KEY,
  baseURL: 'https://api.cheaptokens.dev/v1',
  includeUsage: true,
});
name শুধু আপনার নিজের লগের জন্য একটি লেবেল। includeUsage: true স্ট্রিমিং রেসপন্সেও টোকেন গণনা চায়; এটি ছাড়া ডিফল্ট false-এর মতো আচরণ করে। cheaptokens('model- কল করলে আপনি একটি চ্যাট মডেল পান; cheaptokens. এবং cheaptokens. একই কাজ করে।
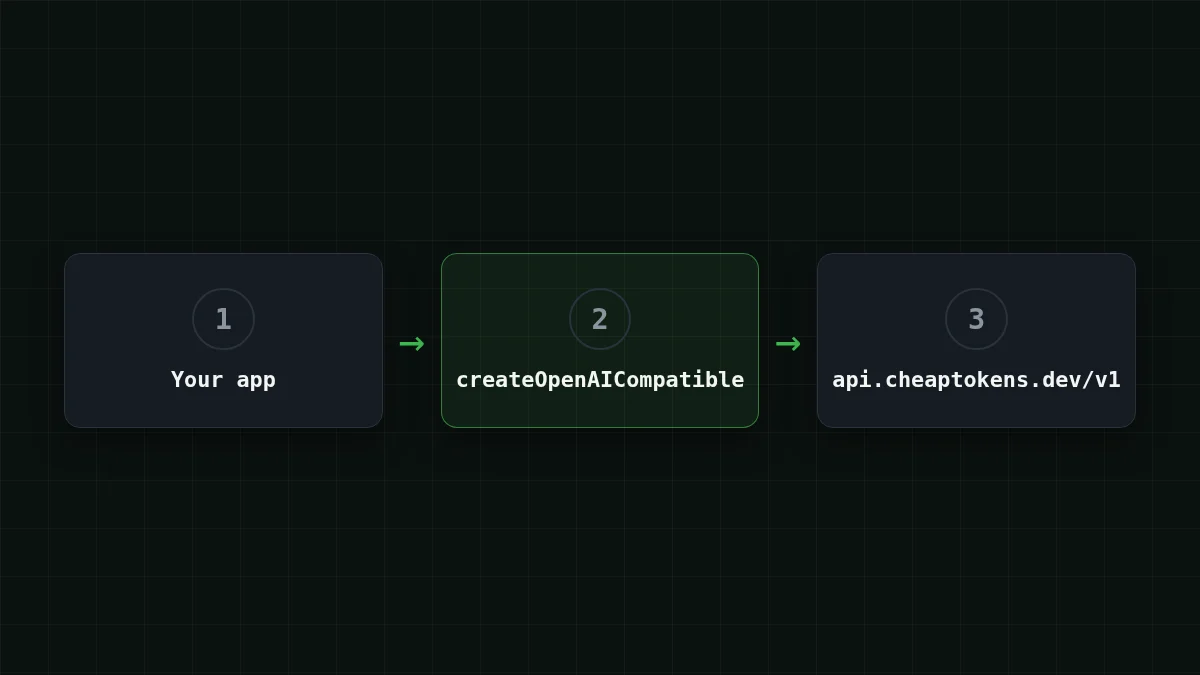
মডেল আইডি অবশ্যই সম্পূর্ণ হতে হবে: deepseek-। deepseek--এর মতো একটি সংক্ষিপ্ত নাম যা আপনি মূল্য সারণীতে দেখেন, এবং API এটি গ্রহণ করবে না। যদি আপনি নিশ্চিত না হন কী টাইপ করবেন, GET /v1/models দিয়ে মডেল তালিকা করুন এবং সেখান থেকে আইডি কপি করুন।
generateText: একটি উত্তর এবং তার টোকেন গণনা#
এখানে একটি সম্পূর্ণ স্ক্রিপ্ট। এটি একটি সংক্ষিপ্ত উত্তর চায় এবং টেক্সট এবং usage অবজেক্ট উভয়ই প্রিন্ট করে।
import { generateText } from 'ai';
import { cheaptokens } from './provider';

const result = await generateText({
  model: cheaptokens('deepseek-ai/DeepSeek-V4-Flash-0731'),
  prompt: 'Explain in two sentences what a base URL is.',
});

console.log(result.text);
console.log(result.usage);
npx tsx index.ts দিয়ে এটি চালান। আপনি result.text-এ একটি স্ট্রিং হিসেবে উত্তর পান, এবং result.usage সেই কলে ইনপুট এবং আউটপুট টোকেন গণনা ধারণ করে। আমরা পুরো অবজেক্ট প্রিন্ট করি যাতে আপনি এর সবকিছু দেখতে পান। streamText-এর জন্য AI SDK রেফারেন্সে (২৯ অক্টোবর ২০২৬ যাচাইকৃত) usage-এ inputTokens, outputTokens এবং totalTokens আছে; ড্যাশবোর্ডে সেগুলি সংযুক্ত করার আগে আপনার ইনস্টল করা সংস্করণের টাইপগুলি পরীক্ষা করুন।
কেন usage পড়তে বিরক্ত করবেন? কারণ এটিই সেই সংখ্যা যার জন্য আপনি অর্থ প্রদান করেন। ধরুন আপনার অ্যাপ একটি ১,৫০০-টোকেন প্রম্পট পাঠায় এবং একটি ৬০০-টোকেন উত্তর পায়। সেই অনুরোধের খরচ বর্তমান মূল্যে $0.000083, এবং এর এক হাজার এইরকম দেখায়:
| মডেল | ইনপুট $/১ মিলিয়ন | আউটপুট $/১ মিলিয়ন | প্রতি অনুরোধে | ১,০০০টি অনুরোধ | OpenRouter, ১,০০০টি অনুরোধ |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000054 | $0.054 | $0.107 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000083 | $0.0825 | $0.165 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00017 | $0.165 | $1.17 |
প্রতি অনুরোধে ১,৫০০ ইনপুট এবং ৬০০ আউটপুট টোকেন। প্রতি 1M টোকেনের দাম বর্তমান এবং আমাদের ট্যারিফের সাথে পরিবর্তিত হয়; OpenRouter কলামটি একই ওয়ার্কলোডের জন্য রেফারেন্স মূল্য দেখায়।
CheapTokens কলামটি মোট, ইনপুট এবং আউটপুট একসাথে, টেবিলের প্রতিটি মডেলের জন্য OpenRouter-এর চেয়ে সস্তা। আপনি যদি usage-কে একটি চলমান বাজেটে পরিণত করতে চান, এজেন্ট টোকেন খরচ ট্র্যাকিং ধারণাটি Python-এ দেখায়; TypeScript-এ গণিত একই।
streamText: শব্দ আসার সাথে সাথে প্রিন্ট করুন#
একটি চ্যাট UI-এর জন্য আপনি চান মডেল এখনও লেখার সময় টেক্সট দেখা যাক। streamText আপনাকে টেক্সট চাঙ্কের একটি অ্যাসিঙ্ক ইটারেবল দেয়।
import { streamText } from 'ai';
import { cheaptokens } from './provider';

const result = streamText({
  model: cheaptokens('deepseek-ai/DeepSeek-V4-Flash-0731'),
  prompt: 'Write a 100-word product description for a pocket notebook.',
});

for await (const chunk of result.textStream) {
  process.stdout.write(chunk);
}

console.log('\n', await result.usage);
লক্ষ্য করুন streamText(...)-এর সামনে await নেই: এটি সাথে সাথে ফিরে আসে এবং আপনি স্ট্রিমটি ব্যবহার করেন। usage একটি প্রমিস যা স্ট্রিম শেষ হলে সমাধান হয়, তাই আপনি লুপের পরে এটি await করেন। একটি Next.js রুট হ্যান্ডলারে আপনি stdout-এ লেখার পরিবর্তে ব্রাউজারে স্ট্রিমটি ফেরত দেবেন; প্রোভাইডার অংশ অভিন্ন। আপনি যদি সাধারণ OpenAI SDK দিয়ে একই জিনিস চান, Node.js-এ স্ট্রিমিং চ্যাট রেসপন্স দেখুন।
দীর্ঘ উত্তর এখানে ঠিক আছে: CheapTokens-এ DeepSeek-V4-Flash একটি উত্তরে ৩২,৭৬৮ টোকেন পর্যন্ত লিখতে পারে, ৩৮০K কনটেক্সট উইন্ডো আছে এবং যেকোনো সময়ে একই মূল্য। মডেল পৃষ্ঠাটি /en/cheap-deepseek/-এ, এবং বর্তমান মূল্য মূল্য পৃষ্ঠা-এ।
বাকি কিছু না ছুঁয়ে মডেল পরিবর্তন করুন#
যেহেতু শুধু মডেল আইডি পরিবর্তন হয়, অন্য একটি মডেল চেষ্টা করা এক লাইনের সম্পাদনা। GLM-5.3-Flash-এর ৩৯০K কনটেক্সট উইন্ডো আছে এবং ৮,১৯২ টোকেন পর্যন্ত উত্তর দেয়; বর্তমান মূল্যে এটি প্রতি ১M ইনপুট টোকেনে $0.02 এবং প্রতি ১M আউটপুট টোকেনে $0.04 খরচ করে।
নিজে চেষ্টা করুনচেষ্টা করুন: GLM-5.3-Flash-এ একই স্ক্রিপ্ট চালাতে কোন লাইনটি পরিবর্তন করবেন?উত্তর দেখান
শুধু মডেল আইডি: cheaptokens('zai-। প্রোভাইডার, কী, baseURL এবং স্ক্রিপ্টের বাকি অংশ একই থাকে।
একটি সুবিধাজনক প্যাটার্ন হল আইডিটি একটি এনভায়রনমেন্ট ভেরিয়েবলে রাখা (process.) যাতে আপনি পুনর্নির্মাণ ছাড়াই একই প্রম্পটে দুটি মডেল তুলনা করতে পারেন। DeepSeek vs GLM vs MiniMax তুলনা কোনগুলি চেষ্টা করার যোগ্য তা বেছে নিতে সাহায্য করে।
যদি এটি কাজ না করে#
বেশিরভাগ ব্যর্থতা তিনটির একটি: কী, URL বা মডেল আইডি।
- 401 মানে কী অনুপস্থিত বা ভুল। পরীক্ষা করুন যে
CHEAPTOKENS_স্ক্রিপ্ট চালানো শেলে সেট করা আছে (একটি Next.js সার্ভারের জন্য এটিAPI_ KEY .env.local-এ এবং একটি পুনরায় চালু প্রয়োজন)। - 404 সাধারণত মানে baseURL তার
/v1হারিয়েছে বা মডেল আইডি সংক্ষিপ্ত নাম।https:/এবং সম্পূর্ণ আইডি ব্যবহার করুন।/ api. cheaptokens. dev/ v1 - উত্তর মাঝপথে থেমে যায়। মডেল একটি আউটপুট সীমায় পৌঁছেছে; finish_reason "length" সমাধান এটি ব্যাখ্যা করে।
প্রথম দুটির দীর্ঘতর ওয়াকথ্রু API 401 বা 404: ভুল কী, বেস URL বা মডেল আইডি-এ আছে।
চেকলিস্ট
স্ক্রিপ্ট চালানোর আগে
অন্যান্য টুল সংযুক্ত করা এবং হাতে প্রথম অনুরোধের জন্য, CheapTokens ডক্স থেকে শুরু করুন।


