API และ SDKคู่มือ
Vercel AI SDK กับ base URL แบบกำหนดเอง: CheapTokens ใน TypeScript
ชี้ Vercel AI SDK ไปที่ CheapTokens ด้วย createOpenAICompatible: ตัวอย่าง generateText และ streamText ที่ใช้งานได้, การใช้โทเค็น และวิธีแก้ข้อผิดพลาดทั่วไป
ในหน้านี้
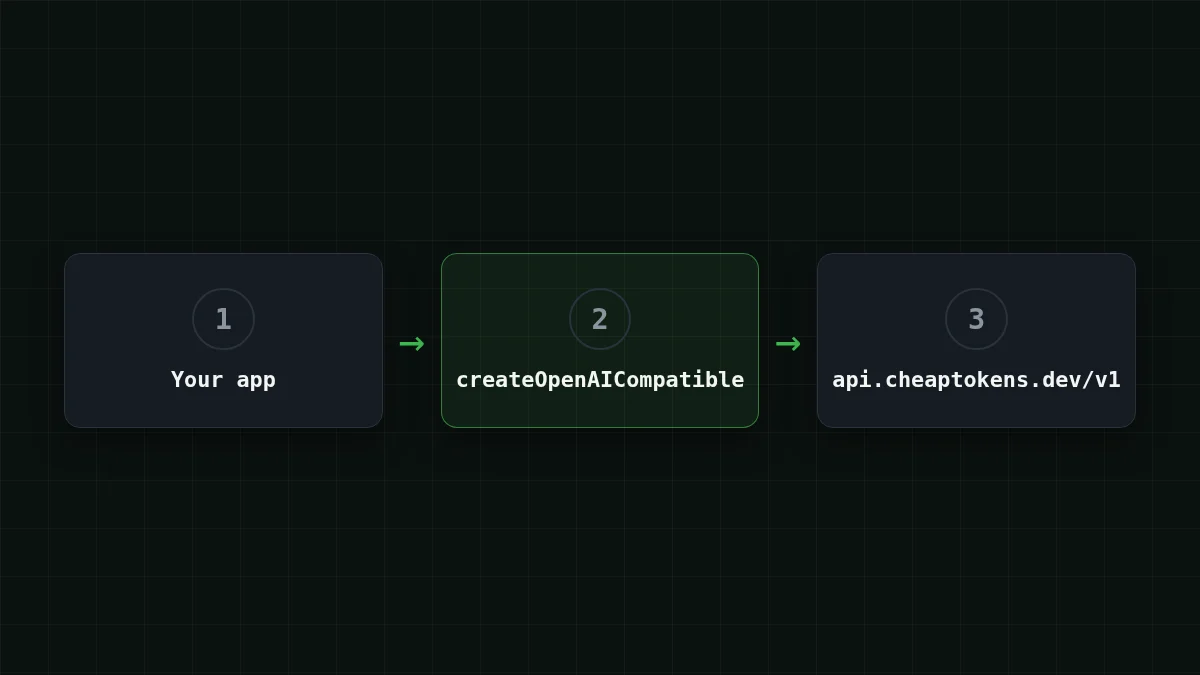
ในการรัน Vercel AI SDK บน CheapTokens ให้ติดตั้ง @ai- สร้าง provider ด้วย baseURL: 'https:/ และคีย์ของคุณ แล้วส่ง provider('deepseek- เป็น model ส่วนอื่น ๆ ในแอปของคุณ ทั้ง generateText, streamText และพรอมป์ของคุณ ยังคงเหมือนเดิม
ดังนั้นหากคุณมี Next.js route หรือสคริปต์ Node ที่คุยกับโมเดลแบบ hosted ผ่าน AI SDK อยู่แล้ว คุณต้องเปลี่ยนสามอย่าง: base URL, คีย์ และ model id คู่มือนี้ตรวจสอบการตั้งค่ากับ หน้าผู้ให้บริการที่รองรับ OpenAI ของ AI SDK (29 ตุลาคม 2026) โดยใช้ส่วนติดต่อ Chat Completions ของ CheapTokens API ซึ่งเป็นสิ่งที่ provider นั้นใช้สื่อสาร
ติดตั้งและสร้าง provider#
สองแพ็กเกจ: แพ็กเกจหลัก ai และ provider ที่รองรับ OpenAI
npm install ai @ai-sdk/openai-compatible
export CHEAPTOKENS_API_KEY=ct_your_key_here
ลำดับงานสั้น ๆ:
เรียงลำดับ
จัดลำดับการตั้งค่า
ลากรายการหรือใช้ลูกศร
- เติมยอดคงเหลือและสร้าง API key
- ใส่คีย์ใน environment variable
- สร้าง provider ด้วย baseURL ของ CheapTokens
- ส่ง model id แบบเต็มให้ generateText
ตัว provider เองคือการเรียก createOpenAICompatible หนึ่งครั้ง:
import { createOpenAICompatible } from '@ai-sdk/openai-compatible';

export const cheaptokens = createOpenAICompatible({
  name: 'cheaptokens',
  apiKey: process.env.CHEAPTOKENS_API_KEY,
  baseURL: 'https://api.cheaptokens.dev/v1',
  includeUsage: true,
});
name เป็นเพียงป้ายกำกับสำหรับ log ของคุณเอง includeUsage: true ขอจำนวนโทเค็นใน streaming response ด้วย; หากไม่มี ค่าเริ่มต้นจะทำงานเหมือน false การเรียก cheaptokens('model- จะได้ chat model; cheaptokens. และ cheaptokens. ทำสิ่งเดียวกัน
model id ต้องเป็นแบบเต็ม: deepseek- ชื่อสั้นอย่าง deepseek- คือสิ่งที่คุณเห็นในตารางราคา และ API จะไม่ยอมรับ หากคุณไม่แน่ใจว่าจะพิมพ์อะไร ให้ แสดงรายการโมเดลด้วย GET /v1/models แล้วคัดลอก id จากที่นั่น
generateText: คำตอบเดียวและจำนวนโทเค็น#
นี่คือสคริปต์ที่สมบูรณ์ มันขอคำตอบสั้น ๆ และพิมพ์ทั้งข้อความและออบเจกต์ usage
import { generateText } from 'ai';
import { cheaptokens } from './provider';

const result = await generateText({
  model: cheaptokens('deepseek-ai/DeepSeek-V4-Flash-0731'),
  prompt: 'Explain in two sentences what a base URL is.',
});

console.log(result.text);
console.log(result.usage);
รันด้วย npx tsx index.ts คุณจะได้คำตอบเป็นสตริงใน result.text และ result.usage เก็บจำนวนโทเค็นอินพุตและเอาต์พุตสำหรับการเรียกนั้น เราพิมพ์ออบเจกต์ทั้งหมดเพื่อให้คุณเห็นทุกอย่างในนั้น ใน เอกสารอ้างอิง AI SDK สำหรับ streamText (ตรวจสอบเมื่อ 29 ตุลาคม 2026) usage มี inputTokens, outputTokens และ totalTokens; ตรวจสอบชนิดข้อมูลของเวอร์ชันที่คุณติดตั้งก่อนนำไปต่อกับแดชบอร์ด
ทำไมต้องอ่าน usage เลย? เพราะนั่นคือตัวเลขที่คุณจ่าย สมมติว่าแอปของคุณส่งพรอมป์ 1,500 โทเค็นและได้คำตอบ 600 โทเค็น คำขอนั้นมีค่าใช้จ่าย $0.000083 ตามราคาปัจจุบัน และหนึ่งพันคำขอมีลักษณะเช่นนี้:
| โมเดล | Input $/1M | Output $/1M | ต่อคำขอ | 1,000 คำขอ | OpenRouter, 1,000 คำขอ |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000054 | $0.054 | $0.107 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000083 | $0.0825 | $0.165 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00017 | $0.165 | $1.17 |
1,500 โทเค็นอินพุตและ 600 โทเค็นเอาต์พุตต่อคำขอ ราคาต่อ 1M โทเค็นเป็นราคาปัจจุบันและเปลี่ยนแปลงไปพร้อมกับอัตราค่าบริการของเรา คอลัมน์ OpenRouter แสดงราคาอ้างอิงสำหรับปริมาณงานเดียวกัน
คอลัมน์ CheapTokens เป็นยอดรวม ทั้งอินพุตและเอาต์พุต รวมกัน ถูกกว่า OpenRouter สำหรับทุกโมเดลในตาราง หากคุณต้องการเปลี่ยน usage เป็นงบประมาณที่หมุนเวียน การติดตามต้นทุนโทเค็นของเอเจนต์ แสดงแนวคิดใน Python; การคำนวณเหมือนกันใน TypeScript
streamText: พิมพ์คำขณะที่มาถึง#
สำหรับ UI แชท คุณต้องการให้ข้อความปรากฏขณะที่โมเดลยังเขียนอยู่ streamText ให้ async iterable ของชิ้นข้อความ
import { streamText } from 'ai';
import { cheaptokens } from './provider';

const result = streamText({
  model: cheaptokens('deepseek-ai/DeepSeek-V4-Flash-0731'),
  prompt: 'Write a 100-word product description for a pocket notebook.',
});

for await (const chunk of result.textStream) {
  process.stdout.write(chunk);
}

console.log('\n', await result.usage);
สังเกตว่าไม่มี await นำหน้า streamText(...): มันคืนค่าทันทีและคุณบริโภคสตรีม usage เป็น promise ที่จะ settle เมื่อสตรีมสิ้นสุด ดังนั้นคุณ await หลังจากลูป ใน route handler ของ Next.js คุณจะส่งสตรีมกลับไปยังเบราว์เซอร์แทนการเขียนไปยัง stdout; ส่วน provider เหมือนกันทุกประการ หากคุณต้องการสิ่งเดียวกันด้วย OpenAI SDK ธรรมดา ดู การสตรีมคำตอบแชทใน Node.js
คำตอบยาว ๆ ก็ใช้ได้ที่นี่: DeepSeek-V4-Flash บน CheapTokens เขียนได้สูงสุด 32,768 โทเค็นในคำตอบเดียว มีหน้าต่างบริบท 380K และราคาเดียวทุกชั่วโมง หน้าโมเดลอยู่ที่ /en/cheap-deepseek/ และราคาปัจจุบันอยู่บน หน้าราคา
สลับโมเดลโดยไม่แตะส่วนที่เหลือ#
เนื่องจากมีเพียง model id ที่เปลี่ยน การลองโมเดลอื่นจึงเป็นการแก้ไขหนึ่งบรรทัด GLM-5.3-Flash มีหน้าต่างบริบท 390K และตอบได้สูงสุด 8,192 โทเค็น; ตามราคาปัจจุบันมีค่าใช้จ่าย $0.02 ต่อ 1M โทเค็นอินพุต และ $0.04 ต่อ 1M โทเค็นเอาต์พุต
ลองด้วยตัวเองลองดู: คุณเปลี่ยนบรรทัดใดเพื่อรันสคริปต์เดียวกันบน GLM-5.3-Flash?แสดงคำตอบ
เฉพาะ model id: cheaptokens('zai- provider, คีย์, baseURL และส่วนที่เหลือของสคริปต์ยังคงเหมือนเดิม
รูปแบบที่มีประโยชน์คือเก็บ id ไว้ใน environment variable (process.) เพื่อให้คุณเปรียบเทียบสองโมเดลบนพรอมป์เดียวกันได้โดยไม่ต้อง rebuild การเปรียบเทียบ DeepSeek vs GLM vs MiniMax ช่วยเลือกว่าตัวไหนน่าลอง
หากใช้งานไม่ได้#
ความล้มเหลวส่วนใหญ่เป็นหนึ่งในสามอย่าง: คีย์, URL หรือ model id
- 401 หมายถึงคีย์หายหรือผิด ตรวจสอบว่า
CHEAPTOKENS_ถูกตั้งค่าในเชลล์ที่รันสคริปต์ (เซิร์ฟเวอร์ Next.js ต้องการในAPI_ KEY .env.localและรีสตาร์ท) - 404 มักหมายถึง baseURL สูญเสีย
/v1หรือ model id เป็นชื่อสั้น ใช้https:/และ id แบบเต็ม/ api. cheaptokens. dev/ v1 - คำตอบหยุดกลางประโยค โมเดลชนขีดจำกัดเอาต์พุต; วิธีแก้ finish_reason "length" อธิบายไว้
คำอธิบายที่ยาวกว่าของสองข้อแรกอยู่ใน API 401 หรือ 404: คีย์, base URL หรือ model id ผิด
เช็กลิสต์
ก่อนรันสคริปต์
สำหรับการเชื่อมต่อเครื่องมืออื่นและการส่งคำขอแรกด้วยมือ เริ่มจาก เอกสาร CheapTokens


