API & SDKPanduan
Vercel AI SDK dengan base URL kustom: CheapTokens di TypeScript
Arahkan Vercel AI SDK ke CheapTokens dengan createOpenAICompatible: cuplikan generateText dan streamText yang berfungsi, penggunaan token, dan perbaikan untuk error umum.
Di halaman ini
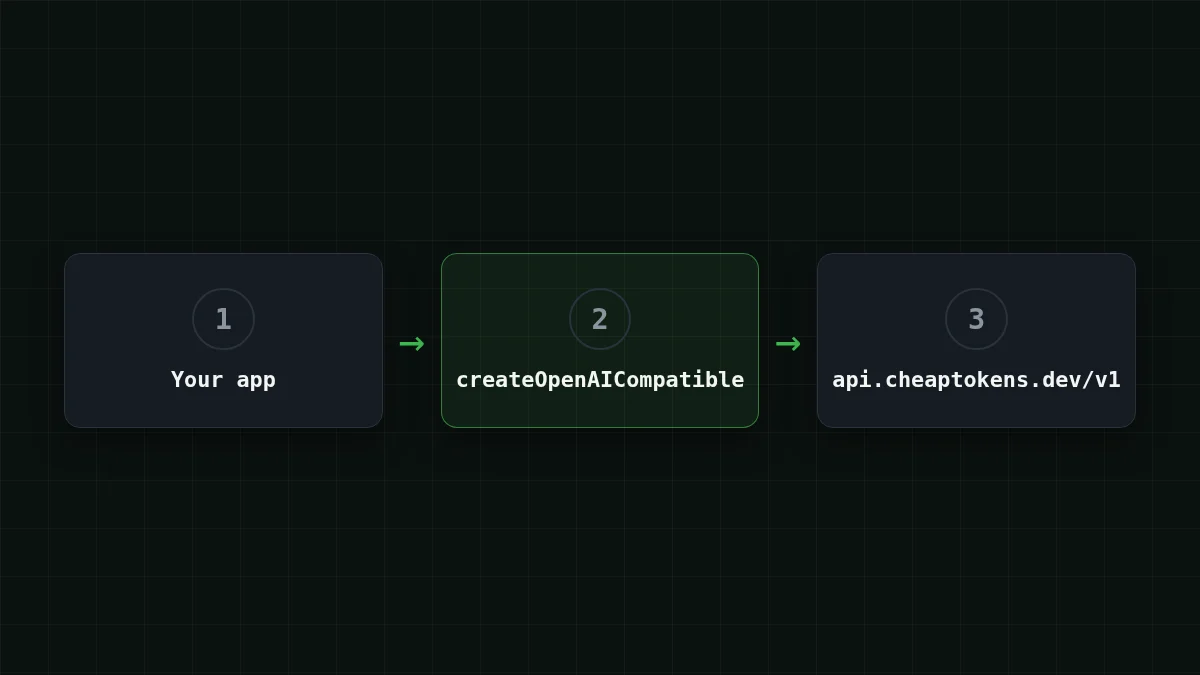
Untuk menjalankan Vercel AI SDK di CheapTokens, pasang @ai-, buat provider dengan baseURL: 'https:/ dan kunci Anda, lalu berikan provider('deepseek- sebagai model. Semua hal lain di aplikasi Anda, generateText, streamText, prompt Anda, tetap seperti semula.
Jadi jika Anda sudah memiliki route Next.js atau skrip Node yang berkomunikasi dengan model terhosting melalui AI SDK, Anda mengubah tiga hal: base URL, kunci, dan id model. Panduan ini memeriksa penyiapan terhadap halaman provider yang kompatibel dengan OpenAI milik AI SDK (29 Oktober 2026). Panduan ini menggunakan antarmuka Chat Completions dari API CheapTokens, yang merupakan antarmuka yang digunakan provider tersebut.
Pasang dan buat provider#
Dua paket: paket inti ai dan provider yang kompatibel dengan OpenAI.
npm install ai @ai-sdk/openai-compatible
export CHEAPTOKENS_API_KEY=ct_your_key_here
Urutan pengerjaannya singkat:
Urutkan
Susun penyiapan
Seret item atau gunakan panah
- Isi ulang saldo dan buat kunci API
- Letakkan kunci di variabel lingkungan
- Buat provider dengan baseURL CheapTokens
- Berikan id model lengkap ke generateText
Provider itu sendiri adalah satu panggilan ke createOpenAICompatible:
import { createOpenAICompatible } from '@ai-sdk/openai-compatible';

export const cheaptokens = createOpenAICompatible({
  name: 'cheaptokens',
  apiKey: process.env.CHEAPTOKENS_API_KEY,
  baseURL: 'https://api.cheaptokens.dev/v1',
  includeUsage: true,
});
name hanyalah label untuk log Anda sendiri. includeUsage: true meminta jumlah token juga dalam respons streaming; tanpanya, perilaku default sama seperti false. Memanggil cheaptokens('model- memberi Anda model chat; cheaptokens. dan cheaptokens. melakukan hal yang sama.
Id model harus yang lengkap: deepseek-. Nama pendek seperti deepseek- adalah yang Anda lihat di tabel harga, dan API tidak akan menerimanya. Jika Anda tidak yakin apa yang harus diketik, daftar model dengan GET /v1/models dan salin id dari sana.
generateText: satu jawaban dan jumlah tokennya#
Berikut skrip lengkap. Skrip ini meminta jawaban singkat dan mencetak teks serta objek usage.
import { generateText } from 'ai';
import { cheaptokens } from './provider';

const result = await generateText({
  model: cheaptokens('deepseek-ai/DeepSeek-V4-Flash-0731'),
  prompt: 'Explain in two sentences what a base URL is.',
});

console.log(result.text);
console.log(result.usage);
Jalankan dengan npx tsx index.ts. Anda mendapatkan jawaban sebagai string di result.text, dan result.usage menyimpan jumlah token input dan output untuk panggilan tersebut. Kami mencetak seluruh objek agar Anda melihat semua isinya. Dalam referensi AI SDK untuk streamText (diperiksa 29 Oktober 2026) usage memiliki inputTokens, outputTokens dan totalTokens; periksa tipe versi yang Anda pasang sebelum menghubungkannya ke dasbor.
Mengapa repot membaca usage? Karena itulah angka yang Anda bayar. Katakanlah aplikasi Anda mengirim prompt 1.500 token dan mendapat jawaban 600 token. Permintaan itu berbiaya $0.000083 pada harga saat ini, dan seribu permintaan seperti ini tampak seperti berikut:
| Model | Input $/1Jt | Output $/1Jt | Per permintaan | 1.000 permintaan | OpenRouter, 1.000 permintaan |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000054 | $0.054 | $0.107 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000083 | $0.0825 | $0.165 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00017 | $0.165 | $1.17 |
1.500 token input dan 600 token output per permintaan. Harga per 1 juta token adalah harga saat ini dan berubah seiring tarif kami; kolom OpenRouter menunjukkan harga referensi untuk beban kerja yang sama.
Kolom CheapTokens adalah total, input dan output digabung, lebih murah daripada OpenRouter untuk setiap model di tabel. Jika Anda ingin mengubah usage menjadi anggaran berjalan, pelacakan biaya token agen menunjukkan idenya dalam Python; aritmetikanya sama di TypeScript.
streamText: cetak kata saat tiba#
Untuk UI chat Anda ingin teks muncul saat model masih menulis. streamText memberi Anda iterable asinkron berisi potongan teks.
import { streamText } from 'ai';
import { cheaptokens } from './provider';

const result = streamText({
  model: cheaptokens('deepseek-ai/DeepSeek-V4-Flash-0731'),
  prompt: 'Write a 100-word product description for a pocket notebook.',
});

for await (const chunk of result.textStream) {
  process.stdout.write(chunk);
}

console.log('\n', await result.usage);
Perhatikan tidak ada await di depan streamText(...): fungsi ini langsung kembali dan Anda mengonsumsi stream. usage adalah promise yang selesai saat stream berakhir, jadi Anda await setelah loop. Di route handler Next.js Anda akan mengembalikan stream ke browser alih-alih menulis ke stdout; bagian provider identik. Jika Anda ingin hal yang sama dengan SDK OpenAI biasa, lihat respons chat streaming di Node.js.
Jawaban panjang tidak masalah di sini: DeepSeek-V4-Flash di CheapTokens dapat menulis hingga 32.768 token dalam satu jawaban, memiliki jendela konteks 380K dan satu harga di jam berapa pun. Halaman model ada di /en/cheap-deepseek/, dan harga saat ini ada di halaman harga.
Ganti model tanpa menyentuh sisanya#
Karena hanya id model yang berubah, mencoba model lain adalah edit satu baris. GLM-5.3-Flash memiliki jendela konteks 390K dan menjawab hingga 8.192 token; pada harga saat ini biayanya $0.02 per 1M token input dan $0.04 per 1M token output.
Coba sendiriCoba: baris mana yang Anda ubah untuk menjalankan skrip yang sama pada GLM-5.3-Flash?Tampilkan jawaban
Hanya id model: cheaptokens('zai-. Provider, kunci, baseURL dan sisa skrip tetap sama.
Pola yang praktis adalah menyimpan id di variabel lingkungan (process.) agar Anda dapat membandingkan dua model pada prompt yang sama tanpa rebuild. Perbandingan DeepSeek vs GLM vs MiniMax membantu memilih mana yang layak dicoba.
Jika tidak berhasil#
Sebagian besar kegagalan adalah salah satu dari tiga hal: kunci, URL, atau id model.
- 401 berarti kunci hilang atau salah. Periksa bahwa
CHEAPTOKENS_diatur di shell yang menjalankan skrip (server Next.js membutuhkannya diAPI_ KEY .env.localdan restart). - 404 biasanya berarti baseURL kehilangan
/v1atau id model adalah nama pendek. Gunakanhttps:/dan id lengkap./ api. cheaptokens. dev/ v1 - Jawaban berhenti di tengah kalimat. Model mencapai batas output; perbaikan finish_reason "length" menjelaskannya.
Penjelasan lebih panjang untuk dua hal pertama ada di API 401 atau 404: kunci, base URL, atau id model yang salah.
Daftar periksa
Sebelum Anda menjalankan skrip
Untuk menghubungkan alat lain dan permintaan pertama secara manual, mulai dari dokumentasi CheapTokens.


