API i SDKPrzewodnik
Vercel AI SDK z własnym bazowym URL: CheapTokens w TypeScript
Skieruj Vercel AI SDK na CheapTokens przez createOpenAICompatible: działający fragment generateText i streamText, użycie tokenów i poprawki typowych błędów.
Na tej stronie
Aby uruchomić Vercel AI SDK na CheapTokens, zainstaluj @ai-, utwórz provider z baseURL: 'https:/ i swoim kluczem, a następnie przekaż provider('deepseek- jako model. Wszystko inne w Twojej aplikacji, generateText, streamText, Twoje prompty, pozostaje bez zmian.
Jeśli masz już trasę Next.js lub skrypt Node, który komunikuje się z hostowanym modelem przez AI SDK, zmieniasz trzy rzeczy: bazowy URL, klucz i identyfikator modelu. Ten przewodnik weryfikuje konfigurację względem strony providerów zgodnych z OpenAI w AI SDK (29 października 2026). Korzysta z interfejsu Chat Completions API CheapTokens, którym posługuje się ten provider.
Instalacja i utworzenie providera#
Dwa pakiety: podstawowy pakiet ai i provider zgodny z OpenAI.
npm install ai @ai-sdk/openai-compatible
export CHEAPTOKENS_API_KEY=ct_your_key_here
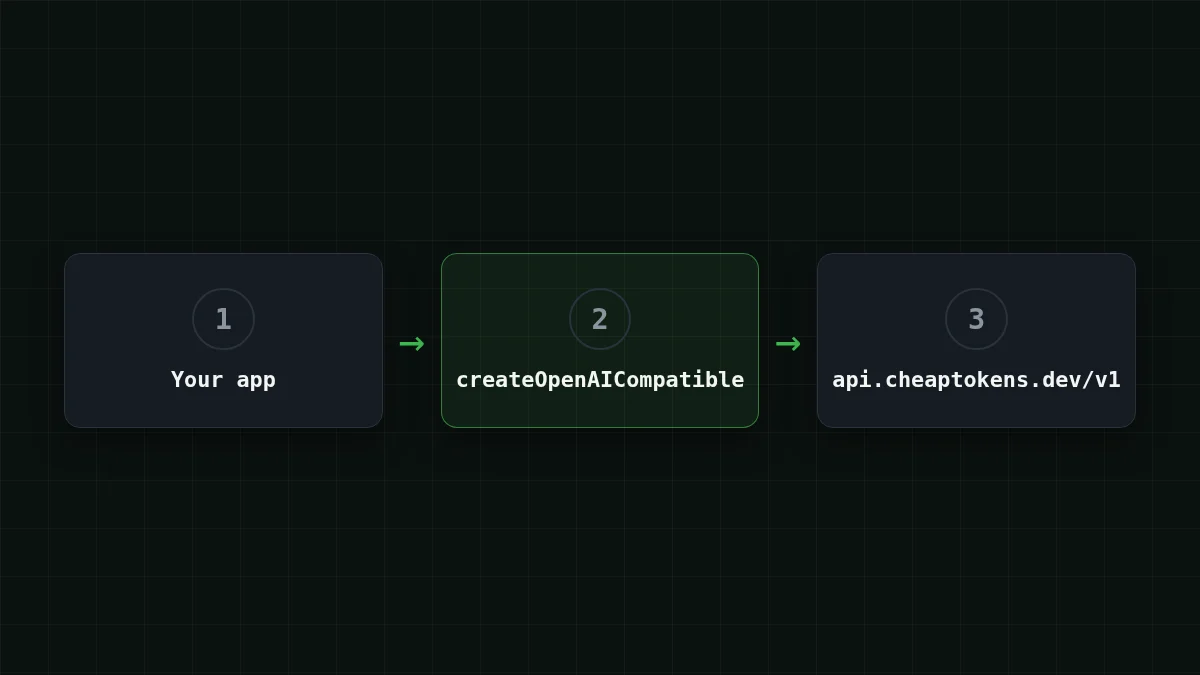
Kolejność pracy jest krótka:
Ustaw w kolejności
Uporządkuj konfigurację
Przeciągnij elementy lub użyj strzałek
- Zasil saldo i utwórz klucz API
- Umieść klucz w zmiennej środowiskowej
- Utwórz provider z baseURL CheapTokens
- Przekaż pełny identyfikator modelu do generateText
Sam provider to jedno wywołanie createOpenAICompatible:
import { createOpenAICompatible } from '@ai-sdk/openai-compatible';

export const cheaptokens = createOpenAICompatible({
  name: 'cheaptokens',
  apiKey: process.env.CHEAPTOKENS_API_KEY,
  baseURL: 'https://api.cheaptokens.dev/v1',
  includeUsage: true,
});
name to tylko etykieta dla Twoich własnych logów. includeUsage: true prosi o liczniki tokenów także w odpowiedziach strumieniowych; bez tego domyślne zachowanie działa jak false. Wywołanie cheaptokens('model- daje model czatu; cheaptokens. i cheaptokens. robią to samo.
Identyfikator modelu musi być pełny: deepseek-. Krótka nazwa jak deepseek- to ta, którą widzisz w tabelach cen, i API jej nie zaakceptuje. Jeśli nie jesteś pewien, co wpisać, wylistuj modele przez GET /v1/models i skopiuj stamtąd identyfikator.
generateText: jedna odpowiedź i jej liczba tokenów#
Oto kompletny skrypt. Prosi o krótką odpowiedź i wypisuje zarówno tekst, jak i obiekt usage.
import { generateText } from 'ai';
import { cheaptokens } from './provider';

const result = await generateText({
  model: cheaptokens('deepseek-ai/DeepSeek-V4-Flash-0731'),
  prompt: 'Explain in two sentences what a base URL is.',
});

console.log(result.text);
console.log(result.usage);
Uruchom go przez npx tsx index.ts. Odpowiedź otrzymujesz jako ciąg znaków w result.text, a result.usage zawiera liczbę tokenów wejściowych i wyjściowych dla tego wywołania. Wypisujemy cały obiekt, żebyś zobaczył wszystko, co w nim jest. W dokumentacji AI SDK dla streamText (sprawdzonej 29 października 2026) usage ma inputTokens, outputTokens i totalTokens; sprawdź typy w zainstalowanej wersji, zanim podłączysz je do dashboardu.
Po co w ogóle czytać usage? Bo to jest liczba, za którą płacisz. Załóżmy, że Twoja aplikacja wysyła prompt o 1 500 tokenach i dostaje odpowiedź o 600 tokenach. To żądanie kosztuje $0.000083 przy obecnych cenach, a tysiąc takich wygląda tak:
| Model | Wejście $/1M | Wyjście $/1M | Za żądanie | 1000 żądań | OpenRouter, 1000 żądań |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000054 | $0.054 | $0.107 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000083 | $0.0825 | $0.165 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00017 | $0.165 | $1.17 |
1500 tokenów wejściowych i 600 tokenów wyjściowych na żądanie. Ceny za 1 mln tokenów są aktualne i zmieniają się wraz z naszymi taryfami; kolumna OpenRouter pokazuje ceny referencyjne dla tego samego obciążenia.
Kolumna CheapTokens to suma, wejście i wyjście razem, taniej niż OpenRouter dla każdego modelu w tabeli. Jeśli chcesz zamienić usage w bieżący budżet, śledzenie kosztu tokenów agenta pokazuje ten pomysł w Pythonie; arytmetyka jest taka sama w TypeScript.
streamText: wypisuj słowa, gdy nadchodzą#
W interfejsie czatu chcesz, aby tekst pojawiał się, gdy model jeszcze pisze. streamText daje Ci asynchroniczny iterowalny strumień fragmentów tekstu.
import { streamText } from 'ai';
import { cheaptokens } from './provider';

const result = streamText({
  model: cheaptokens('deepseek-ai/DeepSeek-V4-Flash-0731'),
  prompt: 'Write a 100-word product description for a pocket notebook.',
});

for await (const chunk of result.textStream) {
  process.stdout.write(chunk);
}

console.log('\n', await result.usage);
Zauważ, że przed streamText(...) nie ma await: zwraca wynik od razu, a Ty konsumujesz strumień. usage to promise, który rozwiązuje się po zakończeniu strumienia, więc awaitujesz go po pętli. W handlerze trasy Next.js zwróciłbyś strumień do przeglądarki zamiast pisać do stdout; część związana z providerem jest identyczna. Jeśli chcesz tego samego z czystym OpenAI SDK, zobacz strumieniowanie odpowiedzi czatu w Node.js.
Długie odpowiedzi są tu w porządku: DeepSeek-V4-Flash na CheapTokens może napisać do 32 768 tokenów w jednej odpowiedzi, ma okno kontekstu 380K i jedną cenę o każdej porze. Strona modelu jest pod /en/cheap-deepseek/, a aktualne ceny na stronie cennika.
Zmień model bez ruszania reszty#
Ponieważ zmienia się tylko identyfikator modelu, wypróbowanie innego modelu to edycja jednej linii. GLM-5.3-Flash ma okno kontekstu 390K i odpowiada do 8 192 tokenów; przy obecnych cenach kosztuje $0.02 za 1M tokenów wejściowych i $0.04 za 1M tokenów wyjściowych.
Spróbuj samSpróbuj: którą linię zmieniasz, aby uruchomić ten sam skrypt na GLM-5.3-Flash?Pokaż odpowiedź
Tylko identyfikator modelu: cheaptokens('zai-. Provider, klucz, baseURL i reszta skryptu pozostają bez zmian.
Przydatny wzorzec to trzymanie identyfikatora w zmiennej środowiskowej (process.), dzięki czemu możesz porównać dwa modele na tym samym promptcie bez przebudowy. Porównanie DeepSeek vs GLM vs MiniMax pomaga wybrać, które warto wypróbować.
Jeśli nie działa#
Większość błędów to jedna z trzech rzeczy: klucz, URL lub identyfikator modelu.
- 401 oznacza, że klucz jest brakujący lub błędny. Sprawdź, czy
CHEAPTOKENS_jest ustawiony w powłoce, która uruchamia skrypt (serwer Next.js potrzebuje go wAPI_ KEY .env.locali restartu). - 404 zwykle oznacza, że baseURL zgubił
/v1lub identyfikator modelu to krótka nazwa. Użyjhttps:/i pełnego identyfikatora./ api. cheaptokens. dev/ v1 - Odpowiedź urywa się w połowie zdania. Model osiągnął limit wyjścia; poprawka finish_reason "length" to wyjaśnia.
Dłuższy opis dwóch pierwszych przypadków jest w API 401 lub 404: zły klucz, bazowy URL lub identyfikator modelu.
Lista kontrolna
Zanim uruchomisz skrypt
Aby podłączyć inne narzędzia i wykonać pierwsze żądanie ręcznie, zacznij od dokumentacji CheapTokens.


