APIとSDKガイド
カスタムベース URL で Vercel AI SDK を使用する:TypeScript で CheapTokens
createOpenAICompatible で Vercel AI SDK を CheapTokens に向けます:動作する generateText と streamText のスニペット、トークン使用量、一般的なエラーの修正。
Vercel AI SDK を CheapTokens で実行するには、@ai- をインストールし、baseURL: 'https:/ とあなたのキーでプロバイダーを作成し、provider('deepseek- を model として渡します。アプリ内の他のすべて、generateText、streamText、プロンプトはそのままです。
つまり、AI SDK 経由でホストされたモデルと通信する Next.js ルートや Node スクリプトが既にある場合、変更するのは3つだけです。ベース URL、キー、モデル ID です。このガイドでは、セットアップを AI SDK の OpenAI 互換プロバイダーのページ(2026年10月29日)と照合して確認します。CheapTokens API の Chat Completions インターフェースを使用します。これはそのプロバイダーが話すインターフェースです。
インストールとプロバイダーの作成#
2つのパッケージ:コアの ai パッケージと OpenAI 互換プロバイダーです。
npm install ai @ai-sdk/openai-compatible
export CHEAPTOKENS_API_KEY=ct_your_key_here
作業の順序は短いです:
順番に並べる
セットアップを整える
項目をドラッグするか矢印を使う
- 残高をチャージし、API キーを作成する
- キーを環境変数に入れる
- CheapTokens の baseURL でプロバイダーを作成する
- 完全なモデル ID を generateText に渡す
プロバイダー自体は createOpenAICompatible への1回の呼び出しです:
import { createOpenAICompatible } from '@ai-sdk/openai-compatible';

export const cheaptokens = createOpenAICompatible({
  name: 'cheaptokens',
  apiKey: process.env.CHEAPTOKENS_API_KEY,
  baseURL: 'https://api.cheaptokens.dev/v1',
  includeUsage: true,
});
name は自分のログ用のラベルにすぎません。includeUsage: true はストリーミング応答でもトークン数を要求します。これがないと、デフォルトは false のように動作します。cheaptokens('model- を呼び出すとチャットモデルが得られます。cheaptokens. と cheaptokens. も同じことをします。
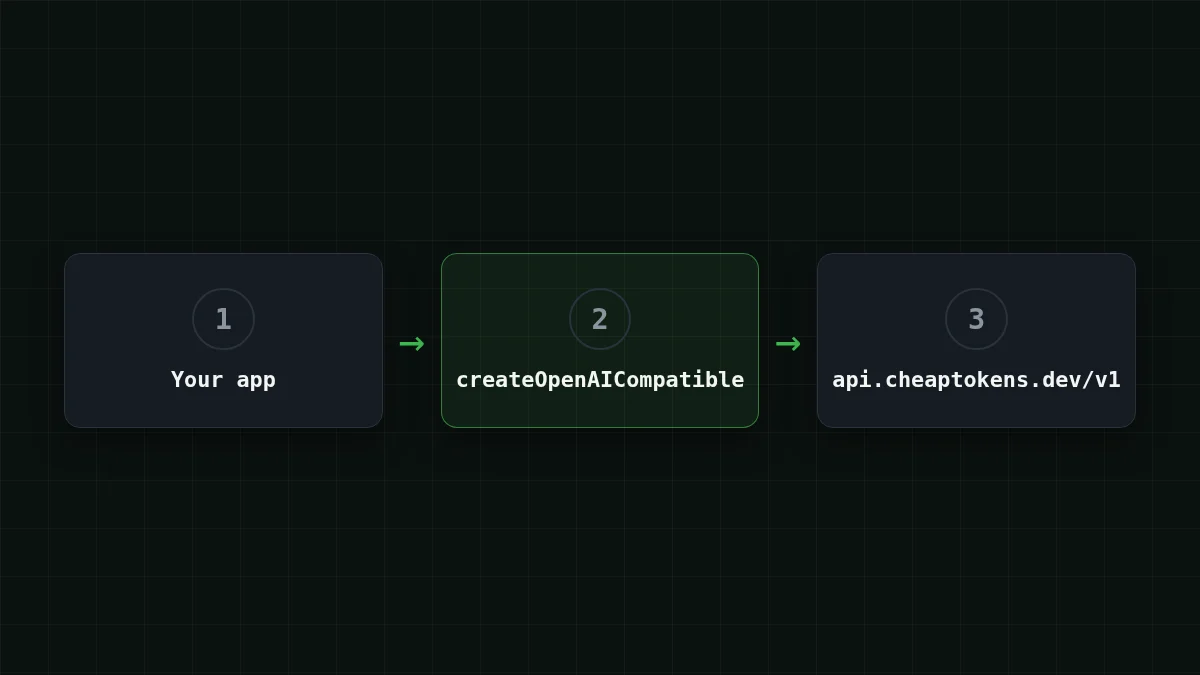
モデル ID は完全なものでなければなりません:deepseek-。deepseek- のような短い名前は価格表に表示されるもので、API は受け付けません。何を入力すればよいかわからない場合は、GET /v1/models でモデルを一覧表示し、そこから ID をコピーしてください。
generateText:1つの回答とそのトークン数#
完全なスクリプトはこちらです。短い回答を要求し、テキストと usage オブジェクトの両方を出力します。
import { generateText } from 'ai';
import { cheaptokens } from './provider';

const result = await generateText({
  model: cheaptokens('deepseek-ai/DeepSeek-V4-Flash-0731'),
  prompt: 'Explain in two sentences what a base URL is.',
});

console.log(result.text);
console.log(result.usage);
npx tsx index.ts で実行します。回答は result.text に文字列として入り、result.usage にはその呼び出しの入力トークン数と出力トークン数が入ります。オブジェクト全体を出力するので、中身がすべて見えます。streamText の AI SDK リファレンス(2026年10月29日確認)では、usage に inputTokens、outputTokens、totalTokens があります。ダッシュボードに組み込む前に、インストールしたバージョンの型を確認してください。
なぜ usage を読むのでしょうか?それは支払う金額だからです。アプリが1,500トークンのプロンプトを送り、600トークンの回答を得たとします。そのリクエストは現在の価格で $0.000083 かかり、1,000回では次のようになります:
| モデル | 入力 $/1M | 出力 $/1M | リクエストあたり | 1,000 リクエスト | OpenRouter、1,000 リクエスト |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000054 | $0.054 | $0.107 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000083 | $0.0825 | $0.165 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00017 | $0.165 | $1.17 |
リクエストあたり 1,500 入力トークンと 600 出力トークン。100万トークンあたりの価格は現行のもので、当社の料金体系に合わせて変動します。OpenRouter 列は同じワークロードの参考価格を示しています。
CheapTokens の列は合計(入力と出力を合わせて)で、表内のすべてのモデルで OpenRouter より安いです。usage を実行中の予算に変えたい場合は、エージェントのトークンコストの追跡で Python のアイデアを示しています。計算は TypeScript でも同じです。
streamText:到着した単語を出力する#
チャット UI では、モデルがまだ書いている間にテキストを表示したいものです。streamText はテキストチャンクの非同期イテラブルを返します。
import { streamText } from 'ai';
import { cheaptokens } from './provider';

const result = streamText({
  model: cheaptokens('deepseek-ai/DeepSeek-V4-Flash-0731'),
  prompt: 'Write a 100-word product description for a pocket notebook.',
});

for await (const chunk of result.textStream) {
  process.stdout.write(chunk);
}

console.log('\n', await result.usage);
streamText(...) の前に await がないことに注意してください。すぐに返り、ストリームを消費します。usage はストリームが終了したときに解決されるプロミスなので、ループの後に await します。Next.js のルートハンドラーでは、stdout に書き込む代わりにストリームをブラウザに返します。プロバイダー部分は同じです。同じことを素の OpenAI SDK で行いたい場合は、Node.js でのストリーミングチャット応答を参照してください。
長い回答もここでは問題ありません。CheapTokens の DeepSeek-V4-Flash は1回の回答で最大32,768トークンを書き込め、380K のコンテキストウィンドウを持ち、時間帯に関係なく1つの価格です。モデルページは /en/cheap-deepseek/ にあり、現在の価格は価格ページにあります。
残りを触らずにモデルを切り替える#
変わるのはモデル ID だけなので、別のモデルを試すのは1行の編集です。GLM-5.3-Flash は390K のコンテキストウィンドウを持ち、最大8,192トークンまで回答します。現在の価格では、100万入力トークンあたり $0.02、100万出力トークンあたり $0.04 です。
自分で試す試してみましょう:同じスクリプトを GLM-5.3-Flash で実行するには、どの行を変更しますか?答えを表示
モデル ID だけです:cheaptokens('zai-。プロバイダー、キー、baseURL、スクリプトの残りは同じままです。
便利なパターンは、ID を環境変数(process.)に保持して、再ビルドなしで同じプロンプトで2つのモデルを比較できるようにすることです。DeepSeek vs GLM vs MiniMax の比較は、どれを試す価値があるかを選ぶのに役立ちます。
動作しない場合#
ほとんどの失敗は3つのうちの1つです:キー、URL、モデル ID。
- 401 はキーが欠落しているか間違っていることを意味します。スクリプトを実行するシェルで
CHEAPTOKENS_が設定されていることを確認してください(Next.js サーバーではAPI_ KEY .env.localに設定し、再起動が必要です)。 - 404 は通常、baseURL から
/v1が失われたか、モデル ID が短い名前であることを意味します。https:/と完全な ID を使用してください。/ api. cheaptokens. dev/ v1 - 回答が途中で止まる。 モデルが出力制限に達しました。finish_reason "length" の修正で説明しています。
最初の2つについてのより長いウォークスルーは、API 401 または 404:間違ったキー、ベース URL、モデル IDにあります。
チェックリスト
スクリプトを実行する前に
他のツールの接続と最初の手動リクエストについては、CheapTokens ドキュメントから始めてください。


