API और SDKगाइड
कस्टम base URL के साथ Vercel AI SDK: TypeScript में CheapTokens
createOpenAICompatible के साथ Vercel AI SDK को CheapTokens पर इंगित करें: एक काम करने वाला generateText और streamText snippet, token usage और सामान्य errors के fixes।
इस पृष्ठ पर
Vercel AI SDK को CheapTokens पर चलाने के लिए, @ai- इंस्टॉल करें, baseURL: 'https:/ और अपनी key के साथ एक provider बनाएं, और provider('deepseek- को model के रूप में पास करें। आपके ऐप में बाकी सब कुछ, generateText, streamText, आपके prompts, वैसे ही रहता है।
तो अगर आपके पास पहले से कोई Next.js route या Node script है जो AI SDK के ज़रिए किसी hosted model से बात करता है, तो आप तीन चीज़ें बदलते हैं: base URL, key और model id। यह गाइड सेटअप को AI SDK के OpenAI-compatible providers page (29 October 2026) के साथ जाँचती है। यह CheapTokens API के Chat Completions interface का उपयोग करती है, जो वही है जो वह provider बोलता है।
Install करें और provider बनाएं#
दो packages: core ai package और OpenAI-compatible provider।
npm install ai @ai-sdk/openai-compatible
export CHEAPTOKENS_API_KEY=ct_your_key_here
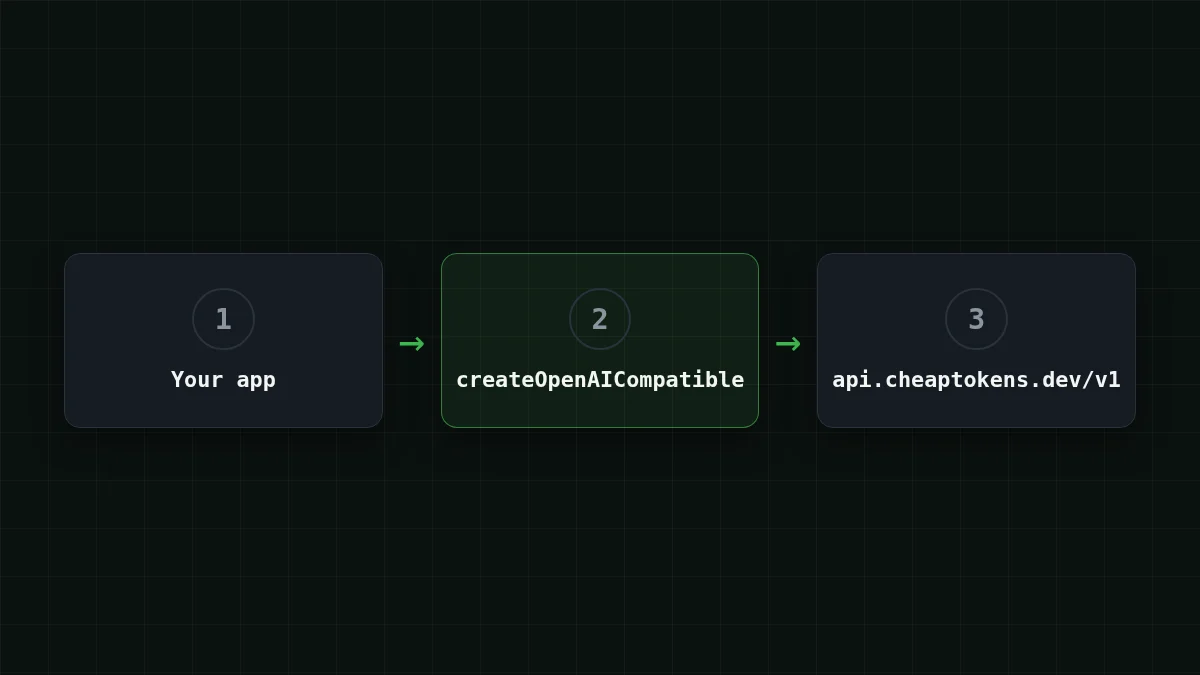
काम का क्रम छोटा है:
क्रम में लगाएँ
सेटअप को क्रम में रखें
आइटम खींचें या तीरों का उपयोग करें
- बैलेंस टॉप अप करें और एक API key बनाएं
- key को एक environment variable में रखें
- CheapTokens baseURL के साथ provider बनाएं
- generateText को पूरा model id पास करें
provider स्वयं createOpenAICompatible का एक call है:
import { createOpenAICompatible } from '@ai-sdk/openai-compatible';

export const cheaptokens = createOpenAICompatible({
  name: 'cheaptokens',
  apiKey: process.env.CHEAPTOKENS_API_KEY,
  baseURL: 'https://api.cheaptokens.dev/v1',
  includeUsage: true,
});
name आपके अपने logs के लिए बस एक label है। includeUsage: true streaming responses में भी token counts माँगता है; इसके बिना default false की तरह व्यवहार करता है। cheaptokens('model- call करने से आपको एक chat model मिलता है; cheaptokens. और cheaptokens. वही काम करते हैं।
model id पूरा होना चाहिए: deepseek-। deepseek- जैसा छोटा नाम वही है जो आप price tables में देखते हैं, और API उसे स्वीकार नहीं करेगा। अगर आपको यकीन नहीं है कि क्या टाइप करना है, तो GET /v1/models से models की सूची बनाएं और वहाँ से id कॉपी करें।
generateText: एक उत्तर और उसका token count#
यहाँ एक पूरा script है। यह एक छोटा उत्तर माँगता है और text और usage object दोनों प्रिंट करता है।
import { generateText } from 'ai';
import { cheaptokens } from './provider';

const result = await generateText({
  model: cheaptokens('deepseek-ai/DeepSeek-V4-Flash-0731'),
  prompt: 'Explain in two sentences what a base URL is.',
});

console.log(result.text);
console.log(result.usage);
इसे npx tsx index.ts से चलाएं। आपको उत्तर result.text में एक string के रूप में मिलता है, और result.usage उस call के input और output token counts रखता है। हम पूरा object प्रिंट करते हैं ताकि आप उसमें सब कुछ देख सकें। streamText के लिए AI SDK reference (29 October 2026 को जाँचा गया) में usage के पास inputTokens, outputTokens और totalTokens हैं; उन्हें किसी dashboard में जोड़ने से पहले अपने इंस्टॉल किए गए version के types जाँचें।
usage पढ़ने की ज़रूरत ही क्यों? क्योंकि वही वह संख्या है जिसके लिए आप भुगतान करते हैं। मान लें आपका ऐप 1,500-token का prompt भेजता है और 600-token का उत्तर पाता है। वह request मौजूदा कीमतों पर $0.000083 का खर्च करती है, और ऐसी एक हज़ार ऐसी दिखती हैं:
| मॉडल | इनपुट $/1M | आउटपुट $/1M | प्रति अनुरोध | 1,000 अनुरोध | OpenRouter, 1,000 अनुरोध |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000054 | $0.054 | $0.107 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000083 | $0.0825 | $0.165 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00017 | $0.165 | $1.17 |
प्रति अनुरोध 1,500 इनपुट और 600 आउटपुट टोकन। प्रति 1M टोकन की कीमतें वर्तमान हैं और हमारे टैरिफ के साथ बदलती रहती हैं; OpenRouter कॉलम समान कार्यभार के लिए संदर्भ कीमतें दिखाता है।
CheapTokens column कुल में है, input और output मिलाकर, तालिका के हर model के लिए OpenRouter से सस्ता। अगर आप usage को एक चालू बजट में बदलना चाहते हैं, तो tracking agent token cost विचार को Python में दिखाता है; TypeScript में गणित वही है।
streamText: शब्द आते ही प्रिंट करें#
chat UI के लिए आप चाहते हैं कि text तब दिखे जब model अभी लिख रहा हो। streamText आपको text chunks का एक async iterable देता है।
import { streamText } from 'ai';
import { cheaptokens } from './provider';

const result = streamText({
  model: cheaptokens('deepseek-ai/DeepSeek-V4-Flash-0731'),
  prompt: 'Write a 100-word product description for a pocket notebook.',
});

for await (const chunk of result.textStream) {
  process.stdout.write(chunk);
}

console.log('\n', await result.usage);
ध्यान दें कि streamText(...) के आगे कोई await नहीं है: यह तुरंत लौटता है और आप stream consume करते हैं। usage एक promise है जो stream खत्म होने पर settle होता है, इसलिए आप इसे loop के बाद await करते हैं। Next.js route handler में आप stdout पर लिखने के बजाय stream को browser को लौटाएँगे; provider वाला हिस्सा बिल्कुल वही है। अगर आप यही चीज़ सादे OpenAI SDK के साथ चाहते हैं, तो streaming chat responses in Node.js देखें।
यहाँ लंबे उत्तर ठीक हैं: CheapTokens पर DeepSeek-V4-Flash एक उत्तर में 32,768 tokens तक लिख सकता है, इसका 380K context window है और किसी भी घंटे एक ही कीमत है। model page /en/cheap-deepseek/ पर है, और मौजूदा कीमतें the pricing page पर हैं।
बाकी कुछ छुए बिना model बदलें#
चूँकि केवल model id बदलता है, दूसरा model आज़माना एक पंक्ति का संपादन है। GLM-5.3-Flash का 390K context window है और यह 8,192 tokens तक उत्तर देता है; मौजूदा कीमतों पर इसका खर्च $0.02 प्रति 1M input tokens और $0.04 प्रति 1M output tokens है।
स्वयं आज़माएँइसे आज़माएं: वही script GLM-5.3-Flash पर चलाने के लिए आप कौन-सी पंक्ति बदलते हैं?उत्तर दिखाएँ
केवल model id: cheaptokens('zai-। provider, key, baseURL और script का बाकी हिस्सा वैसे ही रहता है।
एक उपयोगी pattern है id को एक environment variable (process.) में रखना ताकि आप rebuild के बिना एक ही prompt पर दो models की तुलना कर सकें। DeepSeek vs GLM vs MiniMax comparison यह चुनने में मदद करता है कि कौन-से आज़माने लायक हैं।
अगर यह काम न करे#
अधिकांश विफलताएँ तीन में से एक होती हैं: key, URL या model id।
- 401 का मतलब है key गायब है या गलत है। जाँचें कि
CHEAPTOKENS_उस shell में सेट है जो script चलाता है (Next.js server को यहAPI_ KEY .env.localमें चाहिए और एक restart भी)। - 404 का आमतौर पर मतलब है baseURL से
/v1छूट गया या model id छोटा नाम है।https:/और पूरा id उपयोग करें।/ api. cheaptokens. dev/ v1 - उत्तर बीच वाक्य में रुक जाता है। model एक output limit पर पहुँच गया; finish_reason "length" fix इसे समझाता है।
पहले दो का लंबा walkthrough API 401 or 404: wrong key, base URL or model id में है।
चेकलिस्ट
script चलाने से पहले
अन्य tools जोड़ने और हाथ से पहली request के लिए, CheapTokens docs से शुरू करें।


