AI خبریںتجزیہ
DeepSeek نے DeepInfer اوپن سورس کیا: یہ کیا ہے اور کس کو self-host کرنا چاہیے
DeepSeek نے DeepInfer کو Apache-2.0 کے تحت جاری کیا: V4.1-Flash کے لیے inference کوڈ۔ کیا شامل ہے، کون سا ہارڈویئر درکار ہے، اور API کب آسان انتخاب ہے۔
اس صفحہ پر
20 اکتوبر 2026 کو DeepSeek نے DeepInfer کو GitHub (deepseek-) پر Apache License 2.0 کے تحت شائع کیا۔ یہ DeepSeek ماڈلز کے لیے inference فریم ورک ہے۔ README کے مطابق، یہ DeepSeek کی بڑے پیمانے پر پروڈکشن سروسز کو طاقت دیتا ہے۔ اجرا کی تاریخ @deepseek_ai کی پوسٹ سے آئی ہے جیسا کہ ایک Telegram ڈائجسٹ نے نقل کیا؛ README میں خود کوئی تاریخ نہیں ہے۔
DeepInfer کیا ہے#
DeepInfer وہ کوڈ ہے جو کسی ماڈل کو GPUs یا NPUs پر تیزی سے چلاتا ہے۔ یہ نہ ماڈل ہے اور نہ ہوسٹڈ سروس۔ واحد معاون ماڈل DeepSeek-V4.1-Flash ہے۔ بطور ڈیفالٹ یہ پہلی بار چلانے پر checkpoint deepseek- کو Hugging Face cache میں ڈاؤن لوڈ کرتا ہے۔ اگر آپ کے پاس پہلے سے weights موجود ہیں، تو مقامی کاپی استعمال کرنے کے لیے DEEPINFER_ سیٹ کریں۔
باکس میں کیا ہے#
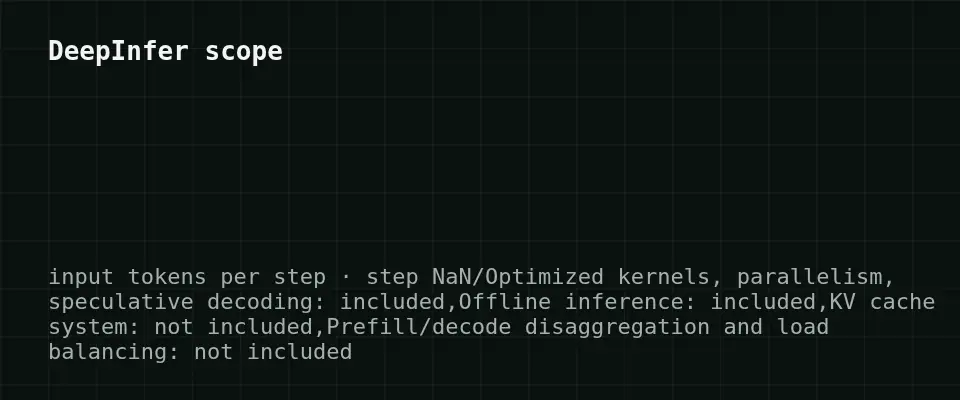
README درج ذیل خصوصیات کی فہرست دیتا ہے:
- بہتر بنائے گئے kernels؛
- load balancing کے ساتھ data، context اور expert parallelism؛
- confidence-based verification کے ساتھ speculative decoding؛
- prefill کے لیے bounded sliding-window replay؛
- asynchronous scheduling؛
- batch-invariant inference اور deterministic sampling؛
- structured outputs: regex، JSON schema اور grammar۔
ان میں سے کئی خصوصیات صرف NVIDIA کے لیے ہیں۔
کیا شامل نہیں ہے#
یہ ریلیز صرف offline inference فراہم کرتی ہے۔ README کہتا ہے کہ مکمل inference سروس کے لیے KV cache system، prefill/decode disaggregation اور load balancing بھی درکار ہوتے ہیں، اور یہ اس ریلیز کا حصہ نہیں ہیں۔ تو آپ کو انجن ملتا ہے، پورا پروڈکشن اسٹیک نہیں۔ صارفین کے لیے اسے API کے پیچھے لگانا وہ کام ہے جو آپ خود کریں گے۔
ہارڈویئر اور سیٹ اپ#
ٹیبل کو دائیں طرف اسکرول کریں →
| Requirement | Details |
|---|---|
| Accelerators | NVIDIA SM100 GPUs یا Huawei Ascend 950 NPUs |
| OS | Linux |
| Compiler | GCC 13+ |
| Python | 3.12 |
| Runtime | CUDA 13 (NVIDIA) یا CANN 9.2 (Ascend) |
شائع شدہ benchmarks (prefill اور decode Pareto charts) prefill کے لیے 4 SM100 GPUs اور decode کے لیے 64 پر ماپے گئے، ہر ایک ایک scale-up domain کے اندر۔ charts تصاویر ہیں، اس لیے ہم throughput یا latency کے اعداد و شمار نقل نہیں کرتے۔ ہمارے پاس اس بارے میں بھی کوئی ڈیٹا نہیں کہ DeepInfer کسی کی API قیمت بدلتا ہے یا نہیں، اس لیے ہم ایسا کوئی دعویٰ نہیں کرتے۔
کیا آپ کو خود چلانا چاہیے؟#
Self-hosting اس وقت معنی رکھتا ہے جب آپ پہلے سے SM100 یا Ascend 950 ہارڈویئر چلا رہے ہوں، weights پر مکمل کنٹرول یا deterministic یا batch-invariant رویے کی ضرورت ہو، یا اپنی serving layer بنانا چاہیں۔ benchmark سیٹ اپ (decode کے لیے درجنوں GPUs) دکھاتا ہے کہ فریم ورک کس چیز کے لیے tune کیا گیا ہے: بڑے پیمانے پر serving۔
اگر آپ کو صرف اپنی ایپ میں DeepSeek-family آؤٹ پٹ چاہیے، تو یہ فریم ورک سنبھالنے کے لیے بہت زیادہ انفراسٹرکچر ہے۔ API کال کرنا آسان ہے: نہ GPUs، نہ CUDA یا CANN ورژنز ملانے کی ضرورت۔
اسی قسم کے کام کے لیے API کا آپشن#
اگر آپ اپنا GPU کلسٹر نہیں چلانا چاہتے، تو CheapTokens پر MiniMax-M2.7 API کے ذریعے chat، coding اور agent کام سنبھالتا ہے، ساتھ:
- تمام ماڈلز کے لیے ایک بیلنس اور OpenAI- اور Anthropic-compatible API؛
- فی جواب زیادہ سے زیادہ 8,192 output tokens اور 180K context؛
- فی ماڈل مقررہ قیمت، بغیر peak hours؛
- مجموعی طور پر OpenRouter سے سستا، input اور output ملا کر شمار۔
فی 1M tokens موجودہ قیمتیں: input $0.05، output $0.15۔ مثال کے طور پر 2,000 input اور 500 output tokens فی درخواست، 1,000 درخواستیں:
| ماڈل | ان پٹ $/1M | آؤٹ پٹ $/1M | فی درخواست | 1,000 درخواستیں | OpenRouter، 1,000 درخواستیں |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00006 | $0.06 | $0.121 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00008 | $0.08 | $0.173 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00018 | $0.175 | $1.20 |
فی درخواست 2,000 ان پٹ اور 500 آؤٹ پٹ ٹوکنز۔ فی 1M ٹوکنز کی قیمتیں موجودہ ہیں اور ہمارے ٹیرف کے ساتھ تبدیل ہوتی ہیں؛ OpenRouter کالم اسی ورک لوڈ کے لیے حوالہ جاتی قیمتیں دکھاتا ہے۔
ماڈل میں خود کیا بدلا، اس کے لیے DeepSeek-V4.1-Flash-1017 مضمون دیکھیں۔
خلاصہ#
DeepInfer پروڈکشن inference کوڈ کی حقیقی اوپن ریلیز ہے، لیکن صرف offline اور مخصوص ہارڈویئر (NVIDIA SM100 یا Ascend 950) سے منسلک۔ جن ٹیموں کے پاس یہ ہارڈویئر اور serving ٹیم ہے، ان کے لیے یہ دلچسپ ہوگا۔ زیادہ تر ڈویلپرز API کال کرتے رہیں گے اور اپنے token mix کے لیے اخراجات کا موازنہ کریں گے۔


