Nowości AIAnaliza
DeepSeek otwiera kod DeepInfer: czym jest i kto powinien hostować go samodzielnie
DeepSeek wydał DeepInfer na licencji Apache-2.0: kod inferencyjny dla V4.1-Flash. Co zawiera, jaki sprzęt wymaga i kiedy API jest prostszym wyborem.
Na tej stronie
20 października 2026 DeepSeek opublikował DeepInfer na GitHubie (deepseek-) na licencji Apache License 2.0. To framework inferencyjny dla modeli DeepSeek. Według README napędza on usługi produkcyjne DeepSeek w dużej skali. Data wydania pochodzi z posta @deepseek_ai przekazanego przez digest na Telegramie; samo README nie zawiera daty.
Czym jest DeepInfer#
DeepInfer to kod, który szybko uruchamia model na GPU lub NPU. To nie model i nie usługa hostowana. Jedynym obsługiwanym modelem jest DeepSeek-V4.1-Flash. Domyślnie przy pierwszym uruchomieniu pobiera checkpoint deepseek- do cache'u Hugging Face. Jeśli masz już wagi, ustaw DEEPINFER_, aby użyć lokalnej kopii.
Co zawiera#
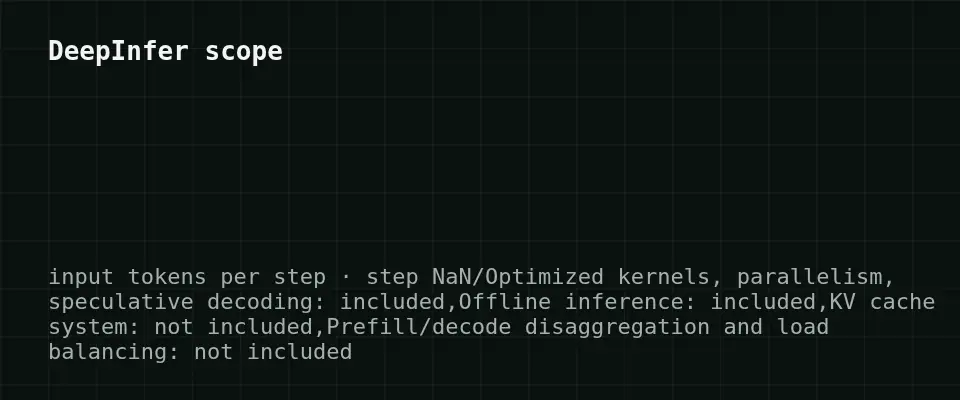
README wymienia następujące funkcje:
- zoptymalizowane kernele;
- równoległość danych, kontekstu i ekspertów z równoważeniem obciążenia;
- dekodowanie spekulatywne z weryfikacją opartą na pewności;
- ograniczone odtwarzanie okna przesuwnego dla prefill;
- asynchroniczne planowanie;
- inferencję niezmienną względem batcha i deterministyczne próbkowanie;
- ustrukturyzowane wyjścia: regex, schemat JSON i gramatyka.
Kilka z tych funkcji działa wyłącznie na NVIDIA.
Czego nie zawiera#
To wydanie zapewnia wyłącznie inferencję offline. README mówi, że pełna usługa inferencyjna wymaga także systemu KV cache, rozdzielenia prefill/decode i równoważenia obciążenia, a tych nie ma w wydaniu. Dostajesz więc silnik, a nie cały stos produkcyjny. Udostępnienie go użytkownikom przez API to praca, którą musisz wykonać sam.
Sprzęt i konfiguracja#
Przewiń tabelę w prawo →
| Wymaganie | Szczegóły |
|---|---|
| Akceleratory | GPU NVIDIA SM100 lub NPU Huawei Ascend 950 |
| System | Linux |
| Kompilator | GCC 13+ |
| Python | 3.12 |
| Środowisko uruchomieniowe | CUDA 13 (NVIDIA) lub CANN 9.2 (Ascend) |
Opublikowane benchmarki (wykresy Pareto dla prefill i decode) zmierzono na 4 GPU SM100 dla prefill i 64 dla decode, każdy w obrębie jednej domeny scale-up. Wykresy są obrazami, więc nie podajemy liczb przepustowości ani opóźnień. Nie mamy też danych, czy DeepInfer zmienia czyjekolwiek ceny API, więc nie wysuwamy takiego twierdzenia.
Czy warto uruchamiać go samodzielnie?#
Self-hosting ma sens, jeśli już obsługujesz sprzęt SM100 lub Ascend 950, potrzebujesz pełnej kontroli nad wagami i deterministycznego zachowania lub niezmienności względem batcha, albo chcesz zbudować własną warstwę serwowania. Konfiguracja benchmarku (dziesiątki GPU dla decode) pokazuje, do czego framework jest dostrojony: serwowania w dużej skali.
Jeśli potrzebujesz w aplikacji tylko wyników z rodziny DeepSeek, framework to dużo infrastruktury do wzięcia na siebie. Wywołanie API jest prostsze: bez GPU, bez dopasowywania wersji CUDA czy CANN.
Opcja API dla podobnego zadania#
Jeśli wolisz nie uruchamiać własnego klastra GPU, MiniMax-M2.7 w CheapTokens obsługuje zadania czatowe, kodowania i agentowe przez API, z:
- jednym saldem dla wszystkich modeli oraz API zgodnym z OpenAI i Anthropic;
- do 8 192 tokenów wyjściowych na odpowiedź i kontekstem 180K;
- stałą ceną za model bez godzin szczytu;
- łącznie taniej niż OpenRouter, przy liczeniu wejścia i wyjścia razem.
Aktualne ceny za 1M tokenów: wejście $0.05, wyjście $0.15. Przykładowe obciążenie: 2 000 tokenów wejściowych i 500 wyjściowych na żądanie, 1 000 żądań:
| Model | Wejście $/1M | Wyjście $/1M | Za żądanie | 1000 żądań | OpenRouter, 1000 żądań |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00006 | $0.06 | $0.121 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00008 | $0.08 | $0.173 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00018 | $0.175 | $1.20 |
2000 tokenów wejściowych i 500 tokenów wyjściowych na żądanie. Ceny za 1 mln tokenów są aktualne i zmieniają się wraz z naszymi taryfami; kolumna OpenRouter pokazuje ceny referencyjne dla tego samego obciążenia.
Zobacz artykuł o DeepSeek-V4.1-Flash-1017, aby dowiedzieć się, co zmieniło się w samym modelu.
Podsumowanie#
DeepInfer to prawdziwe otwarte wydanie produkcyjnego kodu inferencyjnego, ale tylko offline i powiązane z konkretnym sprzętem (NVIDIA SM100 lub Ascend 950). Zespoły z takim sprzętem i zespołem serwującym uznają je za interesujące. Większość deweloperów będzie nadal wywoływać API i porównywać koszty dla własnej mieszanki tokenów.


