AI समाचारविश्लेषण
DeepSeek ने DeepInfer ओपन-सोर्स किया: यह क्या है और किसे self-host करना चाहिए
DeepSeek ने DeepInfer को Apache-2.0 के तहत जारी किया: V4.1-Flash के लिए inference कोड। क्या शामिल है, किस हार्डवेयर की आवश्यकता है, और कब API सरल विकल्प है।
इस पृष्ठ पर
20 अक्टूबर 2026 को DeepSeek ने DeepInfer को GitHub (deepseek-) पर Apache License 2.0 के तहत प्रकाशित किया। यह DeepSeek मॉडलों के लिए inference फ्रेमवर्क है। README के अनुसार, यह DeepSeek की बड़े पैमाने की production सेवाओं को चलाता है। रिलीज़ की तारीख @deepseek_ai पोस्ट से आती है, जिसे एक Telegram डाइजेस्ट ने आगे भेजा; README में स्वयं कोई तारीख नहीं है।
DeepInfer क्या है#
DeepInfer वह कोड है जो किसी मॉडल को GPU या NPU पर तेज़ी से चलाता है। यह न मॉडल है और न होस्टेड सेवा। एकमात्र समर्थित मॉडल DeepSeek-V4.1-Flash है। डिफ़ॉल्ट रूप से यह पहली बार चलने पर चेकपॉइंट deepseek- को Hugging Face cache में डाउनलोड करता है। यदि आपके पास पहले से वेट्स हैं, तो स्थानीय कॉपी उपयोग करने के लिए DEEPINFER_ सेट करें।
बॉक्स में क्या है#
README इन सुविधाओं की सूची देता है:
- अनुकूलित kernels;
- load balancing के साथ data, context और expert parallelism;
- confidence-आधारित सत्यापन के साथ speculative decoding;
- prefill के लिए bounded sliding-window replay;
- asynchronous scheduling;
- batch-invariant inference और deterministic sampling;
- संरचित आउटपुट: regex, JSON schema और grammar।
इनमें से कई सुविधाएँ केवल NVIDIA के लिए हैं।
क्या शामिल नहीं है#
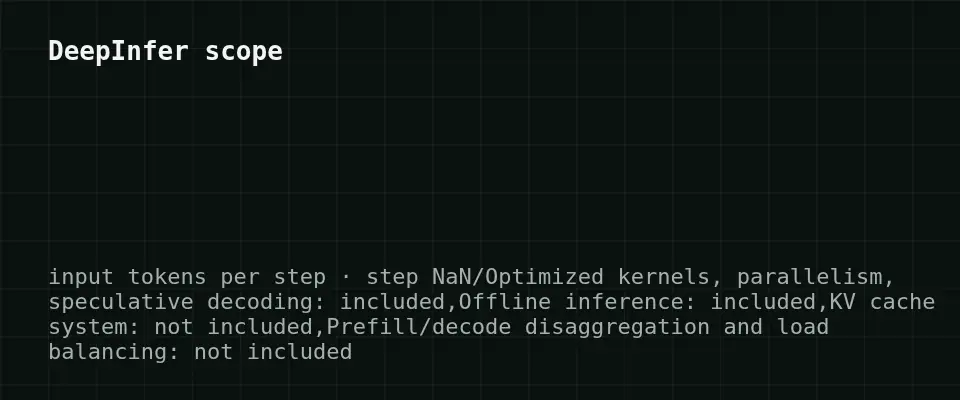
यह रिलीज़ केवल ऑफ़लाइन inference प्रदान करती है। README कहता है कि पूर्ण inference सेवा के लिए KV cache सिस्टम, prefill/decode disaggregation और load balancing भी आवश्यक हैं, और ये रिलीज़ का हिस्सा नहीं हैं। तो आपको इंजन मिलता है, पूरा production स्टैक नहीं। उपयोगकर्ताओं के लिए इसे API के पीछे लगाना आपका अपना काम होगा।
हार्डवेयर और सेटअप#
तालिका को दाईं ओर स्क्रॉल करें →
| आवश्यकता | विवरण |
|---|---|
| Accelerators | NVIDIA SM100 GPUs या Huawei Ascend 950 NPUs |
| OS | Linux |
| Compiler | GCC 13+ |
| Python | 3.12 |
| Runtime | CUDA 13 (NVIDIA) या CANN 9.2 (Ascend) |
प्रकाशित बेंचमार्क (prefill और decode Pareto चार्ट) prefill के लिए 4 SM100 GPUs और decode के लिए 64 GPUs पर मापे गए, प्रत्येक एक scale-up domain के भीतर। चार्ट छवियाँ हैं, इसलिए हम throughput या latency के आंकड़े नहीं देते। हमारे पास यह डेटा भी नहीं है कि DeepInfer किसी के API मूल्य को बदलता है या नहीं, इसलिए हम ऐसा कोई दावा नहीं करते।
क्या आपको इसे स्वयं चलाना चाहिए?#
Self-hosting तब समझ में आता है जब आपके पास पहले से SM100 या Ascend 950 हार्डवेयर हो, आपको वेट्स पर पूर्ण नियंत्रण और deterministic या batch-invariant व्यवहार चाहिए, या आप अपनी स्वयं की serving परत बनाना चाहते हैं। बेंचमार्क सेटअप (decode के लिए दर्जनों GPUs) दिखाता है कि फ्रेमवर्क किसके लिए ट्यून किया गया है: बड़े पैमाने की serving।
यदि आपको बस अपने ऐप में DeepSeek-परिवार का आउटपुट चाहिए, तो यह फ्रेमवर्क बहुत अधिक इंफ्रास्ट्रक्चर है। API कॉल करना सरल है: कोई GPUs नहीं, CUDA या CANN संस्करणों का मिलान नहीं।
उसी प्रकार के कार्य के लिए एक API विकल्प#
यदि आप अपना GPU क्लस्टर नहीं चलाना चाहते, तो CheapTokens पर MiniMax-M2.7 API के माध्यम से चैट, कोडिंग और एजेंट कार्य संभालता है, साथ में:
- सभी मॉडलों के लिए एक बैलेंस और OpenAI- तथा Anthropic-संगत API;
- प्रति उत्तर अधिकतम 8,192 आउटपुट टोकन और 180K context;
- प्रति मॉडल निश्चित मूल्य, बिना peak hours;
- कुल मिलाकर OpenRouter से सस्ता, input और output एक साथ गिने जाते हैं।
प्रति 1M टोकन वर्तमान मूल्य: input $0.05, output $0.15। उदाहरण वर्कलोड: प्रति अनुरोध 2,000 input और 500 output टोकन, 1,000 अनुरोध:
| मॉडल | इनपुट $/1M | आउटपुट $/1M | प्रति अनुरोध | 1,000 अनुरोध | OpenRouter, 1,000 अनुरोध |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00006 | $0.06 | $0.121 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00008 | $0.08 | $0.173 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00018 | $0.175 | $1.20 |
प्रति अनुरोध 2,000 इनपुट और 500 आउटपुट टोकन। प्रति 1M टोकन की कीमतें वर्तमान हैं और हमारे टैरिफ के साथ बदलती रहती हैं; OpenRouter कॉलम समान कार्यभार के लिए संदर्भ कीमतें दिखाता है।
मॉडल में ही क्या बदला, यह जानने के लिए DeepSeek-V4.1-Flash-1017 लेख देखें।
निष्कर्ष#
DeepInfer production inference कोड का वास्तविक ओपन रिलीज़ है, लेकिन केवल ऑफ़लाइन और विशिष्ट हार्डवेयर (NVIDIA SM100 या Ascend 950) से बंधा। जिन टीमों के पास वह हार्डवेयर और serving टीम है, उन्हें यह दिलचस्प लगेगा। अधिकांश डेवलपर्स API कॉल करते रहेंगे और अपने टोकन मिश्रण के लिए लागत की तुलना करेंगे।


