AIニュース詳細解説
DeepSeekがDeepInferをオープンソース化: その内容とセルフホストすべき人
DeepSeekはDeepInferをApache-2.0で公開しました: V4.1-Flash向けの推論コードです。含まれるもの、必要なハードウェア、APIがより簡単な選択となる場合について。
2026年10月20日、DeepSeekはDeepInferをApache License 2.0の下でGitHub(deepseek-)に公開しました。これはDeepSeekモデル向けの推論フレームワークです。READMEによると、DeepSeekの大規模本番サービスを支えています。公開日はTelegramのダイジェスト経由で伝えられた@deepseek_aiの投稿によるもので、README自体には日付がありません。
DeepInferとは#
DeepInferは、GPUやNPU上でモデルを高速に実行するコードです。モデルでもホスト型サービスでもありません。サポートされるモデルはDeepSeek-V4.1-Flashのみです。デフォルトでは初回実行時にチェックポイントdeepseek-をHugging Faceキャッシュにダウンロードします。すでに重みを持っている場合は、DEEPINFER_を設定してローカルコピーを使用します。
含まれるもの#
READMEには以下の機能が記載されています:
- 最適化されたカーネル;
- ロードバランシングを伴うデータ、コンテキスト、エキスパート並列処理;
- 信頼度ベースの検証を伴う投機的デコーディング;
- prefill向けの有界スライディングウィンドウリプレイ;
- 非同期スケジューリング;
- バッチ不変推論と決定論的サンプリング;
- 構造化出力: 正規表現、JSONスキーマ、文法。
これらの機能のいくつかはNVIDIA専用です。
含まれないもの#
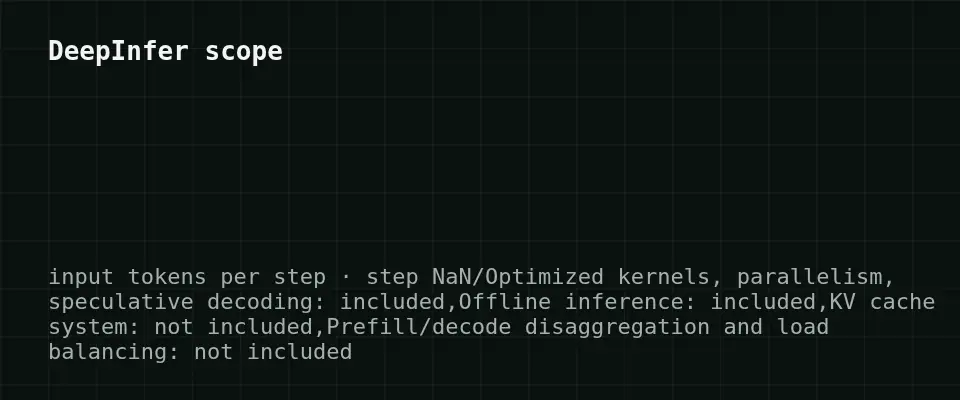
このリリースはオフライン推論のみを提供します。READMEによると、完全な推論サービスにはKVキャッシュシステム、prefill/decode分離、ロードバランシングも必要であり、これらはリリースに含まれていません。つまり得られるのはエンジンであり、本番スタック全体ではありません。ユーザー向けにAPIの背後に置くのは自分で行う作業です。
ハードウェアとセットアップ#
テーブルを右にスクロールしてください →
| 要件 | 詳細 |
|---|---|
| アクセラレータ | NVIDIA SM100 GPUまたはHuawei Ascend 950 NPU |
| OS | Linux |
| コンパイラ | GCC 13+ |
| Python | 3.12 |
| ランタイム | CUDA 13(NVIDIA)またはCANN 9.2(Ascend) |
公開されているベンチマーク(prefillとdecodeのパレート図)は、prefillが4台、decodeが64台のSM100 GPUで測定され、それぞれ1つのスケールアップドメイン内で行われました。図は画像であるため、スループットやレイテンシの数値は引用しません。また、DeepInferが誰かのAPI価格を変えるかどうかのデータもないため、そのような主張はしません。
自分で実行すべきか?#
セルフホスティングは、すでにSM100またはAscend 950のハードウェアを運用している場合、重みと決定論的またはバッチ不変の動作を完全に制御する必要がある場合、あるいは独自のサービングレイヤーを構築したい場合に理にかなっています。ベンチマークのセットアップ(decodeに数十台のGPU)は、このフレームワークが何にチューニングされているかを示しています: 大規模サービングです。
アプリでDeepSeekファミリーの出力が必要なだけなら、このフレームワークは引き受けるにはインフラが多すぎます。APIを呼び出す方が簡単です: GPUも、CUDAやCANNのバージョン合わせも不要です。
同種のタスク向けのAPIオプション#
独自のGPUクラスタを実行したくない場合、CheapTokensのMiniMax-M2.7がAPI経由でチャット、コーディング、エージェントタスクを処理します。特長は:
- 全モデルで1つの残高、OpenAIおよびAnthropic互換のAPI;
- 回答あたり最大8,192出力トークン、180Kコンテキスト;
- ピーク時間なしのモデルごとの固定価格;
- 入力と出力を合算してOpenRouterより総額で安価。
現在の1Mトークンあたりの価格: 入力$0.05、出力$0.15。リクエストあたり入力2,000トークン、出力500トークン、1,000リクエストのワークロード例:
| モデル | 入力 $/1M | 出力 $/1M | リクエストあたり | 1,000 リクエスト | OpenRouter、1,000 リクエスト |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00006 | $0.06 | $0.121 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00008 | $0.08 | $0.173 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00018 | $0.175 | $1.20 |
リクエストあたり 2,000 入力トークンと 500 出力トークン。100万トークンあたりの価格は現行のもので、当社の料金体系に合わせて変動します。OpenRouter 列は同じワークロードの参考価格を示しています。
モデル自体の変更点についてはDeepSeek-V4.1-Flash-1017の記事を参照してください。
まとめ#
DeepInferは本番推論コードの実際のオープンリリースですが、オフライン専用で、特定のハードウェア(NVIDIA SM100またはAscend 950)に縛られています。そのハードウェアとサービングチームを持つチームには興味深いでしょう。ほとんどの開発者はAPIを呼び続け、自分のトークン構成でコストを比較するでしょう。


