Actus IAAnalyse
DeepSeek ouvre le code de DeepInfer : de quoi s'agit-il et qui doit l'auto-héberger
DeepSeek a publié DeepInfer sous Apache-2.0 : du code d'inférence pour V4.1-Flash. Ce qui est inclus, le matériel requis et quand une API est le choix le plus simple.
Sur cette page
Le 20 octobre 2026, DeepSeek a publié DeepInfer sur GitHub (deepseek-) sous licence Apache 2.0. C'est le framework d'inférence des modèles DeepSeek. D'après le README, il alimente les services de production à grande échelle de DeepSeek. La date de publication provient du post @deepseek_ai relayé par un digest Telegram ; le README lui-même ne porte pas de date.
Ce qu'est DeepInfer#
DeepInfer est du code qui exécute un modèle rapidement sur GPU ou NPU. Ce n'est ni un modèle ni un service hébergé. Le seul modèle pris en charge est DeepSeek-V4.1-Flash. Par défaut, il télécharge le checkpoint deepseek- dans le cache Hugging Face au premier lancement. Si vous disposez déjà des poids, définissez DEEPINFER_ pour utiliser une copie locale.
Ce qui est inclus#
Le README liste ces fonctionnalités :
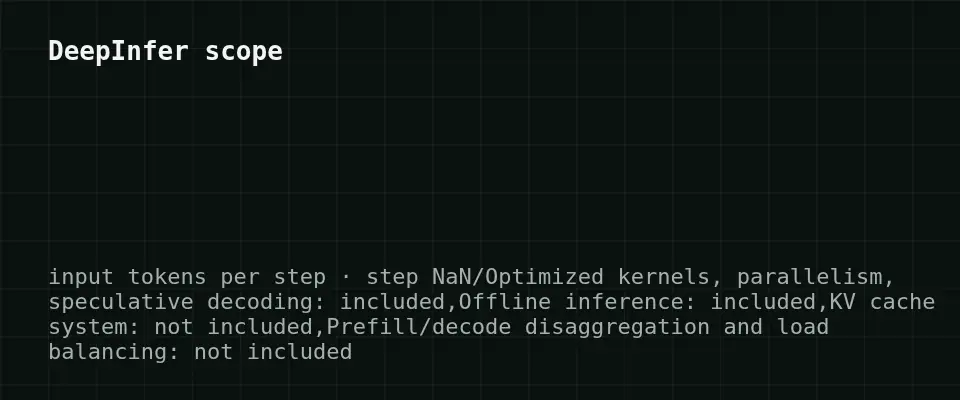
- des kernels optimisés ;
- le parallélisme de données, de contexte et d'experts avec équilibrage de charge ;
- le décodage spéculatif avec vérification fondée sur la confiance ;
- le rejeu à fenêtre glissante bornée pour le prefill ;
- l'ordonnancement asynchrone ;
- l'inférence invariante par batch et l'échantillonnage déterministe ;
- les sorties structurées : regex, schéma JSON et grammaire.
Plusieurs de ces fonctionnalités sont réservées à NVIDIA.
Ce qui n'est pas inclus#
Cette version fournit uniquement l'inférence hors ligne. Le README indique qu'un service d'inférence complet nécessite aussi un système de cache KV, la désagrégation prefill/decode et l'équilibrage de charge, et que ces éléments ne font pas partie de la version publiée. Vous obtenez donc le moteur, pas toute la pile de production. L'exposer derrière une API pour vos utilisateurs est un travail que vous ferez vous-même.
Matériel et installation#
Faites défiler le tableau vers la droite →
| Prérequis | Détails |
|---|---|
| Accélérateurs | GPU NVIDIA SM100 ou NPU Huawei Ascend 950 |
| OS | Linux |
| Compilateur | GCC 13+ |
| Python | 3.12 |
| Runtime | CUDA 13 (NVIDIA) ou CANN 9.2 (Ascend) |
Les benchmarks publiés (graphiques de Pareto pour le prefill et le decode) ont été mesurés sur 4 GPU SM100 pour le prefill et 64 pour le decode, chacun dans un seul domaine de scale-up. Les graphiques sont des images, nous ne citons donc pas de chiffres de débit ou de latence. Nous n'avons pas non plus de données indiquant si DeepInfer modifie le prix des API de qui que ce soit, nous ne faisons donc aucune affirmation à ce sujet.
Faut-il l'exécuter soi-même ?#
L'auto-hébergement a du sens si vous exploitez déjà du matériel SM100 ou Ascend 950, si vous avez besoin d'un contrôle total sur les poids et sur le comportement déterministe ou invariant par batch, ou si vous voulez construire votre propre couche de serving. La configuration des benchmarks (des dizaines de GPU pour le decode) montre à quoi le framework est optimisé : le serving à grande échelle.
Si vous avez simplement besoin de sorties de la famille DeepSeek dans votre application, le framework représente beaucoup d'infrastructure à assumer. Appeler une API est plus simple : pas de GPU, pas de versions CUDA ou CANN à faire correspondre.
Une option API pour le même type de tâche#
Si vous préférez ne pas exploiter votre propre cluster GPU, MiniMax-M2.7 sur CheapTokens gère les tâches de chat, de code et d'agent via une API, avec :
- un solde unique pour tous les modèles et une API compatible OpenAI et Anthropic ;
- jusqu'à 8 192 tokens de sortie par réponse et un contexte de 180K ;
- un prix fixe par modèle, sans heures de pointe ;
- moins cher qu'OpenRouter au total, entrée et sortie comptées ensemble.
Prix actuels pour 1M de tokens : entrée $0.05, sortie $0.15. Exemple de charge de travail avec 2 000 tokens d'entrée et 500 de sortie par requête, 1 000 requêtes :
| Modèle | Entrée $/1M | Sortie $/1M | Par requête | 1 000 requêtes | OpenRouter, 1 000 requêtes |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00006 | $0.06 | $0.121 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00008 | $0.08 | $0.173 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00018 | $0.175 | $1.20 |
2 000 tokens d'entrée et 500 tokens de sortie par requête. Les prix par million de tokens sont actuels et évoluent avec nos tarifs ; la colonne OpenRouter indique des prix de référence pour la même charge de travail.
Voir l'article DeepSeek-V4.1-Flash-1017 pour ce qui a changé dans le modèle lui-même.
En résumé#
DeepInfer est une véritable publication open source de code d'inférence de production, mais uniquement hors ligne et liée à un matériel spécifique (NVIDIA SM100 ou Ascend 950). Les équipes qui disposent de ce matériel et d'une équipe de serving y trouveront de l'intérêt. La plupart des développeurs continueront d'appeler une API et compareront les coûts pour leur propre mix de tokens.


