Balitang AIPagsusuri
Open-source na ng DeepSeek ang DeepInfer: ano ito at sino ang dapat mag-self-host
Inilabas ng DeepSeek ang DeepInfer sa ilalim ng Apache-2.0: inference code para sa V4.1-Flash. Ano ang kasama, anong hardware ang kailangan, at kailan mas simple ang API.
Sa pahinang ito
Noong 20 Oktubre 2026, inilathala ng DeepSeek ang DeepInfer sa GitHub (deepseek-) sa ilalim ng Apache License 2.0. Ito ang inference framework para sa mga modelo ng DeepSeek. Ayon sa README, pinapagana nito ang malakihang production services ng DeepSeek. Ang petsa ng release ay mula sa post ng @deepseek_ai na ipinadala ng isang Telegram digest; ang README mismo ay walang petsa.
Ano ang DeepInfer#
Ang DeepInfer ay code na nagpapatakbo ng modelo sa mga GPU o NPU nang mabilis. Hindi ito modelo at hindi hosted service. Ang tanging sinusuportahang modelo ay DeepSeek-V4.1-Flash. Bilang default, dina-download nito ang checkpoint deepseek- sa Hugging Face cache sa unang pagtakbo. Kung mayroon ka nang weights, itakda ang DEEPINFER_ upang gumamit ng lokal na kopya.
Ano ang nasa loob#
Inililista ng README ang mga feature na ito:
- mga na-optimize na kernel;
- data, context at expert parallelism na may load balancing;
- speculative decoding na may confidence-based verification;
- bounded sliding-window replay para sa prefill;
- asynchronous scheduling;
- batch-invariant inference at deterministic sampling;
- structured outputs: regex, JSON schema at grammar.
Ilang sa mga feature na ito ay para sa NVIDIA lamang.
Ano ang hindi kasama#
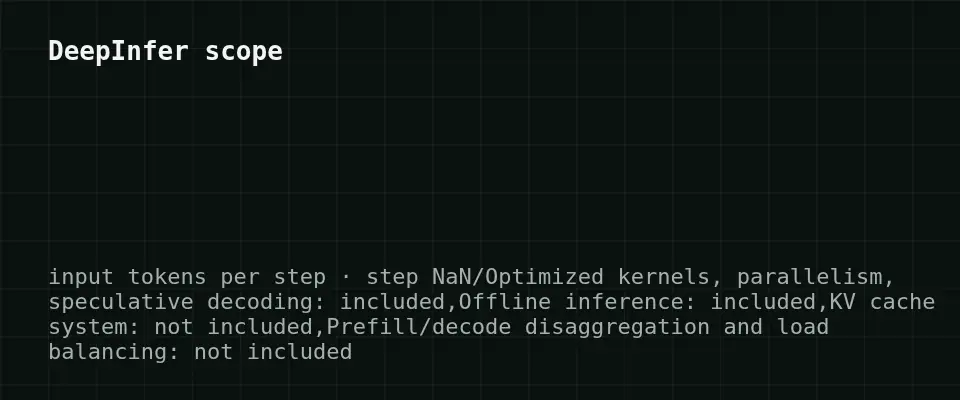
Ang release na ito ay nagbibigay ng offline inference lamang. Sinasabi ng README na ang isang buong inference service ay nangangailangan din ng KV cache system, prefill/decode disaggregation at load balancing, at ang mga ito ay hindi bahagi ng release. Kaya makukuha mo ang engine, hindi ang buong production stack. Ang paglalagay nito sa likod ng API para sa mga user ay trabahong ikaw mismo ang gagawa.
Hardware at setup#
I-scroll ang table pakanan →
| Kinakailangan | Detalye |
|---|---|
| Accelerators | NVIDIA SM100 GPUs o Huawei Ascend 950 NPUs |
| OS | Linux |
| Compiler | GCC 13+ |
| Python | 3.12 |
| Runtime | CUDA 13 (NVIDIA) o CANN 9.2 (Ascend) |
Ang mga na-publish na benchmark (prefill at decode Pareto charts) ay sinukat sa 4 na SM100 GPUs para sa prefill at 64 para sa decode, bawat isa sa loob ng isang scale-up domain. Ang mga chart ay mga imahe, kaya hindi kami nagsipi ng throughput o latency numbers. Wala rin kaming data kung binabago ng DeepInfer ang presyo ng API ng kahit sino, kaya wala kaming ganoong claim.
Dapat mo bang patakbuhin ito mismo?#
May saysay ang self-hosting kung nagpapatakbo ka na ng SM100 o Ascend 950 hardware, kailangan mo ng buong kontrol sa weights at sa deterministic o batch-invariant na pag-uugali, o gusto mong bumuo ng sarili mong serving layer. Ang benchmark setup (dosenang GPU para sa decode) ay nagpapakita kung para saan naka-tune ang framework: malakihang serving.
Kung kailangan mo lang ng output ng DeepSeek-family sa iyong app, ang framework ay napakaraming infrastructure na kailangang pasanin. Mas simple ang pagtawag sa API: walang GPU, walang CUDA o CANN versions na itatugma.
Isang API option para sa parehong uri ng gawain#
Kung ayaw mong magpatakbo ng sarili mong GPU cluster, ang MiniMax-M2.7 sa CheapTokens ay humahawak ng chat, coding at agent tasks sa pamamagitan ng API, na may:
- isang balanse para sa lahat ng modelo at isang API na compatible sa OpenAI at Anthropic;
- hanggang 8,192 output tokens bawat sagot at 180K context;
- fixed na presyo bawat modelo na walang peak hours;
- mas mura kaysa OpenRouter sa kabuuan, kung pagsasamahin ang input at output.
Kasalukuyang presyo bawat 1M tokens: input $0.05, output $0.15. Halimbawang workload na 2,000 input at 500 output tokens bawat request, 1,000 requests:
| Modelo | Input $/1M | Output $/1M | Bawat kahilingan | 1,000 mga kahilingan | OpenRouter, 1,000 mga kahilingan |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00006 | $0.06 | $0.121 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00008 | $0.08 | $0.173 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00018 | $0.175 | $1.20 |
2,000 input at 500 output na token bawat kahilingan. Ang mga presyo kada 1M token ay kasalukuyan at nagbabago kasabay ng aming mga taripa; ang column ng OpenRouter ay nagpapakita ng reference na presyo para sa parehong workload.
Tingnan ang artikulo ng DeepSeek-V4.1-Flash-1017 para sa kung ano ang nagbago sa modelo mismo.
Bottom line#
Ang DeepInfer ay isang tunay na open release ng production inference code, ngunit offline lamang at nakatali sa partikular na hardware (NVIDIA SM100 o Ascend 950). Ang mga team na may ganoong hardware at serving team ay makakahanap nito ng kawili-wili. Karamihan ng developer ay patuloy na tatawag ng API at ihahambing ang gastos para sa kanilang sariling token mix.


