Novità AIAnalisi
DeepSeek rende open source DeepInfer: cos'è e chi dovrebbe fare self-hosting
DeepSeek ha rilasciato DeepInfer con licenza Apache-2.0: codice di inferenza per V4.1-Flash. Cosa è incluso, quale hardware richiede e quando un'API è la scelta più semplice.
In questa pagina
Il 20 ottobre 2026 DeepSeek ha pubblicato DeepInfer su GitHub (deepseek-) con licenza Apache License 2.0. È il framework di inferenza per i modelli DeepSeek. Secondo il README, alimenta i servizi di produzione su larga scala di DeepSeek. La data di rilascio proviene dal post di @deepseek_ai, ripreso da un digest su Telegram; il README stesso non riporta alcuna data.
Cos'è DeepInfer#
DeepInfer è codice che esegue un modello su GPU o NPU in modo veloce. Non è un modello e non è un servizio ospitato. L'unico modello supportato è DeepSeek-V4.1-Flash. Per impostazione predefinita, al primo avvio scarica il checkpoint deepseek- nella cache di Hugging Face. Se disponi già dei pesi, imposta DEEPINFER_ per usare una copia locale.
Cosa è incluso#
Il README elenca queste funzionalità:
- kernel ottimizzati;
- parallelismo dei dati, del contesto e degli esperti con load balancing;
- decodifica speculativa con verifica basata sulla confidenza;
- replay a finestra scorrevole con limite per il prefill;
- scheduling asincrono;
- inferenza batch-invariant e campionamento deterministico;
- output strutturati: regex, JSON schema e grammatica.
Diverse di queste funzionalità sono solo per NVIDIA.
Cosa non è incluso#
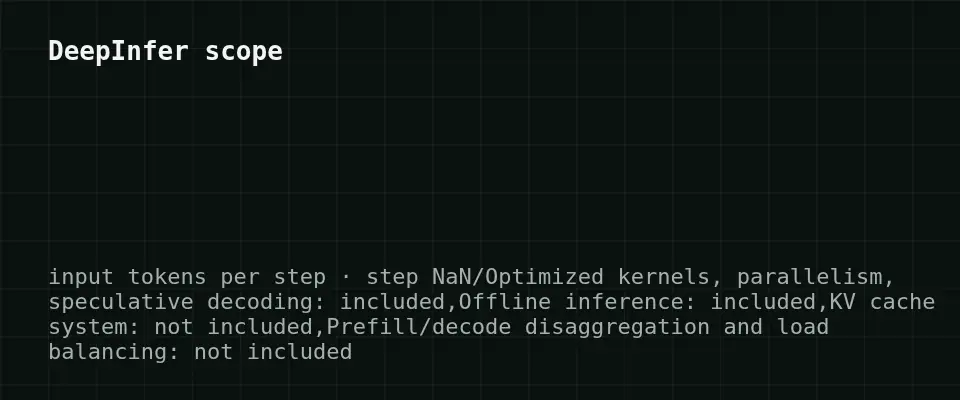
Questa release fornisce solo inferenza offline. Il README afferma che un servizio di inferenza completo richiede anche un sistema di KV cache, la disaggregazione prefill/decode e il load balancing, e questi non fanno parte della release. Quindi ottieni il motore, non l'intero stack di produzione. Esporlo tramite un'API per gli utenti è un lavoro che dovresti fare da solo.
Hardware e configurazione#
Scorri la tabella verso destra →
| Requisito | Dettagli |
|---|---|
| Acceleratori | GPU NVIDIA SM100 o NPU Huawei Ascend 950 |
| Sistema operativo | Linux |
| Compilatore | GCC 13+ |
| Python | 3.12 |
| Runtime | CUDA 13 (NVIDIA) o CANN 9.2 (Ascend) |
I benchmark pubblicati (grafici Pareto di prefill e decode) sono stati misurati su 4 GPU SM100 per il prefill e 64 per il decode, ciascuno all'interno di un singolo dominio scale-up. I grafici sono immagini, quindi non riportiamo numeri di throughput o latenza. Non abbiamo nemmeno dati su se DeepInfer cambi il prezzo delle API di qualcuno, quindi non facciamo alcuna affermazione in merito.
Dovresti eseguirlo da solo?#
Il self-hosting ha senso se gestisci già hardware SM100 o Ascend 950, se hai bisogno del pieno controllo sui pesi e del comportamento deterministico o batch-invariant, oppure se vuoi costruire il tuo livello di serving. La configurazione dei benchmark (decine di GPU per il decode) mostra per cosa è ottimizzato il framework: il serving su larga scala.
Se ti serve solo l'output della famiglia DeepSeek nella tua app, il framework è molta infrastruttura da gestire. Chiamare un'API è più semplice: niente GPU, niente versioni di CUDA o CANN da far combaciare.
Un'opzione API per lo stesso tipo di attività#
Se preferisci non gestire un tuo cluster di GPU, MiniMax-M2.7 su CheapTokens gestisce attività di chat, coding e agent tramite un'API, con:
- un unico saldo per tutti i modelli e un'API compatibile con OpenAI e Anthropic;
- fino a 8.192 token di output per risposta e una finestra di contesto da 180K;
- un prezzo fisso per modello senza ore di punta;
- più economico di OpenRouter in totale, con input e output conteggiati insieme.
Prezzi attuali per 1M di token: input $0.05, output $0.15. Un carico di esempio di 2.000 token di input e 500 di output per richiesta, 1.000 richieste:
| Modello | Input $/1M | Output $/1M | Per richiesta | 1000 richieste | OpenRouter, 1000 richieste |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00006 | $0.06 | $0.121 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00008 | $0.08 | $0.173 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00018 | $0.175 | $1.20 |
2000 token di input e 500 token di output per richiesta. I prezzi per 1M di token sono attuali e cambiano insieme alle nostre tariffe; la colonna OpenRouter mostra i prezzi di riferimento per lo stesso carico di lavoro.
Vedi l'articolo su DeepSeek-V4.1-Flash-1017 per cosa è cambiato nel modello stesso.
In conclusione#
DeepInfer è un vero rilascio open di codice di inferenza di produzione, ma solo offline e legato a hardware specifico (NVIDIA SM100 o Ascend 950). I team con quell'hardware e un team di serving lo troveranno interessante. La maggior parte degli sviluppatori continuerà a chiamare un'API e a confrontare i costi per il proprio mix di token.


