AI 新闻深度解析
DeepSeek 开源 DeepInfer:它是什么以及谁应该自托管
DeepSeek 以 Apache-2.0 发布 DeepInfer:V4.1-Flash 的推理代码。包含什么、需要什么硬件,以及何时 API 是更简单的选择。
2026 年 10 月 20 日,DeepSeek 在 GitHub(deepseek-)上以 Apache License 2.0 发布了 DeepInfer。它是 DeepSeek 模型的推理框架。根据 README,它支撑着 DeepSeek 的大规模生产服务。发布日期来自 @deepseek_ai 的帖子,经 Telegram 摘要转发;README 本身没有日期。
DeepInfer 是什么#
DeepInfer 是在 GPU 或 NPU 上快速运行模型的代码。它不是模型,也不是托管服务。唯一支持的模型是 DeepSeek-V4.1-Flash。默认情况下,首次运行时它会将检查点 deepseek- 下载到 Hugging Face 缓存中。如果你已有权重,请设置 DEEPINFER_ 以使用本地副本。
包含哪些内容#
README 列出了以下特性:
- 优化的内核;
- 带负载均衡的数据、上下文和专家并行;
- 基于置信度验证的推测解码;
- 用于 prefill 的有界滑动窗口重放;
- 异步调度;
- 批次不变推理和确定性采样;
- 结构化输出:正则表达式、JSON schema 和语法。
其中若干特性仅支持 NVIDIA。
不包含哪些内容#
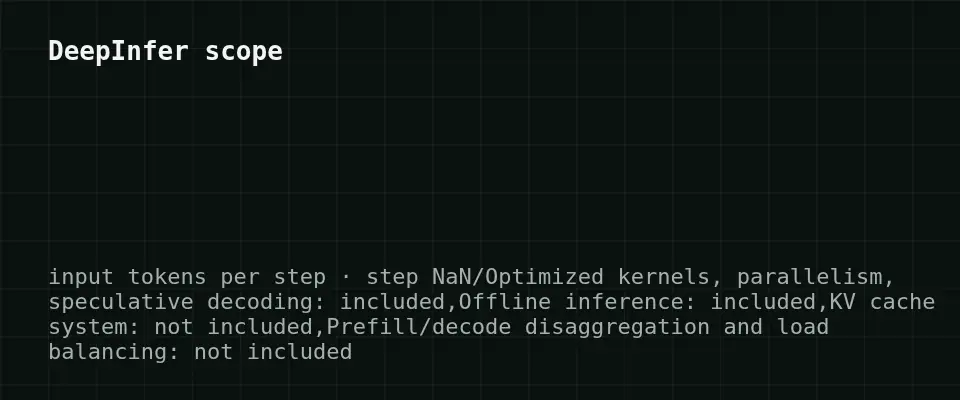
此版本仅提供离线推理。README 指出,完整的推理服务还需要 KV 缓存系统、prefill/decode 分离和负载均衡,而这些不在发布范围内。因此你得到的是引擎,而不是完整的生产栈。将其置于 API 之后供用户使用,需要你自己完成。
硬件与设置#
向右滚动表格 →
| 要求 | 详情 |
|---|---|
| 加速器 | NVIDIA SM100 GPU 或华为昇腾 950 NPU |
| 操作系统 | Linux |
| 编译器 | GCC 13+ |
| Python | 3.12 |
| 运行时 | CUDA 13(NVIDIA)或 CANN 9.2(昇腾) |
已发布的基准测试(prefill 和 decode 帕累托图)在 4 块 SM100 GPU 上测量 prefill,在 64 块上测量 decode,均在一个 scale-up 域内。图表是图片,因此我们不引用吞吐量或延迟数字。我们也没有关于 DeepInfer 是否改变任何人 API 价格的数据,因此不作此类声明。
你应该自己运行吗?#
如果你已经运营 SM100 或昇腾 950 硬件,需要对权重以及确定性或批次不变行为进行完全控制,或者想构建自己的服务层,那么自托管是合理的。基准测试设置(decode 需要数十块 GPU)显示了该框架的调优目标:大规模服务。
如果你只是需要在应用中获得 DeepSeek 系列输出,那么这个框架需要承担大量基础设施。调用 API 更简单:无需 GPU,无需匹配 CUDA 或 CANN 版本。
同类任务的 API 选项#
如果你不想运行自己的 GPU 集群,CheapTokens 上的 MiniMax-M2.7 可通过 API 处理聊天、编码和代理任务,具有:
- 所有模型共用一个余额,以及兼容 OpenAI 和 Anthropic 的 API;
- 每次回答最多 8,192 个输出 token,上下文 180K;
- 每个模型固定价格,无高峰时段;
- 总成本低于 OpenRouter,输入和输出合并计算。
当前每 1M token 价格:输入 $0.05,输出 $0.15。示例工作负载:每次请求 2,000 个输入和 500 个输出 token,共 1,000 次请求:
| 模型 | 输入 $/1M | 输出 $/1M | 每次请求 | 1,000 次请求 | OpenRouter,1,000 次请求 |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00006 | $0.06 | $0.121 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00008 | $0.08 | $0.173 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00018 | $0.175 | $1.20 |
每次请求 2,000 个输入 token 和 500 个输出 token。每 100 万 token 的价格为当前价格,会随我们的资费一同变动;OpenRouter 列显示相同工作负载的参考价格。
模型本身的变化请参阅 DeepSeek-V4.1-Flash-1017 文章。
总结#
DeepInfer 是生产推理代码的真正开源发布,但仅限离线,且绑定特定硬件(NVIDIA SM100 或昇腾 950)。拥有该硬件和服务团队的团队会觉得它有趣。大多数开发者会继续调用 API,并根据自己的 token 组合比较成本。


