ข่าว AIการวิเคราะห์เจาะลึก
DeepSeek เปิดโอเพนซอร์ส DeepInfer: มันคืออะไรและใครควรโฮสต์เอง
DeepSeek เผยแพร่ DeepInfer ภายใต้ Apache-2.0: โค้ด inference สำหรับ V4.1-Flash อะไรที่รวมอยู่ ต้องใช้ฮาร์ดแวร์อะไร และเมื่อใดที่ API เป็นทางเลือกที่ง่ายกว่า
ในหน้านี้
เมื่อวันที่ 20 ตุลาคม 2026 DeepSeek ได้เผยแพร่ DeepInfer บน GitHub (deepseek-) ภายใต้ Apache License 2.0 เป็นเฟรมเวิร์กสำหรับการอนุมาน (inference) ของโมเดล DeepSeek ตาม README ระบุว่ามันขับเคลื่อนบริการระดับโปรดักชันขนาดใหญ่ของ DeepSeek วันที่เผยแพร่มาจากโพสต์ของ @deepseek_ai ที่ส่งต่อผ่าน Telegram digest ส่วนตัว README เองไม่มีวันที่ระบุ
DeepInfer คืออะไร#
DeepInfer คือโค้ดที่รันโมเดลบน GPU หรือ NPU ได้อย่างรวดเร็ว ไม่ใช่โมเดลและไม่ใช่บริการโฮสต์ โมเดลเดียวที่รองรับคือ DeepSeek-V4.1-Flash โดยค่าเริ่มต้นจะดาวน์โหลด checkpoint deepseek- ไปยังแคช Hugging Face ในการรันครั้งแรก หากคุณมี weights อยู่แล้ว ให้ตั้งค่า DEEPINFER_ เพื่อใช้สำเนาในเครื่อง
สิ่งที่มาพร้อมในแพ็กเกจ#
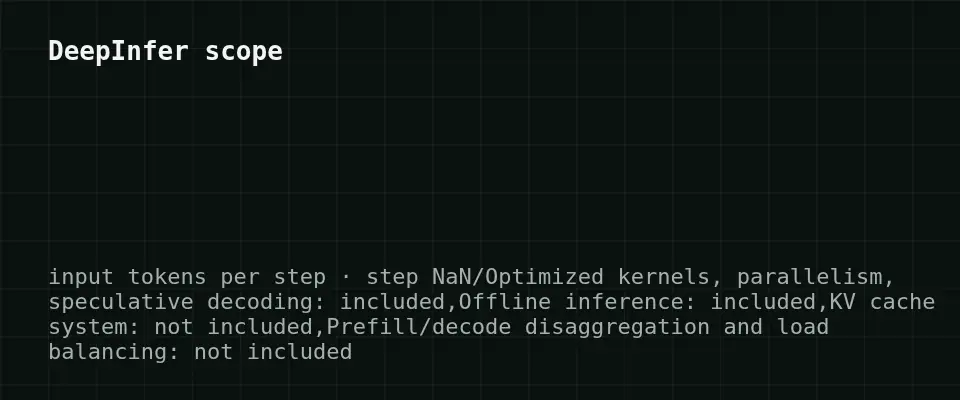
README ระบุฟีเจอร์เหล่านี้:
- เคอร์เนลที่ปรับแต่งแล้ว;
- data, context และ expert parallelism พร้อม load balancing;
- speculative decoding พร้อมการตรวจสอบตามความเชื่อมั่น;
- bounded sliding-window replay สำหรับ prefill;
- การจัดตารางแบบอะซิงโครนัส;
- batch-invariant inference และ deterministic sampling;
- structured outputs: regex, JSON schema และ grammar
หลายฟีเจอร์เหล่านี้รองรับเฉพาะ NVIDIA
สิ่งที่ไม่รวมอยู่#
รีลีสนี้ให้ offline inference เท่านั้น README ระบุว่าบริการ inference แบบเต็มยังต้องมีระบบ KV cache, prefill/decode disaggregation และ load balancing ซึ่งไม่รวมอยู่ในรีลีสนี้ ดังนั้นคุณจะได้เพียงเอนจิน ไม่ใช่สแตกโปรดักชันทั้งหมด การนำไปวางหลัง API สำหรับผู้ใช้เป็นงานที่คุณต้องทำเอง
ฮาร์ดแวร์และการตั้งค่า#
เลื่อนตารางไปทางขวา →
| ข้อกำหนด | รายละเอียด |
|---|---|
| ตัวเร่งความเร็ว | NVIDIA SM100 GPUs หรือ Huawei Ascend 950 NPUs |
| ระบบปฏิบัติการ | Linux |
| คอมไพเลอร์ | GCC 13+ |
| Python | 3.12 |
| รันไทม์ | CUDA 13 (NVIDIA) หรือ CANN 9.2 (Ascend) |
เบนช์มาร์กที่เผยแพร่ (กราฟ Pareto ของ prefill และ decode) วัดบน SM100 GPU จำนวน 4 ตัวสำหรับ prefill และ 64 ตัวสำหรับ decode โดยแต่ละชุดอยู่ใน scale-up domain เดียวกัน กราฟเป็นรูปภาพ所以我们ไม่ยกตัวเลข throughput หรือ latency มาแสดง นอกจากนี้เราไม่มีข้อมูลว่า DeepInfer เปลี่ยนราคา API ของใครหรือไม่ ดังนั้นเราจึงไม่กล่าวอ้างเช่นนั้น
คุณควรรันมันเองหรือไม่?#
การโฮสต์เองสมเหตุสมผลหากคุณมีฮาร์ดแวร์ SM100 หรือ Ascend 950 อยู่แล้ว ต้องการควบคุม weights อย่างเต็มที่ และต้องการพฤติกรรมแบบ deterministic หรือ batch-invariant หรือต้องการสร้างเลเยอร์การให้บริการของคุณเอง การตั้งค่าเบนช์มาร์ก (GPU หลายสิบตัวสำหรับ decode) แสดงให้เห็นว่าเฟรมเวิร์กนี้ปรับแต่งมาสำหรับอะไร: การให้บริการขนาดใหญ่
หากคุณเพียงต้องการผลลัพธ์ตระกูล DeepSeek ในแอปของคุณ เฟรมเวิร์กนี้เป็นโครงสร้างพื้นฐานที่ต้องรับภาระมาก การเรียก API นั้นง่ายกว่า: ไม่ต้องมี GPU ไม่ต้องจับคู่เวอร์ชัน CUDA หรือ CANN
ทางเลือก API สำหรับงานประเภทเดียวกัน#
หากคุณไม่อยากรันคลัสเตอร์ GPU ของตัวเอง MiniMax-M2.7 บน CheapTokens รองรับงานแชท การเขียนโค้ด และงานเอเจนต์ผ่าน API โดยมี:
- ยอดคงเหลือเดียวสำหรับทุกโมเดล และ API ที่เข้ากันได้กับ OpenAI และ Anthropic;
- เอาต์พุตสูงสุด 8,192 โทเคนต่อคำตอบ และบริบท 180K;
- ราคาคงที่ต่อโมเดล ไม่มีช่วงพีค;
- ถูกกว่า OpenRouter โดยรวม เมื่อนับอินพุตและเอาต์พุตรวมกัน
ราคาปัจจุบันต่อ 1M โทเคน: อินพุต $0.05, เอาต์พุต $0.15 ตัวอย่างปริมาณงาน 2,000 โทเคนอินพุตและ 500 โทเคนเอาต์พุตต่อคำขอ จำนวน 1,000 คำขอ:
| โมเดล | Input $/1M | Output $/1M | ต่อคำขอ | 1,000 คำขอ | OpenRouter, 1,000 คำขอ |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00006 | $0.06 | $0.121 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00008 | $0.08 | $0.173 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00018 | $0.175 | $1.20 |
2,000 โทเค็นอินพุตและ 500 โทเค็นเอาต์พุตต่อคำขอ ราคาต่อ 1M โทเค็นเป็นราคาปัจจุบันและเปลี่ยนแปลงไปพร้อมกับอัตราค่าบริการของเรา คอลัมน์ OpenRouter แสดงราคาอ้างอิงสำหรับปริมาณงานเดียวกัน
ดูบทความ DeepSeek-V4.1-Flash-1017 สำหรับสิ่งที่เปลี่ยนแปลงในตัวโมเดล
สรุป#
DeepInfer เป็นรีลีสโอเพนซอร์สจริงของโค้ด inference ระดับโปรดักชัน แต่รองรับเฉพาะ offline และผูกกับฮาร์ดแวร์เฉพาะ (NVIDIA SM100 หรือ Ascend 950) ทีมที่มีฮาร์ดแวร์นั้นและมีทีมให้บริการจะพบว่ามันน่าสนใจ นักพัฒนาส่วนใหญ่จะยังคงเรียก API และเปรียบเทียบต้นทุนตามสัดส่วนโทเคนของตนเอง


