AI 뉴스분석
DeepSeek, DeepInfer 오픈소스 공개: 무엇이며 누가 자체 호스팅해야 할까
DeepSeek가 Apache-2.0으로 DeepInfer를 공개했습니다: V4.1-Flash용 추론 코드. 포함된 내용, 필요한 하드웨어, 그리고 API가 더 간단한 선택인 경우.
2026년 10월 20일 DeepSeek는 Apache License 2.0에 따라 GitHub(deepseek-)에 DeepInfer를 공개했습니다. 이는 DeepSeek 모델용 추론 프레임워크입니다. README에 따르면 DeepSeek의 대규모 프로덕션 서비스를 구동합니다. 공개 날짜는 Telegram 다이제스트를 통해 전달된 @deepseek_ai 게시물에서 가져왔으며, README 자체에는 날짜가 없습니다.
DeepInfer란 무엇인가#
DeepInfer는 GPU 또는 NPU에서 모델을 빠르게 실행하는 코드입니다. 모델도 아니고 호스팅 서비스도 아닙니다. 지원되는 유일한 모델은 DeepSeek-V4.1-Flash입니다. 기본적으로 첫 실행 시 체크포인트 deepseek-를 Hugging Face 캐시로 다운로드합니다. 이미 가중치가 있다면 DEEPINFER_를 설정하여 로컬 복사본을 사용하세요.
포함된 기능#
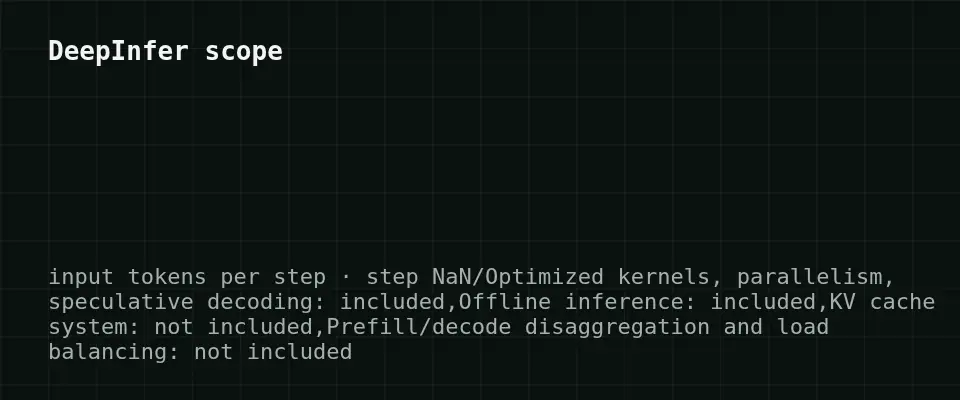
README에는 다음 기능이 나열되어 있습니다:
- 최적화된 커널;
- 로드 밸런싱을 갖춘 데이터, 컨텍스트 및 전문가 병렬 처리;
- 신뢰도 기반 검증을 갖춘 추측 디코딩;
- prefill을 위한 제한된 슬라이딩 윈도우 재생;
- 비동기 스케줄링;
- 배치 불변 추론 및 결정적 샘플링;
- 구조화된 출력: 정규식, JSON 스키마 및 문법.
이 중 여러 기능은 NVIDIA 전용입니다.
포함되지 않은 것#
이 릴리스는 오프라인 추론만 제공합니다. README에 따르면 완전한 추론 서비스에는 KV 캐시 시스템, prefill/decode 분리 및 로드 밸런싱도 필요하며, 이들은 릴리스에 포함되지 않습니다. 따라서 엔진은 얻지만 전체 프로덕션 스택은 얻지 못합니다. 사용자를 위해 API 뒤에 두는 것은 직접 해야 할 작업입니다.
하드웨어 및 설정#
표를 오른쪽으로 스크롤하세요 →
| 요구 사항 | 세부 정보 |
|---|---|
| 가속기 | NVIDIA SM100 GPU 또는 Huawei Ascend 950 NPU |
| OS | Linux |
| 컴파일러 | GCC 13+ |
| Python | 3.12 |
| 런타임 | CUDA 13 (NVIDIA) 또는 CANN 9.2 (Ascend) |
공개된 벤치마크(prefill 및 decode 파레토 차트)는 prefill의 경우 4개의 SM100 GPU, decode의 경우 64개에서 측정되었으며, 각각 하나의 scale-up 도메인 내에서 이루어졌습니다. 차트는 이미지이므로 처리량이나 지연 시간 수치를 인용하지 않습니다. 또한 DeepInfer가 누군가의 API 가격을 바꾸는지에 대한 데이터도 없으므로 그런 주장은 하지 않습니다.
직접 실행해야 할까?#
이미 SM100 또는 Ascend 950 하드웨어를 운영 중이거나, 가중치와 결정적 또는 배치 불변 동작에 대한 완전한 제어가 필요하거나, 자체 서빙 계층을 구축하려는 경우 자체 호스팅이 합리적입니다. 벤치마크 설정(decode에 수십 개의 GPU)은 이 프레임워크가 무엇에 맞춰 조정되었는지 보여줍니다: 대규모 서빙입니다.
앱에서 DeepSeek 계열 출력만 필요하다면, 이 프레임워크는 감당해야 할 인프라가 많습니다. API를 호출하는 것이 더 간단합니다: GPU도, 맞춰야 할 CUDA 또는 CANN 버전도 없습니다.
같은 종류의 작업을 위한 API 옵션#
자체 GPU 클러스터를 실행하고 싶지 않다면 CheapTokens의 MiniMax-M2.7이 API를 통해 채팅, 코딩 및 에이전트 작업을 처리하며, 다음을 제공합니다:
- 모든 모델에 대한 단일 잔액과 OpenAI 및 Anthropic 호환 API;
- 답변당 최대 8,192 출력 토큰과 180K 컨텍스트;
- 피크 시간 없는 모델별 고정 가격;
- 입력과 출력을 합산하여 OpenRouter보다 총 비용이 저렴합니다.
1M 토큰당 현재 가격: 입력 $0.05, 출력 $0.15. 요청당 입력 2,000 및 출력 500 토큰, 1,000건 요청의 예시 워크로드:
| 모델 | 입력 $/1M | 출력 $/1M | 요청당 | 1,000회 요청 | OpenRouter, 1,000회 요청 |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00006 | $0.06 | $0.121 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00008 | $0.08 | $0.173 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00018 | $0.175 | $1.20 |
요청당 입력 2,000개 및 출력 500개 토큰입니다. 100만 토큰당 가격은 현재 기준이며 당사 요금제에 따라 함께 변경됩니다. OpenRouter 열은 동일한 작업량에 대한 참고 가격을 보여줍니다.
모델 자체에서 무엇이 바뀌었는지는 DeepSeek-V4.1-Flash-1017 문서를 참조하세요.
결론#
DeepInfer는 프로덕션 추론 코드의 실제 오픈 릴리스이지만, 오프라인 전용이며 특정 하드웨어(NVIDIA SM100 또는 Ascend 950)에 묶여 있습니다. 해당 하드웨어와 서빙 팀을 갖춘 팀에게는 흥미로울 것입니다. 대부분의 개발자는 계속 API를 호출하고 자신의 토큰 구성에 맞춰 비용을 비교할 것입니다.


