KI-NewsAnalyse
DeepSeek veröffentlicht DeepInfer als Open Source: Was es ist und wer selbst hosten sollte
DeepSeek hat DeepInfer unter Apache-2.0 veröffentlicht: Inferenzcode für V4.1-Flash. Was enthalten ist, welche Hardware nötig ist und wann eine API die einfachere Wahl ist.
Auf dieser Seite
Am 20. Oktober 2026 hat DeepSeek DeepInfer auf GitHub (deepseek-) unter der Apache License 2.0 veröffentlicht. Es ist das Inferenz-Framework für DeepSeek-Modelle. Laut README betreibt es die großskaligen Produktionsdienste von DeepSeek. Das Veröffentlichungsdatum stammt aus dem @deepseek_ai-Post, wie er in einem Telegram-Digest weitergegeben wurde; das README selbst enthält kein Datum.
Was DeepInfer ist#
DeepInfer ist Code, der ein Modell schnell auf GPUs oder NPUs ausführt. Es ist kein Modell und kein gehosteter Dienst. Das einzige unterstützte Modell ist DeepSeek-V4.1-Flash. Standardmäßig lädt es beim ersten Lauf den Checkpoint deepseek- in den Hugging-Face-Cache herunter. Wenn du die Gewichte bereits hast, setze DEEPINFER_, um eine lokale Kopie zu verwenden.
Was enthalten ist#
Das README listet diese Funktionen auf:
- optimierte Kernel;
- Daten-, Kontext- und Experten-Parallelität mit Load Balancing;
- spekulative Dekodierung mit konfidenzbasierter Verifikation;
- begrenztes Sliding-Window-Replay für Prefill;
- asynchrone Planung;
- batch-invariante Inferenz und deterministisches Sampling;
- strukturierte Ausgaben: Regex, JSON-Schema und Grammatik.
Mehrere dieser Funktionen sind nur für NVIDIA verfügbar.
Was nicht enthalten ist#
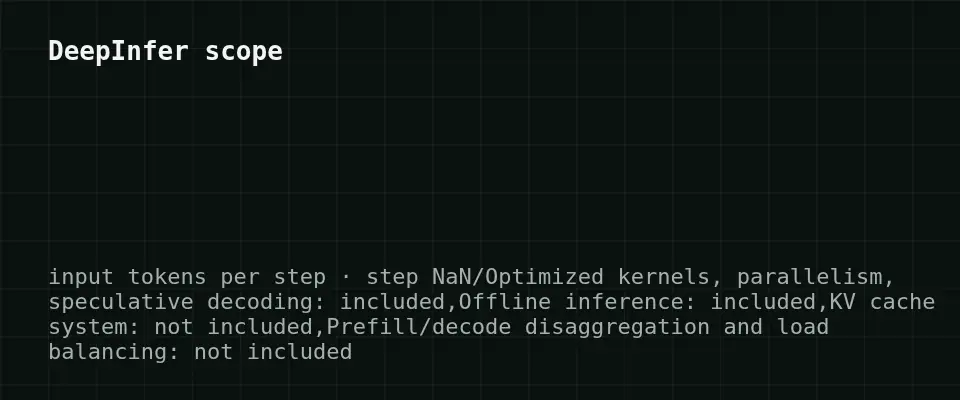
Dieses Release bietet nur Offline-Inferenz. Laut README benötigt ein vollständiger Inferenzdienst zusätzlich ein KV-Cache-System, Prefill/Decode-Disaggregation und Load Balancing, und diese sind nicht Teil des Releases. Du bekommst also die Engine, nicht den kompletten Produktions-Stack. Sie hinter einer API für Nutzer bereitzustellen, ist Arbeit, die du selbst erledigen müsstest.
Hardware und Setup#
Tabelle nach rechts scrollen →
| Anforderung | Details |
|---|---|
| Beschleuniger | NVIDIA-SM100-GPUs oder Huawei-Ascend-950-NPUs |
| Betriebssystem | Linux |
| Compiler | GCC 13+ |
| Python | 3.12 |
| Laufzeit | CUDA 13 (NVIDIA) oder CANN 9.2 (Ascend) |
Die veröffentlichten Benchmarks (Pareto-Diagramme für Prefill und Decode) wurden auf 4 SM100-GPUs für Prefill und 64 für Decode gemessen, jeweils innerhalb einer Scale-up-Domain. Die Diagramme sind Bilder, daher zitieren wir keine Durchsatz- oder Latenzzahlen. Wir haben auch keine Daten dazu, ob DeepInfer den API-Preis irgendjemandes verändert, daher stellen wir keine solche Behauptung auf.
Solltest du es selbst betreiben?#
Self-Hosting ist sinnvoll, wenn du bereits SM100- oder Ascend-950-Hardware betreibst, volle Kontrolle über die Gewichte und das deterministische oder batch-invariante Verhalten benötigst oder deine eigene Serving-Schicht bauen möchtest. Das Benchmark-Setup (Dutzende GPUs für Decode) zeigt, worauf das Framework ausgelegt ist: großskaliges Serving.
Wenn du nur Ausgaben aus der DeepSeek-Familie in deiner App brauchst, ist das Framework eine Menge Infrastruktur, die du übernehmen müsstest. Eine API aufzurufen ist einfacher: keine GPUs, keine CUDA- oder CANN-Versionen, die zueinander passen müssen.
Eine API-Option für dieselbe Art von Aufgabe#
Wenn du lieber keinen eigenen GPU-Cluster betreiben möchtest, übernimmt MiniMax-M2.7 auf CheapTokens Chat-, Coding- und Agent-Aufgaben über eine API, mit:
- einem Guthaben für alle Modelle und einer OpenAI- und Anthropic-kompatiblen API;
- bis zu 8.192 Ausgabe-Tokens pro Antwort und einem 180K-Kontext;
- einem festen Preis pro Modell ohne Peak-Zeiten;
- insgesamt günstiger als OpenRouter, wobei Input und Output zusammen gezählt werden.
Aktuelle Preise pro 1M Tokens: Input $0.05, Output $0.15. Eine Beispiel-Workload mit 2.000 Input- und 500 Output-Tokens pro Anfrage, 1.000 Anfragen:
| Modell | Input $/1M | Output $/1M | Pro Anfrage | 1.000 Anfragen | OpenRouter, 1.000 Anfragen |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00006 | $0.06 | $0.121 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00008 | $0.08 | $0.173 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00018 | $0.175 | $1.20 |
2.000 Input- und 500 Output-Tokens pro Anfrage. Die Preise pro 1 Mio. Tokens sind aktuell und ändern sich zusammen mit unseren Tarifen; die OpenRouter-Spalte zeigt Referenzpreise für dieselbe Arbeitslast.
Siehe den DeepSeek-V4.1-Flash-1017-Artikel für das, was sich am Modell selbst geändert hat.
Fazit#
DeepInfer ist ein echtes Open-Release von Produktions-Inferenzcode, aber nur offline und an spezifische Hardware gebunden (NVIDIA SM100 oder Ascend 950). Teams mit dieser Hardware und einem Serving-Team werden es interessant finden. Die meisten Entwickler werden weiterhin eine API aufrufen und die Kosten für ihren eigenen Token-Mix vergleichen.


