Notícias de IAAnálise
DeepSeek abre o código do DeepInfer: o que é e quem deve auto-hospedar
A DeepSeek lançou o DeepInfer sob Apache-2.0: código de inferência para o V4.1-Flash. O que está incluído, qual hardware ele exige e quando uma API é a escolha mais simples.
Nesta página
Em 20 de outubro de 2026, a DeepSeek publicou o DeepInfer no GitHub (deepseek-) sob a Licença Apache 2.0. É o framework de inferência para os modelos DeepSeek. Segundo o README, ele sustenta os serviços de produção em larga escala da DeepSeek. A data de lançamento vem do post do @deepseek_ai, repassado por um resumo do Telegram; o próprio README não tem data.
O que é o DeepInfer#
O DeepInfer é código que executa um modelo em GPUs ou NPUs com rapidez. Não é um modelo nem um serviço hospedado. O único modelo suportado é o DeepSeek-V4.1-Flash. Por padrão, ele baixa o checkpoint deepseek- para o cache do Hugging Face na primeira execução. Se você já tem os pesos, defina DEEPINFER_ para usar uma cópia local.
O que vem incluído#
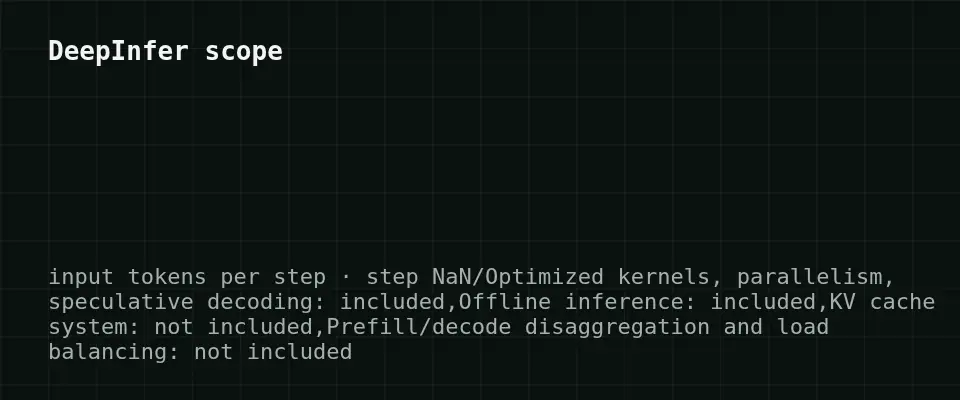
O README lista estes recursos:
- kernels otimizados;
- paralelismo de dados, contexto e especialistas com balanceamento de carga;
- decodificação especulativa com verificação baseada em confiança;
- replay de janela deslizante limitada para prefill;
- agendamento assíncrono;
- inferência invariante a lote e amostragem determinística;
- saídas estruturadas: regex, JSON schema e gramática.
Vários desses recursos são exclusivos para NVIDIA.
O que não está incluído#
Esta versão oferece apenas inferência offline. O README diz que um serviço de inferência completo também precisa de um sistema de KV cache, desagregação de prefill/decode e balanceamento de carga, e esses itens não fazem parte da versão. Ou seja, você recebe o motor, não toda a stack de produção. Colocá-lo atrás de uma API para usuários é trabalho que você mesmo faria.
Hardware e configuração#
Role a tabela para a direita →
| Requisito | Detalhes |
|---|---|
| Aceleradores | GPUs NVIDIA SM100 ou NPUs Huawei Ascend 950 |
| SO | Linux |
| Compilador | GCC 13+ |
| Python | 3.12 |
| Runtime | CUDA 13 (NVIDIA) ou CANN 9.2 (Ascend) |
Os benchmarks publicados (gráficos de Pareto de prefill e decode) foram medidos em 4 GPUs SM100 para prefill e 64 para decode, cada um dentro de um único domínio de scale-up. Os gráficos são imagens, então não citamos números de throughput ou latência. Também não temos dados sobre se o DeepInfer muda o preço da API de alguém, então não fazemos essa afirmação.
Você deve executá-lo por conta própria?#
A auto-hospedagem faz sentido se você já opera hardware SM100 ou Ascend 950, precisa de controle total sobre os pesos e sobre o comportamento determinístico ou invariante a lote, ou quer construir sua própria camada de serving. A configuração do benchmark (dezenas de GPUs para decode) mostra para o que o framework é ajustado: serving em larga escala.
Se você só precisa de saída da família DeepSeek no seu app, o framework é muita infraestrutura para assumir. Chamar uma API é mais simples: sem GPUs, sem versões de CUDA ou CANN para combinar.
Uma opção de API para o mesmo tipo de tarefa#
Se você prefere não rodar seu próprio cluster de GPUs, o MiniMax-M2.7 na CheapTokens lida com tarefas de chat, programação e agentes via API, com:
- um saldo para todos os modelos e uma API compatível com OpenAI e Anthropic;
- até 8.192 tokens de saída por resposta e contexto de 180K;
- preço fixo por modelo, sem horários de pico;
- mais barato que o OpenRouter no total, com entrada e saída contabilizadas juntas.
Preços atuais por 1M de tokens: entrada $0.05, saída $0.15. Exemplo de carga de trabalho com 2.000 tokens de entrada e 500 de saída por requisição, 1.000 requisições:
| Modelo | Entrada $/1M | Saída $/1M | Por solicitação | 1.000 solicitações | OpenRouter, 1.000 solicitações |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00006 | $0.06 | $0.121 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00008 | $0.08 | $0.173 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00018 | $0.175 | $1.20 |
2.000 tokens de entrada e 500 tokens de saída por solicitação. Os preços por 1M de tokens são atuais e mudam junto com nossas tarifas; a coluna OpenRouter mostra preços de referência para a mesma carga de trabalho.
Veja o artigo sobre o DeepSeek-V4.1-Flash-1017 para saber o que mudou no próprio modelo.
Conclusão#
O DeepInfer é um lançamento aberto real de código de inferência de produção, mas apenas offline e vinculado a hardware específico (NVIDIA SM100 ou Ascend 950). Equipes com esse hardware e uma equipe de serving vão achá-lo interessante. A maioria dos desenvolvedores continuará chamando uma API e comparando custos para o próprio mix de tokens.


