Berita AIAnalisis
DeepSeek open-source DeepInfer: apa itu dan siapa yang sebaiknya self-host
DeepSeek merilis DeepInfer di bawah Apache-2.0: kode inferensi untuk V4.1-Flash. Apa yang termasuk, perangkat keras apa yang dibutuhkan, dan kapan API menjadi pilihan yang lebih sederhana.
Di halaman ini
Pada 20 Oktober 2026 DeepSeek menerbitkan DeepInfer di GitHub (deepseek-) di bawah Apache License 2.0. Ini adalah framework inferensi untuk model DeepSeek. Menurut README, framework ini menjalankan layanan produksi skala besar DeepSeek. Tanggal rilis berasal dari postingan @deepseek_ai yang diteruskan oleh ringkasan Telegram; README itu sendiri tidak mencantumkan tanggal.
Apa itu DeepInfer#
DeepInfer adalah kode yang menjalankan model di GPU atau NPU dengan cepat. Ini bukan model dan bukan layanan terkelola. Satu-satunya model yang didukung adalah DeepSeek-V4.1-Flash. Secara default, saat pertama kali dijalankan, ia mengunduh checkpoint deepseek- ke cache Hugging Face. Jika Anda sudah memiliki bobotnya, setel DEEPINFER_ untuk menggunakan salinan lokal.
Apa yang tersedia#
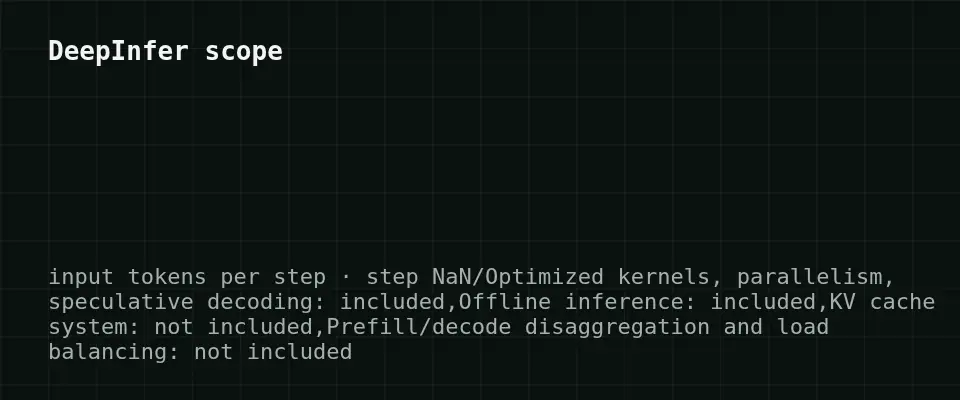
README mencantumkan fitur-fitur berikut:
- kernel yang dioptimalkan;
- paralelisme data, konteks dan expert dengan load balancing;
- speculative decoding dengan verifikasi berbasis keyakinan;
- replay sliding-window terbatas untuk prefill;
- penjadwalan asinkron;
- inferensi batch-invariant dan sampling deterministik;
- output terstruktur: regex, skema JSON dan grammar.
Beberapa fitur ini hanya tersedia untuk NVIDIA.
Apa yang tidak termasuk#
Rilis ini hanya menyediakan inferensi offline. README menyatakan bahwa layanan inferensi lengkap juga memerlukan sistem KV cache, disagregasi prefill/decode dan load balancing, dan semuanya tidak termasuk dalam rilis ini. Jadi Anda mendapatkan mesinnya, bukan seluruh stack produksi. Menempatkannya di belakang API untuk pengguna adalah pekerjaan yang harus Anda lakukan sendiri.
Perangkat keras dan penyiapan#
Gulir tabel ke kanan →
| Kebutuhan | Detail |
|---|---|
| Akselerator | GPU NVIDIA SM100 atau NPU Huawei Ascend 950 |
| OS | Linux |
| Kompiler | GCC 13+ |
| Python | 3.12 |
| Runtime | CUDA 13 (NVIDIA) atau CANN 9.2 (Ascend) |
Benchmark yang diterbitkan (grafik Pareto prefill dan decode) diukur pada 4 GPU SM100 untuk prefill dan 64 untuk decode, masing-masing dalam satu domain scale-up. Grafiknya berupa gambar, jadi kami tidak mengutip angka throughput atau latensi. Kami juga tidak memiliki data apakah DeepInfer mengubah harga API siapa pun, jadi kami tidak membuat klaim semacam itu.
Haruskah Anda menjalankannya sendiri?#
Self-hosting masuk akal jika Anda sudah mengoperasikan perangkat keras SM100 atau Ascend 950, membutuhkan kendali penuh atas bobot dan perilaku deterministik atau batch-invariant, atau ingin membangun lapisan serving Anda sendiri. Penyiapan benchmark (puluhan GPU untuk decode) menunjukkan untuk apa framework ini disetel: serving skala besar.
Jika Anda hanya membutuhkan output keluarga DeepSeek di aplikasi Anda, framework ini adalah infrastruktur yang terlalu besar untuk diadopsi. Memanggil API lebih sederhana: tanpa GPU, tanpa versi CUDA atau CANN yang harus dicocokkan.
Opsi API untuk jenis tugas yang sama#
Jika Anda lebih memilih tidak menjalankan klaster GPU sendiri, MiniMax-M2.7 di CheapTokens menangani tugas chat, coding dan agent melalui API, dengan:
- satu saldo untuk semua model dan API yang kompatibel dengan OpenAI dan Anthropic;
- hingga 8.192 token output per jawaban dan konteks 180K;
- harga tetap per model tanpa jam sibuk;
- lebih murah daripada OpenRouter secara total, dengan input dan output dihitung bersama.
Harga saat ini per 1 juta token: input $0.05, output $0.15. Contoh beban kerja 2.000 token input dan 500 token output per permintaan, 1.000 permintaan:
| Model | Input $/1Jt | Output $/1Jt | Per permintaan | 1.000 permintaan | OpenRouter, 1.000 permintaan |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00006 | $0.06 | $0.121 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00008 | $0.08 | $0.173 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00018 | $0.175 | $1.20 |
2.000 token input dan 500 token output per permintaan. Harga per 1 juta token adalah harga saat ini dan berubah seiring tarif kami; kolom OpenRouter menunjukkan harga referensi untuk beban kerja yang sama.
Lihat artikel DeepSeek-V4.1-Flash-1017 untuk mengetahui apa yang berubah pada model itu sendiri.
Kesimpulan#
DeepInfer adalah rilis open source nyata dari kode inferensi produksi, tetapi hanya untuk offline dan terikat pada perangkat keras tertentu (NVIDIA SM100 atau Ascend 950). Tim yang memiliki perangkat keras tersebut dan tim serving akan menemukannya menarik. Sebagian besar developer akan tetap memanggil API dan membandingkan biaya untuk campuran token mereka sendiri.


