Новости AIРазбор
DeepSeek открыла DeepInfer: что это и кому запускать у себя
DeepSeek выложила DeepInfer под Apache-2.0 — код инференса для V4.1-Flash. Что входит, какое нужно железо и когда проще взять API.
Содержание
20 октября 2026 года DeepSeek опубликовала на GitHub DeepInfer (deepseek-) под лицензией Apache 2.0. Это фреймворк инференса для моделей DeepSeek. По README, он обслуживает крупномасштабные производственные сервисы DeepSeek. Дата релиза взята из поста @deepseek_ai в пересказе Telegram-канала; в самом README даты нет.
Что такое DeepInfer#
DeepInfer — код, который быстро запускает модель на GPU или NPU. Это не модель и не облачный сервис. Поддерживается одна модель — DeepSeek-V4.1-Flash. По умолчанию при первом запуске чекпойнт deepseek- скачивается в кэш Hugging Face. Если веса уже есть, укажите их через DEEPINFER_.
Что внутри#
Согласно README:
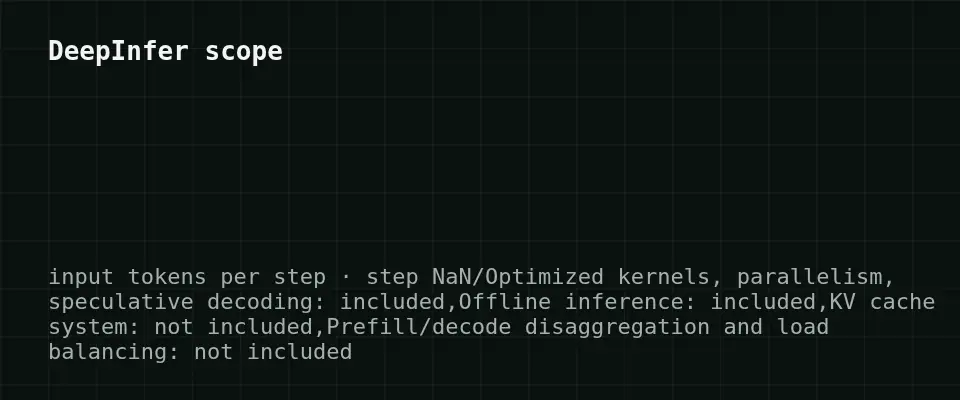
- оптимизированные ядра;
- параллелизм по данным, контексту и экспертам с балансировкой нагрузки;
- спекулятивное декодирование с проверкой по уверенности;
- ограниченный replay скользящего окна для prefill;
- асинхронное планирование;
- batch-invariant инференс и детерминированное сэмплирование;
- структурированный вывод: regex, JSON schema и грамматика.
Несколько возможностей работают только на NVIDIA.
Чего нет#
В этом релизе только офлайн-инференс. По README, для полноценного сервиса нужны ещё система KV-кэша, разделение prefill/decode и балансировка нагрузки — в релиз они не входят. То есть вы получаете движок, а не весь производственный стек. Сделать из него API для пользователей придётся самим.
Железо и запуск#
Прокрутите таблицу вправо →
| Требование | Детали |
|---|---|
| Ускорители | GPU NVIDIA SM100 или NPU Huawei Ascend 950 |
| ОС | Linux |
| Компилятор | GCC 13+ |
| Python | 3.12 |
| Среда | CUDA 13 (NVIDIA) или CANN 9.2 (Ascend) |
Публикуемые бенчмарки (кривые Парето для prefill и decode) измерены на 4 GPU SM100 для prefill и 64 для decode, в пределах одного scale-up домена. Графики — картинки, поэтому цифры пропускной способности и задержки мы не приводим. Данных о том, снизит ли DeepInfer чью-то цену API, у нас нет, и мы этого не утверждаем.
Стоит ли запускать самим?#
Свой хостинг имеет смысл, если у вас уже есть SM100 или Ascend 950, нужен полный контроль над весами и детерминированное поведение, или вы строите собственный слой обслуживания. Конфигурация бенчмарка (десятки GPU на decode) показывает, под что настроен фреймворк: крупномасштабное обслуживание.
Если вам просто нужен ответ моделей семейства DeepSeek в приложении, это много инфраструктуры. Вызов API проще: без GPU и без подбора версий CUDA или CANN.
Вариант через API для похожих задач#
Если не хочется поднимать собственный кластер GPU, MiniMax-M2.7 в CheapTokens закрывает чат, код и агентные задачи по API и даёт:
- один баланс на все модели и API, совместимый с OpenAI и Anthropic;
- до 8192 токенов в ответе и контекст 180K;
- фиксированную цену модели без пиковых часов;
- в сумме, с учётом входа и выхода, дешевле OpenRouter.
Текущие цены за 1M токенов: вход $0.05, выход $0.15. Пример нагрузки: 2000 входных и 500 выходных токенов на запрос, 1000 запросов:
| Модель | Вход $/1M | Выход $/1M | За запрос | 1 000 запросов | OpenRouter, 1 000 запросов |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00006 | $0.06 | $0.121 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00008 | $0.08 | $0.173 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00018 | $0.175 | $1.20 |
2 000 входных и 500 выходных токенов на запрос. Цены за 1M токенов актуальны и меняются вместе с нашими тарифами; столбец OpenRouter показывает справочные цены для той же нагрузки.
Что изменилось в самой модели — в статье про DeepSeek-V4.1-Flash-1017.
Итог#
DeepInfer — настоящий открытый релиз производственного кода инференса, но только офлайн и под конкретное железо (SM100 или Ascend 950). Командам с таким железом и своими инженерами по сервингу он интересен. Большинству разработчиков проще оставаться на API и сравнивать стоимость под свой объём токенов.


