AI dla początkującychPrzewodnik
Jak wybrać model AI: kontekst, wyjście, szybkość, cena
Wybierz model do czatu, kodowania lub agenta za pomocą czterech liczb: okno kontekstu, maksymalne wyjście, szybkość i cena. Przykłady i aktywna tabela kosztów.
Na tej stronie
Lista modeli z czterdziestoma nazwami, zadanie opisane jednym zdaniem i brak oczywistego związku między nimi. Oto krótka odpowiedź: sprawdź cztery liczby, w tej kolejności. Okno kontekstu i maksymalne wyjście decydują, czy model w ogóle poradzi sobie z twoim zadaniem. Szybkość i cena decydują, jak przyjemnie i jak drogo to będzie. Kontekst, limit wyjścia i cena są podane na stronie modeli oraz w tabeli cen; szybkość sprawdzasz sam w około minutę, a skrypt znajdziesz poniżej.
Cztery liczby prostymi słowami#
Wyobraź sobie model jako kolegę przy biurku. Okno kontekstu to rozmiar biurka: wszystko, co musi leżeć przed nim naraz. Maksymalne wyjście to, jak długo potrafi mówić jednym ciągiem. Szybkość to, jak szybko zaczyna odpowiadać. Cena to jego stawka godzinowa. Cztery pojęcia, które spotkasz w każdej dokumentacji API:
Fiszki
Słowa, które spotkasz w każdej liście modeli
Dotknij kartę, aby ją odwrócić
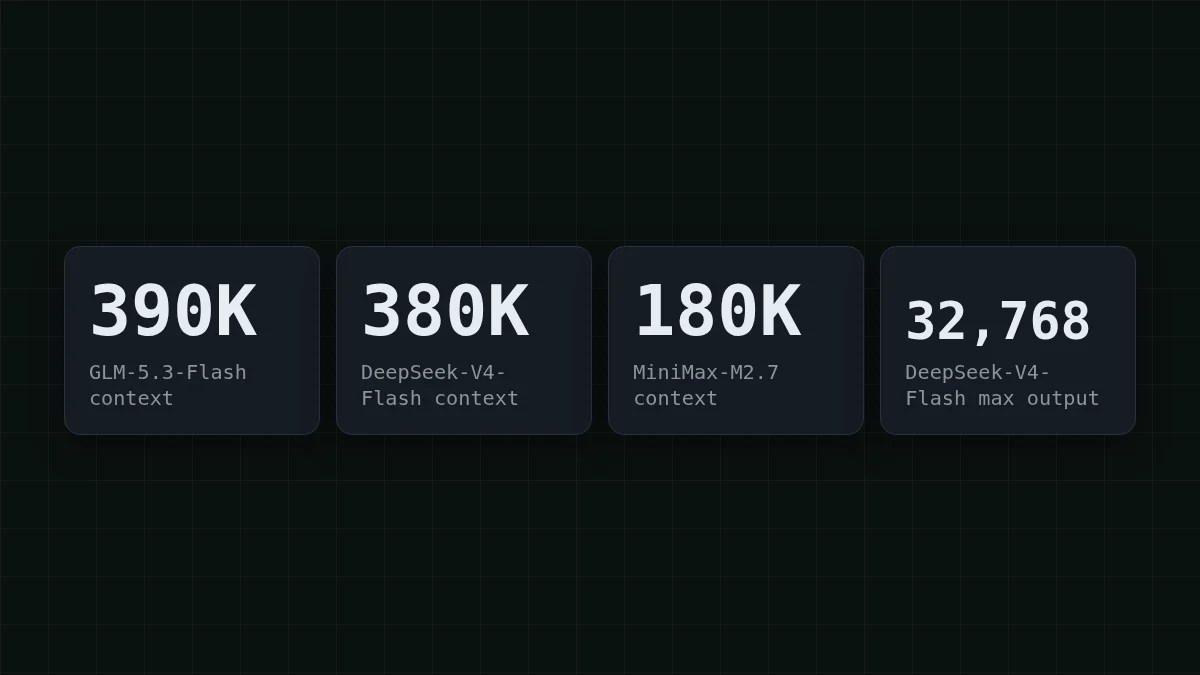
Aby to skonkretyzować, oto dwie pierwsze liczby dla trzech modeli z katalogu CheapTokens, z dokumentacji modeli CheapTokens (27 października 2026): GLM-5.3-Flash ma kontekst 390K i odpowiada do 8 192 tokenów; DeepSeek-V4-Flash (wydanie 0731) ma 380K i odpowiada do 32 768 tokenów; MiniMax-M2.7 ma 180K i odpowiada do 8 192 tokenów.
Kontekst: czy wszystko, co wysyłasz, się zmieści?#
Załóżmy, że twój asystent do kodowania otwiera 12 plików po około 3 000 tokenów każdy, a potem dodaje twoje pytanie i własne notatki. 12 × 3 000 = 36 000 tokenów. Nawet najmniejsze okno powyżej, 180K, mieści to z dużym zapasem. Pojedynczy ogromny plik albo zrzut całego repozytorium to moment, w którym okno zaczyna mieć znaczenie.
Czaty i agenci są trudniejsi, bo API wysyła ponownie całą historię przy każdym wywołaniu. Weź agenta, który wykonuje 20 kroków, a każdy krok dodaje około 2 000 tokenów wyjścia narzędzia i odpowiedzi (założenie dla tego przykładu). Krok 1 wysyła 2 000 tokenów, krok 2 wysyła 4 000, krok 20 wysyła 40 000. Przez cały przebieg wysyła 2 000 × 210 = 420 000 tokenów, gdzie 210 to 1 + 2 + … + 20.
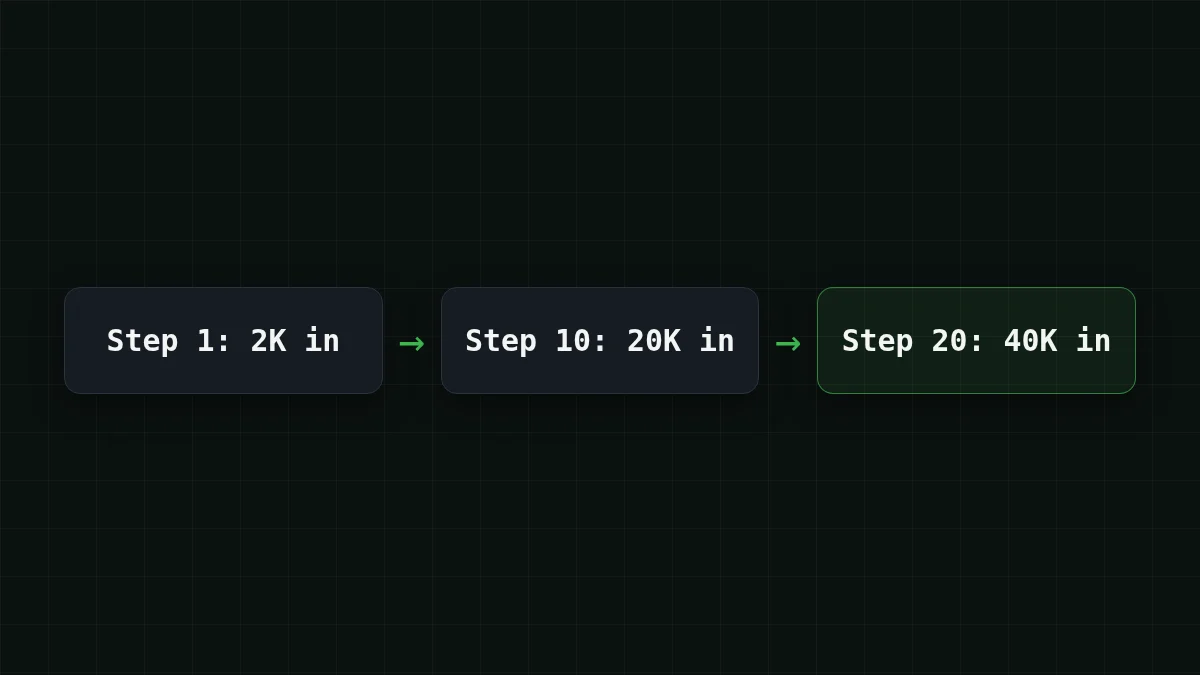
Kryją się tu dwa różne pytania. Okno kontekstu interesuje tylko największe pojedyncze żądanie: 40 000 tokenów w kroku 20, co każdy model w katalogu mieści bez trudu. Rachunek interesuje suma, 420 000 tokenów. Trzymaj oba w głowie, a nie wybierzesz modelu z niewłaściwego powodu.
Długość wyjścia: limit, który ucina odpowiedzi#
Limit wyjścia to pułap jednej odpowiedzi i łatwo o nim zapomnieć, dopóki odpowiedź nie urwie się w połowie zdania. Praktyczna zasada dla angielskiego: jeden token to około trzech czwartych słowa. Prosisz o raport na 6000 słów: 6000 / 0,75 = 8000 tokenów. To ledwo mieści się pod 8 192. Poproś o 7 000 słów, a tekst skończy się w środku akapitu.
Przy pułapie 32 768 tokenów ta sama arytmetyka daje 24576 słów w jednej odpowiedzi (32768 × 0,75 = 24576), więc generowany kod, długie raporty i szkice całych rozdziałów mieszczą się w jednej wypowiedzi. Gdy odpowiedź rzeczywiście zostanie ucięta, API ci to powie: finish_reason wraca jako length (dlaczego tak się dzieje i jak to naprawić).
Szybkie sprawdzenie
Prosisz model z limitem wyjścia 8 192 tokenów o raport na 12 000 słów. Co dostajesz?
Pokaż odpowiedź
Odpowiedź: Raport, który urywa się w połowie, z finish_reason ustawionym na length
12 000 słów to około 16 000 tokenów, dwa razy więcej niż pułap. Model pisze, aż uderzy w sufit, i zatrzymuje się, a API oznacza odpowiedź jako finish_.
Szybkość: jedyna liczba, którą mierzysz sam#
Szybkość to tak naprawdę dwie liczby: ile czasu mija do pojawienia się pierwszego tekstu i jak szybko napływa reszta. Obie zmieniają się wraz z obciążeniem, długością promptu i porą dnia, więc wartość skopiowana z tabeli to słaby przewodnik. Zmierz ją na własnym promptcie. To zajmuje minutę i zużywa kilka tokenów (klucz pochodzi ze zmiennej środowiskowej; jak go utworzyć, patrz dokumentacja):
import os, time
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)

start = time.perf_counter()
first = None
stream = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4-Flash-0731",
    messages=[{"role": "user", "content": "Explain what a token is in 3 sentences."}],
    stream=True,
)
for chunk in stream:
    if first is None and chunk.choices and chunk.choices[0].delta.content:
        first = time.perf_counter() - start
total = time.perf_counter() - start
print(f"first text after {first:.1f}s, finished after {total:.1f}s")
Dostajesz jedną linię: first text after <N>s, finished after <M>s. Podmień identyfikator modelu na zai- lub MiniMaxAI/, uruchom każdy kilka razy i masz porównanie szybkości dla swojego promptu. Czy to ma znaczenie? W czacie na żywo tak: ludzie zauważają pauzę przed pierwszym słowem. W nocnej partii podsumowań nikt nie patrzy, a szybkość spada na sam dół listy.
Cena: dodaj wejście i wyjście razem#
Ceny podaje się za milion tokenów, ale płacisz za żądanie, a żądanie ma zarówno stronę wejściową, jak i wyjściową. Porównuj więc modele na obciążeniu, a nie na dwóch kolumnach. Załóżmy, że twój bot wsparcia obsługuje 1 000 zgłoszeń dziennie, każde około 300 tokenów na wejściu i 150 na wyjściu (założenie; zastąp je własnym). Tabela jest aktywna i przelicza się na podstawie aktualnych cen:
| Model | Wejście $/1M | Wyjście $/1M | Za żądanie | 1000 żądań | OpenRouter, 1000 żądań |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000012 | $0.012 | $0.0238 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00002 | $0.0195 | $0.0378 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000038 | $0.0375 | $0.27 |
300 tokenów wejściowych i 150 tokenów wyjściowych na żądanie. Ceny za 1 mln tokenów są aktualne i zmieniają się wraz z naszymi taryfami; kolumna OpenRouter pokazuje ceny referencyjne dla tego samego obciążenia.
Czytaj sumę, nie kolumny. W sumie, licząc wejście i wyjście razem, każdy z trzech wypada taniej niż cena referencyjna OpenRouter w kolumnie OpenRouter tej tabeli.
I tu agenci dają się we znaki. 20-krokowy przebieg z sekcji o kontekście wysyła 420 000 tokenów na wejściu i zapisuje może 4 000 na wyjściu (200 na krok, znów założenie). Na DeepSeek-V4-Flash jeden taki przebieg kosztuje $0.0067. Pięć przebiegów dziennie? Przesuń suwaki i obserwuj trzy modele:
Kalkulator kosztów
Dzień pracy agenta: pięć 20-krokowych zadań
Tokeny wejściowe na żądanie: 21 000 · Tokeny wyjściowe na żądanie: 200 · Żądania dziennie: 100
| Model | Dziennie | Miesięcznie |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0428 | $1.28 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0335 | $1.01 |
| MiniMax-M2.7$0.05$0.15 | $0.108 | $3.24 |
Ceny modeli pozostają takie same o każdej porze dnia, więc obliczenia zrobione teraz obowiązują też dla nocnej partii. A jeśli chcesz przypomnieć sobie, dlaczego tokeny wyjściowe zwykle kosztują więcej niż wejściowe, zobacz tokeny wejściowe i wyjściowe.
Wybierz model według zadania#
Zacznij od zadania, znajdź liczbę, która gryzie najmocniej, i sprawdź pozostałe trzy. Kliknij przez własny przypadek:
Wybierz swój przypadek
Który model do mojego zadania?
Wybierz opcję, aby zobaczyć odpowiedź
Bot wsparcia z krótkimi odpowiedziami
Pytania i odpowiedzi są krótkie, więc każdy model w katalogu ma zapas, a decyduje kolumna ceny. Przepuść typowe zgłoszenie przez tabelę kosztów powyżej i zacznij od GLM-5.3-Flash lub MiniMax-M2.7, w zależności od tego, która suma wygląda lepiej dla twoich liczb.
Asystent do kodowania, który czyta wiele plików
Kontekst jest najważniejszy. GLM-5.3-Flash ma największe okno z trzech, 390K, DeepSeek-V4-Flash ma 380K. MiniMax-M2.7 z 180K wystarczy, gdy pliki wysyłane razem mieszczą się znacznie poniżej tej wartości.
Agent, który zapętla się przez wiele kroków
Historia jest wysyłana ponownie przy każdym kroku, więc suma rośnie szybko. DeepSeek-V4-Flash łączy kontekst 380K z maksymalnie 32 768 tokenami wyjścia na odpowiedź i jedną ceną o każdej porze, co czyni długie pętle przewidywalnymi. Sprawdź sumę kalkulatorem powyżej.
Długie raporty i generowany kod
Decyduje maksymalne wyjście. DeepSeek-V4-Flash pisze do 32 768 tokenów na odpowiedź; GLM-5.3-Flash i MiniMax-M2.7 piszą do 8 192, co pokrywa raport na około 6 000 słów.
Żaden pojedynczy model nie wygrywa w każdym wierszu, dlatego warto przepuścić te same dziesięć prawdziwych promptów przez dwóch kandydatów, zanim się zdecydujesz. Porównanie GLM vs DeepSeek vs MiniMax wchodzi głębiej w te trzy modele, a strona z cenami zawsze pokazuje aktualne liczby.


